KH_ORACLE_12_시퀀스, 인덱스
ORACLE
시퀀스
시퀀스의 개념 이해와 시퀀스 생성
- 오라클에서는 행을 구분하기 위해서 기본 키를 두고 있다. 기본 키는 중복된 값을 가질 수 없으므로 항상 유일한 값을 가져야 한다.
- 기본 키가 유일한 값을 갖도록 사용자가 직접 값을 생성해 내려면 부담이 클 것이다.
- 시퀀스는 테이블 내의 유일한 숫자를 자동으로 생성하는 자동 번호 발생기이므로 시퀀스를 기본 키로 사용하게 되면 사용자의 부담을 줄일 수 있다.
-- 형식
CREATE SEQUENCE sequence_name
 	[START WITH n] ①
 	[INCREMENT BY n] ②
 	[{MAXVALUE n | NOMAXVALUE}] ③
 	[{MINVALUE n | NOMINVALUE}] ④
 	[{CYCLE | NOCYCLE}] ⑤
	[{CACHE n | NOCACHE}] ⑥
-- 예
CREATE SEQUENCE DEPT_DEPTNO_SEQ
INCREMENT BY 10
START WITH 10;
① START WITH : 시퀀스 번호의 시작값을 지정할 때 사용된다. 만일 1부터 시작되는 시퀀스를 생성하려면 START WITH 1이라고 기술하면 된다.
② INCREMENT BY : 연속적인 시퀀스 번호의 증가치를 지정할 때 사용된다. 만일 1씩 증가하는 시퀀스를 생성하려면 INCREMENT BY 1이라고 기술하면 된다.
③ MAXVALUE n | NOMAXVALUE : MAXVALUE 은 시퀀스가 가질 수 있는 최대값을 지정한다. 만일 NOMAXVALUE를 지정하게 되면 ASCENDING 순서일 경우에는 1027승이고 DESCENDING 순서일 경 우에는 -1로 설정된다.
④ MINVALUE n | NOMINVALUE : MINVALUE 은 시퀀스가 가질수 있는 최소값을 지정한다. 만일 NOMINVALUE을 지정하게 되면 ASCENDING 순서일 경우에는 1이고 DESCENDING 순서일 경우에 는 1026승으로 설정된다.
⑤ CYCLE | NOCYCLE : CYCLE 은 지정된 시퀀스 값이 최대값까지 증가가 완료되게 되면 다시 START WITH 옵션에 지정한 시작 값에서 다시 시퀀스를 시작하도록 한다. NOCYCLE은 증가가 완료되게 되면 에러를 유발시킨다.
⑥ CACHE n | NOCACHE : CACHE 은 메모리상의 시퀀스 값을 관리하도록 하는 것인데 기본 값은 20이다. NOCACHE는 원칙적으로 메모리 상에서 시퀀스를 관리하지 않는다.
시퀀스 관련 데이터 딕셔너리
생성된 시퀀스 객체에 대한 정보를 저장하는 데이터 딕셔너리는 USER_SEQUENCES 이다.
DESC USER_SEQUENCES
SELECT SEQUENCE_NAME, MIN_VALUE, MAX_VALUE,
INCREMENT_BY, CYCLE_FLAG
FROM USER_SEQUENCES;
시퀀스 값을 알아보는 CURRVAL과 NEXTVAL
시퀀스의 현재 값을 알아내기 위해서 CURRVAL을 사용하고, 다음 값을 알아내기 위해서는 NEXTVAL을 사용한다.
SELECT DEPT_DEPTNO_SEQ.NEXTVAL FROM DUAL;
SELECT DEPT_DEPTNO_SEQ.CURRVAL FROM DUAL;
시퀀스 실무에 적용하기
시퀀스는 99.9%가 INSERT 연산과 같이 사용되어 컬럼 값을 자동으로 발생시키는 용도로 사용된다.
아래 예시는 사원 테이블을 생성하면서 사원 번호를 기본 키로 설정하였다.
기본 키는 반드시 유일한 값을 가져야 한다. 사용자가 새로운 사원을 추가할 때마다 유일한 사원번호를 INSERT 해야 하는 번거로움이 있다.
사원 번호를 생성하는 시퀀스 객체를 사용하여 사원 번호가 자동 생성되도록 한다면 이러한 번거로움을 덜어줄 수 있다.
-- 예: 시퀀스를 테이블의 기본 키에 접목하기
CREATE SEQUENCE EMP_SEQ
START WITH 1
INCREMENT BY 1
MAXVALUE 100000 ;

DROP TABLE EMP01;

CREATE TABLE EMP01(
EMPNO NUMBER(4) PRIMARY KEY,
ENAME VARCHAR(10),
HIREDATE DATE
);

INSERT INTO EMP01
VALUES(EMP_SEQ.NEXTVAL, 'JULIA' , SYSDATE);

SELECT * FROM EMP01;
시퀀스 제거와 수정
시퀀스를 삭제하는 방법
생성되어 있는 시퀀스를 제거하려면 DROP SEQUENCE 문을 사용해야 한다.
SELECT SEQUENCE_NAME, MAX_VALUE, INCREMENT_BY, CYCLE_FLAG
FROM USER_SEQUENCES;
DROP SEQUENCE DEPT_DEPTNO_SEQ;
시퀀스를 수정하는 방법
- 시퀀스를 변경하려면 ALTER SEQUENCE 문을 사용해야 한다.
- ALTER SEQUENCE는 START WITH 절이 없다는 점을 빼고는 CREATE SEQUENCE와 구조가 동일하다.
- START WITH 옵션은 ALTER SEQUENCE를 써서 변경할 수 없다.
- 다른 번호에서 다시 시작하려면 이전 시퀀스를 삭제하고 다시 생성해야 한다.
-- 형식
ALTER SEQUENCE sequence_name
	[INCREMENT BY n]
	[{MAXVALUE n | NOMAXVALUE}]
	[{MINVALUE n | NOMINVALUE}]
	[{CYCLE | NOCYCLE}]
	[{CACHE n | NOCACHE}]
-- 예 : 시퀀스 최대값을 변경하기
DROP SEQUENCE DEPT_DEPTNO_SEQ;

CREATE SEQUENCE DEPT_DEPTNO_SEQ
START WITH 10
INCREMENT BY 10
MAXVALUE 30; -- 10부터 10씩 증가하면서 최대 30까지의 값을 갖는 시퀀스를 생성한다.

SELECT DEPT_DEPTNO_SEQ.NEXTVAL FROM DUAL;
SELECT DEPT_DEPTNO_SEQ.NEXTVAL FROM DUAL;
SELECT DEPT_DEPTNO_SEQ.NEXTVAL FROM DUAL;
SELECT DEPT_DEPTNO_SEQ.NEXTVAL FROM DUAL; -- 부서 번호를 계속 생성하다 보면 최대값을 넘게 된다.

ALTER SEQUENCE DEPT_DEPTNO_SEQ
MAXVALUE 100; -- 최대값을 넘을 때까지 시퀀스를 생성한다.

SELECT SEQUENCE_NAME, MAX_VALUE, INCREMENT_BY, CYCLE_FLAG
FROM USER_SEQUENCES; -- USER_SEQUENCES 를 조회하면 시퀀스가 수정되었는지 확인할 수 있다.
인덱스
인덱스의 개요
인덱스란 SQL 명령문의 처리 속도를 향상시키기 위해서 컬럼에 대해서 생성하는 오라클 객체이다.
인덱스의 장점
- 검색 속도가 빨라진다.
- 시스템에 부하를 줄여서 시스템의 전체 성능을 향상시킨다.
인덱스의 단점
- 인덱스를 위한 추가 공간이 필요하다.
- 인덱스를 생성하는 데 시간이 걸린다.
- 데이터의 변경 작업이 자주 일어날 때는 오히려 성능이 저하된다.
인덱스 정보 조회
USER_COLUMNS와 USER_IND_COLUMNS 데이터 딕셔너리 뷰를 살펴보아야 한다.
인덱스는 기본 키나 유일 키와 같은 제약 조건을 지정하면 따로 생성하지 않더라도 자동으로 생성된다.
COLUMN TABLE_NAME FORMAT A15
COLUMN COLUMN_NAME FORMAT A15 -- 컬럼의 출력 형식 조정하기
SELECT INDEX_NAME, TABLE_NAME , COLUMN_NAME
FROM USER_IND_COLUMNS
WHERE TABLE_NAME IN('EMP', 'DEPT');
조회 속도 비교하기
- 인덱스가 조회 속도를 빠르게 해 준다는 것을 증명하기 위해서 기본 키나 유일 키로 지정하 지 않는 컬럼인 사원 이름으로 검색해 본다. 아마도 시간이 어느 정도 소요될 것이다.
- 검색을 위해서 WHERE 절에 사용되는 컬럼인 사원 이름 컬럼을 인덱스로 생성한 후에 다시 한 번 사원 이름으로 검색해보면 검색시간이 현저하게 줄어드는 것을 확인할 수 있다.
인덱스 생성 및 제거하기
제약 조건에 의해 자동으로 생성되는 인덱스 외에 CREATE INDEX 명령어로 직접 인덱스를 생성할 수도 있다.
-- 형식
CREATE INDEX index_name
ON table_name (column_name);
DROP INDEX index_name;
인덱스를 사용해야 하는 경우 판단하기
| 인덱스를 사용해야 하는 경우 | 인덱스를 사용하지 말아야 하는 경우 |
|---|---|
| 테이블에 행의 수가 많을 때 | 테이블에 행의 수가 적을 때 |
| WHERE 문에 해당 컬럼이 많이 사용될 때 | WHERE 문에 해당 컬럼이 자주 사용되지 않을 때 |
| 검색 결과가 전체 데이터의 2~4%일 때 | 검색 결과가 전체 데이터의 10~15%이상일 때 |
| JOIN에 자주 사용되는 컬럼이나 NULL을 포함하는 컬럼이 많은 경우 | 테이블에 DML 작업이 많은 경우 즉, 입력 수정 삭제 등이 자주 일어날 때 |
다음과 같은 조건에서 사원 테이블의 부서번호에 인덱스는 거는 것이 좋을까?
- 테이블에 전체 행의 수는 10000건이다.
- 위의 쿼리문을 전체 쿼리문들 중에서 95% 사용된다.
- 쿼리문의 결과로 구해지는 행은 10건 정도이다.
조건을 위 표로 비추어보고 판단해 보면 부서번호 컬럼을 인덱스로 사용하기에 알맞다는 결론이 난다.
인덱스의 물리적인 구조와 재생성
B-트리 인덱스 구조
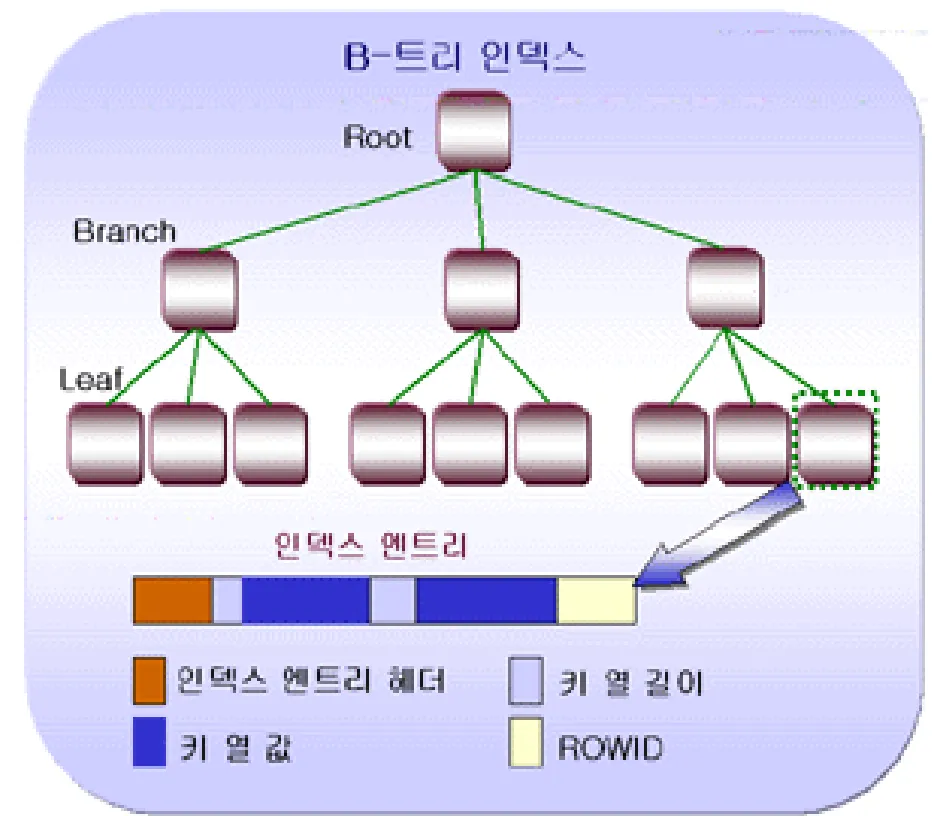
오라클에서의 인덱스 내부 구조는 B-트리 형식으로 구성되어 있다.
루트를 근거로 아래로 나무뿌리 들이 뻗어 있는 모양을 하고 있다.
B-트리 인덱스의 추가, 삭제
DML 작업 특히 DELETE 명령을 수행한 경우에는 해당 인덱스 엔트리가 논리적으로만 제거되고 실제 인덱스 엔트리는 그냥 남아 있게 된다.
인덱스에 제거된 엔트리가 많아질 경우에는 제거된 인덱스들이 필요 없는 공간을 차지하고 있기 때문에 종종 인덱스를 재생성시켜야 한다.
인덱스의 종류 살피기
고유와 비고유 인덱스
고유 인덱스(유일 인덱스라고도 부름)는 기본키나 유일키처럼 유일한 값을 갖는 컬럼에 대해서 생성하는 인덱스이다.
반면 비고유 인덱스는 중복된 데이터를 갖는 컬럼에 대해서 인덱스를 생성하는 경우를 말한다.
고유 인덱스를 설정하려면 UNIQUE 옵션을 추가해서 인덱스를 생성해야 한다.
-- 형식
CREATE UNIQUE INDEX index_name
ON table_name (column_name);
고유 인덱스와 비고유 인덱스 정의해보자.
고유 인덱스와 고유 인덱스를 비교하기 위해서 중복된 데이터가 없는 컬럼과 있는 컬럼으로 구성된 부서 테이블을 만들어 보겠다.
DROP TABLE DEPT01;
CREATE TABLE DEPT01
AS
SELECT * FROM DEPT WHERE 1=0;
INSERT INTO DEPT01 VALUES(10, '인사과', '서울');
INSERT INTO DEPT01 VALUES(20, '총무과', '대전');
INSERT INTO DEPT01 VALUES(30, '교육팀', '대전');
SELECT * FROM DEPT01;
CREATE UNIQUE INDEX IDX_DEPT01_DEPTNO
ON DEPT01(DEPTNO);
CREATE UNIQUE INDEX IDX_DEPT01_LOC
ON DEPT01(LOC);
-- 중복된 데이터를 갖는 컬럼을 인텍스로 지정하면 오류가 발생한다.
CREATE INDEX IDX_DEPT01_LOC
ON DEPT01(LOC);
결합 인덱스 정의하기
두 개 이상의 컬럼으로 인덱스를 구성하는 것을 결합 인덱스라고 한다.
CREATE INDEX IDX_DEPT01_COM
ON DEPT01(DEPTNO, DNAME);

SELECT INDEX_NAME, COLUMN_NAME
FROM USER_IND_COLUMNS
WHERE TABLE_NAME = 'DEPT01';
함수 기반 인덱스 정의하기
1. 검색조건으로 WHERE SAL = 300이 아니라 WHERE SAL*12 = 3600와 같이 SELECT 문 WHERE 절에 산술 표현 또는 함수를 사용하는 경우가 있다.
2. 이 경우 만약 SAL 컬럼에 인덱스가 걸려 있다면 인덱스를 타서 빠르리라 생각 할 수도 있지 만 실상은 SAL 컬럼에 인덱스가 있어도 SAL*12는 인덱스를 타지 못한다.
3. 인덱스 걸린 컬럼이 수식으로 정의 되어 있거나 SUBSTR 등의 함수를 사용해서 변형이 일어난 경우는 인덱스를 타지 못하기 때문이다. 4. 이러한 수식으로 검색하는 경우가 많다면 아예 수식이나 함수를 적용하여 인덱스를 만들 수 있다.
SAL*12로 인덱스를 만들어 놓으면 SAL*12가 검색 조건으로 사용될 시 해당 인덱스를 타게 된다.
SET TIMING ON
-- 인덱스 이전 검색하기
SELECT * FROM EMP01
WHERE SAL*12 = 3600;

CREATE INDEX IDX_EMP01_ANNSAL
ON EMP01(SAL*12);

SELECT INDEX_NAME, COLUMN_NAME
FROM USER_IND_COLUMNS
WHERE TABLE_NAME = 'EMP01';

-- 인덱스 이후 검색하기
SELECT * FROM EMP01
WHERE SAL*12 = 3600;
댓글
댓글을 불러오는 중…