Index를 통한 쿼리 성능개선 - 8주차
항해99 플러스 백엔드
콘서트 예약 서비스에는 꽤 많은 쿼리가 수행된다.
이번 주차에는 성능 개선할 수 있는 쿼리들을 색출하고, 직접 인덱스를 걸어본 후 성능 비교와 부하테스트를 해 보자.
콘서트 예약 서비스의 조회 쿼리들에 대한 인덱스 필요성 조사
내가 구현한 콘서트 예약 서비스에서의 도메인들은 유저, 대기열, 콘서트 총 3개이다.
먼저, 유저 도메인에서의 조회 쿼리들은 전부 id(PK) 를 통한 조회이므로 인덱스가 필요 없다.
PK는 중복된 값을 가질 수 없으며, 칼럼 중에 가장 카디널리티가 높은 칼럼이다.

PK에는 이미 인덱스가 걸려 있다. Mysql같은 InnoDB는 PK에 클러스터드 인덱스를 사용한다.
PostgreSQL같은 경우는 InnoDB가 아니라서 논-클러스터드 인덱스를 사용한다.. 정렬을 보장하지 않음.
그리하여 유저는 인덱스를 통한 쿼리 성능개선 대상에서 제외했다.
또한, 대기열은 전부 레디스로 이관하였으므로, 대기열도 인덱스를 통한 쿼리 성능개선 대상에서 제외했다.
그렇다면 이제 콘서트 도메인에서 사용하는 조회 쿼리에 대한 인덱스 필요성을 조사해 보자.
1. 모든 콘서트 조회 - 성능개선 불가
모든 콘서트를 조회하는 쿼리의 경우 무조건 테이블 풀 스캔이 발생하므로, 인덱스를 사용할 필요가 없다.
2. 예약 가능한 콘서트 스케줄 조회 - 성능개선 대상
예약 가능한 콘서트 스케줄을 조회하는 경우, 아래와 같은 쿼리가 수행된다.

JPA 쿼리메서드로 사용하고 있어서 쿼리로 변환했다.
CONCERT_SCHEDULE 테이블을 대상으로 조회하지만, concert_id와 concert_date를 where 조건으로 조회하고 있다.
pk를 통한 조회가 이루어지지 않고 있어 인덱스 성능개선 대상이 될 것이라 판단된다.
3. 예약 가능한 콘서트 좌석 조회 - 성능개선 대상
예약 가능한 콘서트 좌석을 조회하는 경우, 아래와 같은 쿼리가 수행된다.

JPA 쿼리메서드로 사용하고 있어서 쿼리로 변환했다.
해당 쿼리의 경우에도, CONCERT_SEAT 테이블을 대상으로 조회하지만, concert_schedule_id와 status를 where 조건으로 조회하고 있으므로 인덱스 성능개선 대상이 될 것이라 판단된다.
4. 예약 유효시간 만료 대상 조회(스케줄러용) - 성능개선 대상

PK로 조회하고 있지 않고, 많은 양의 데이터를 상대로 조회하고 있어 인덱스를 사용할 필요가 있다.
5. 예약 유효시간 만료 대상의 좌석 조회(스케줄러용), 결제 시 예약 조회, 결제 시 좌석 조회 - 성능개선 불가
좌석id(PK)로 좌석을 조회하기 때문에 이미 인덱스를 잘 활용 중이다. 어떤 인덱스를 걸던 간에 MySQL8.0의 Query Optimizer로 인해 const Type(테이블의 레코드 건수에 관계없이 쿼리가 PK나 UK칼럼을 이용하는 WHERE조건절을 가지면서 반드시 1건을 반환하는 쿼리의 처리방식)으로 조회가 된다.
인덱스를 걸고 성능비교
성능비교를 해 보기 전, 충분히 많은 양의 데이터가 들어가 있어야 하고, 여러 종류의 데이터들이 들어가 있어야 한다.
(실제 서비스를 하고 있다 가정하에 들어올 수 있는 데이터들)
성능 비교를 위한 데이터 총 row 수
| CONCERT_SCHEDULE | CONCERT_SEAT | RESERVATION | |
|---|---|---|---|
| ROW 수 | 1000000건 | 1500000건 | 1000000건 |
1. 예약 가능한 콘서트 스케줄 조회

카디널리티 보기(클릭)
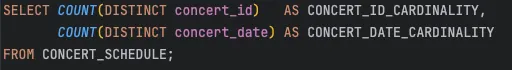
카디널리치 조회

Index 생성 전 EXPLAIN ANALYZE

수행 시간 267ms, Table Scan
Index 생성

인덱스 순서는 '=' 연산자에 들어가는 WHERE절 칼럼이 다른 연산자에 들어가는 WHERE절 쿼리보다 우선순위가 높다.
복합 인덱스로 생성한 이유는, concert_id는 데이터의 변경 가능성이 없고, concert_date는 카디널리티가 높기 때문이다.
Index 생성 후 EXPLAIN ANALYZE

수행시간 5.337ms, Covering Index range Scan
이로써, 수행시간이 269ms -> 5.337ms로 98.02%의 성능 개선이 이루어졌다.
그렇다면, 부하테스트를 걸어 API를 요청해 보자.
nGrinder TPS 비교(클릭)
Vuser : 40명
프로세스 수 : 2
쓰레드 수 : 10
테스트 시간 00:01:00
인덱스 적용 X
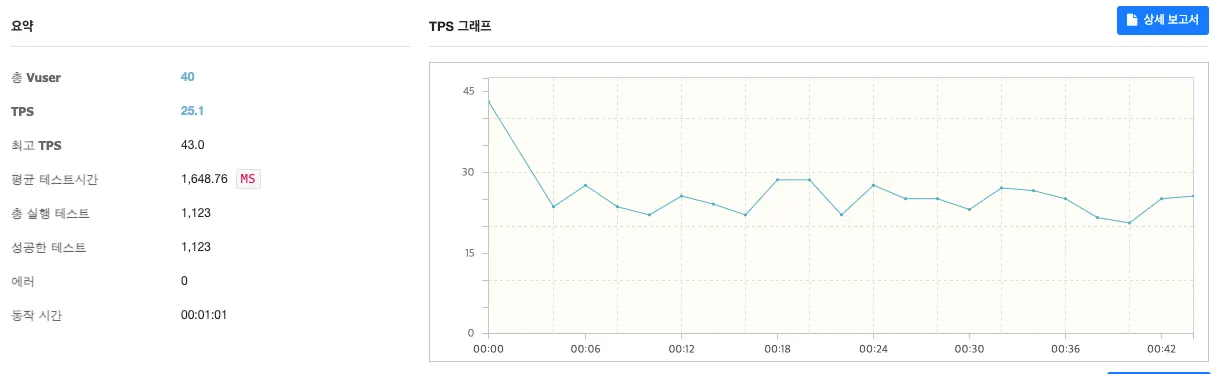
TPS 25.1
인덱스 적용 O
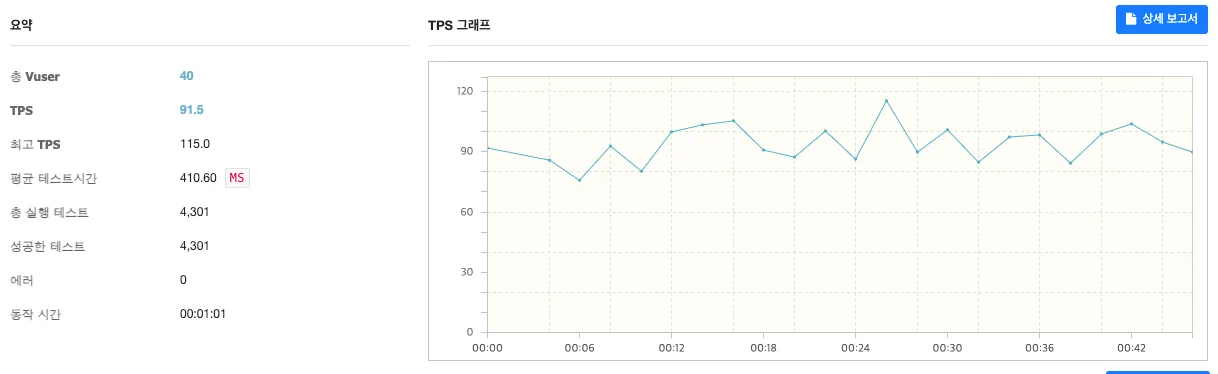
TPS 91.5
TPS는 25.1 -> 91.5로 3.65배가 증가했다!!!
2. 예약 가능한 콘서트 좌석 조회

카디널리티 보기(클릭)
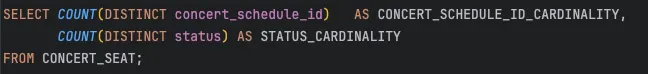
카디널리티 조회

Index 생성 전 EXPLAIN ANALYZE

수행시간 718ms, Table Scan
Index 생성

쿼리의 WHERE절의 조건칼럼이 2개인데도 단일 인덱스를 사용한 이유는 STATUS의 카디널리티가 너무 낮고, 변경이 자주 발생하는 칼럼이기 때문이다.
하지만 카디널리티가 낮다고 무조건 인덱스 대상칼럼에서 배제되는 것은 아니다.
데이터 분포에 따라 카디널리티가 낮음에도 효과가 좋을 수 있기 때문에 복합 인덱스도 고려대상에서 무작정 배제할 수는 없다.
(내 데이터셋에는 단일 인덱스가 효과가 더 좋았다.)
Index 생성 후 EXPLAIN ANALYZE

수행시간 1.71ms, Index lookup
이로써, 수행시간이 718ms -> 1.71ms로 99.76%의 성능 개선이 이루어졌다.
이 또한 부하테스트를 걸어 API를 요청해보자!
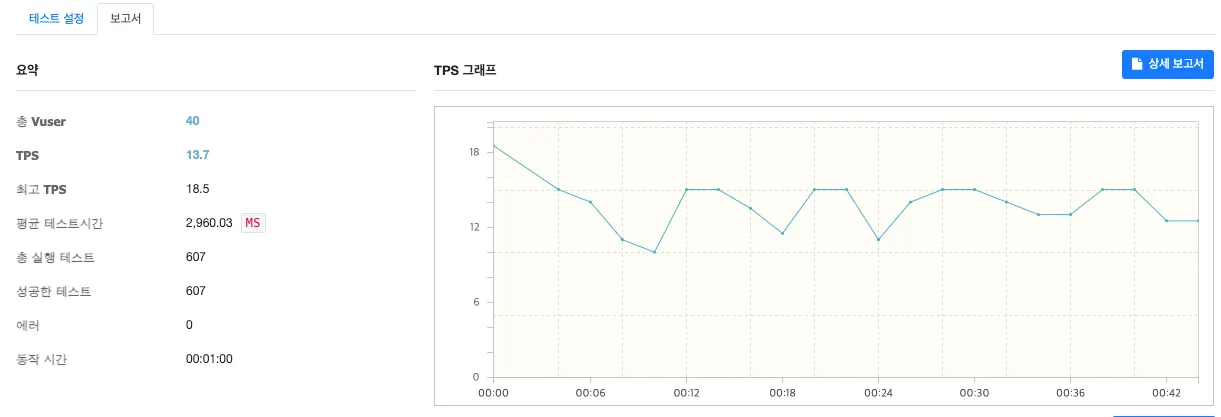
nGrinder TPS 비교(클릭)
Vuser : 40명
프로세스 수 : 2
쓰레드 수 : 10
테스트 시간 00:01:00
인덱스 적용 X
인덱스 적용 O
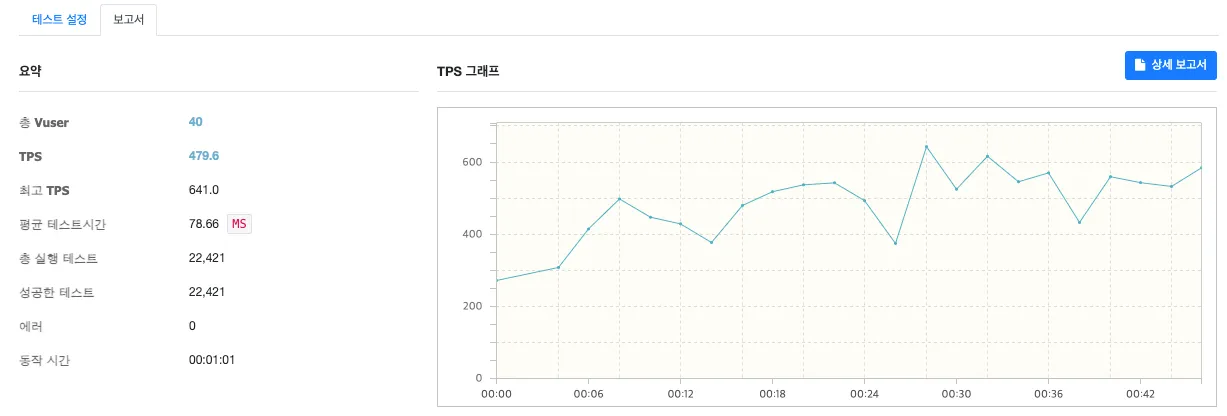
TPS는 13.7 -> 479.6으로 약 35배가 증가했다!!!
3. 예약 유효시간 만료 대상 조회(스케줄러)

카디널리티 보기(클릭)
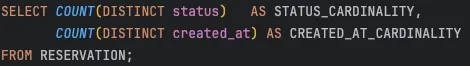
카디널리티 조회

Index 생성 전 EXPLAIN ANALYZE

수행시간 485ms, Table Scan
Index 생성
아래처럼 단일 인덱스로 생성을 했다.

이 또한 카디널리티가 낮다고 해서 무조건 status 칼럼이 인덱스 대상칼럼에서 배제되는 것은 아니다.
데이터 분포에 따라 카디널리티가 낮음에도 효과가 좋을 수 있기 때문에 복합 인덱스도 고려대상에서 무작정 배제할 수는 없다.
(내 데이터셋에는 단일 인덱스가 효과가 더 좋았다.)
Index 생성 후 EXPLAIN ANALYZE
-> Filter: (reservation.`status` = 'RESERVED')  (cost=2586 rows=1735) (actual time=6.63..35.1 rows=1718 loops=1)
    -> Index range scan on RESERVATION using idx_concert_reservation_status_created_at over
    (NULL < created_at < '2024-11-12 00:50:00.000000'),
    with index condition: (reservation.created_at < TIMESTAMP'2024-11-12 00:50:00')
    (cost=2586 rows=5206) (actual time=6.62..34.6 rows=5206 loops=1)
길이가 가로로 너무 길어, 텍스트로 옮겼다.
수행시간은 28.5ms, Index range Scan이 수행된 것을 볼 수 있다.
이로써, 수행시간이 485ms -> 28.5ms로 94.12%의 성능 개선이 이루어졌다.
결론 및 요약
| 총 데이터 수 | 조회 데이터 수 | 인덱싱 전/후 속도 | 인덱싱 전/후TPS | 인덱싱 방식 | |
|---|---|---|---|---|---|
| 예약 가능 스케줄 조회 | 100만 | 10016 | 269 / 5.337 | 25.1 / 91.5 | 복합 인덱스 |
| 예약 가능 좌석 조회 | 150만 | 615 | 718 / 1.71 | 13.7 / 479.6 | 단일 인덱스 |
| 만료 예약 조회 | 100만 | 1718 | 485 / 28.5 | - | 단일 인덱스 |
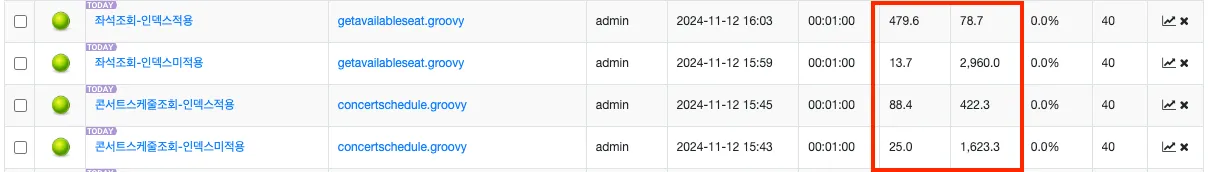
추가로 Prometheus + Grafana + Mysql Exporter를 사용해서 모니터링 비교를 해 보았는데,
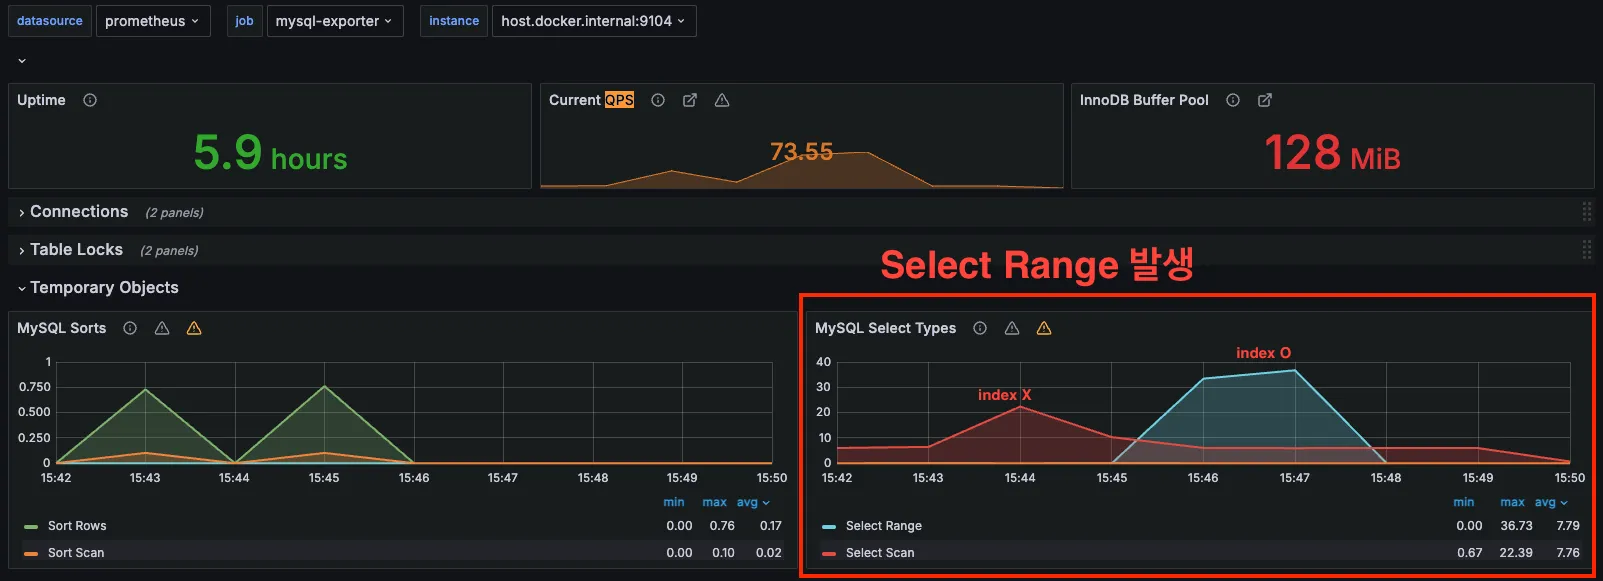
아래와 같이 변화가 생긴 것을 볼 수 있었다.
이번 스텝에서는 인덱스를 추가할 때 카디널리티와 수정 빈도를 주의 깊게 고려해야 한다는 점을 공부했다.
쿼리 성능이 느려지는 부분은 주로 WHERE 절이나 JOIN, ORDER BY 절에서 자주 사용되는 칼럼이 인덱스 후보가 되며, 복합 인덱스에서는 첫 번째 칼럼 순서가 중요해 자주 필터링되는 칼럼을 앞에 두면 성능이 크게 개선된다고 한다..
카디널리티가 낮은 필드는 인덱스 성능에 한계가 있고, 수정이 잦은 필드는 인덱스 업데이트로 인해 성능이 오히려 저하될 수 있음을 알게 되었으며 결국, 인덱스는 신중하게 적용해야 쿼리 성능 최적화를 제대로 할 수 있음을 확실히 깨달은 것 같다!
댓글
댓글을 불러오는 중…