알림톡 발송마다 TLS 를 다시 맺던 문제 – 연결 1,050개를 1개로 줄이기까지
1. 배경: 알림톡이 나가는 경로
설로인의 알림톡·문자는 모두 비즈뿌리오 API 로 나간다. API 서버나 배치가 직접 보내지 않고 RabbitMQ 큐에 넣으면 알림을 처리하는 워커 서버가 꺼내서 비즈뿌리오에 POST 한다.
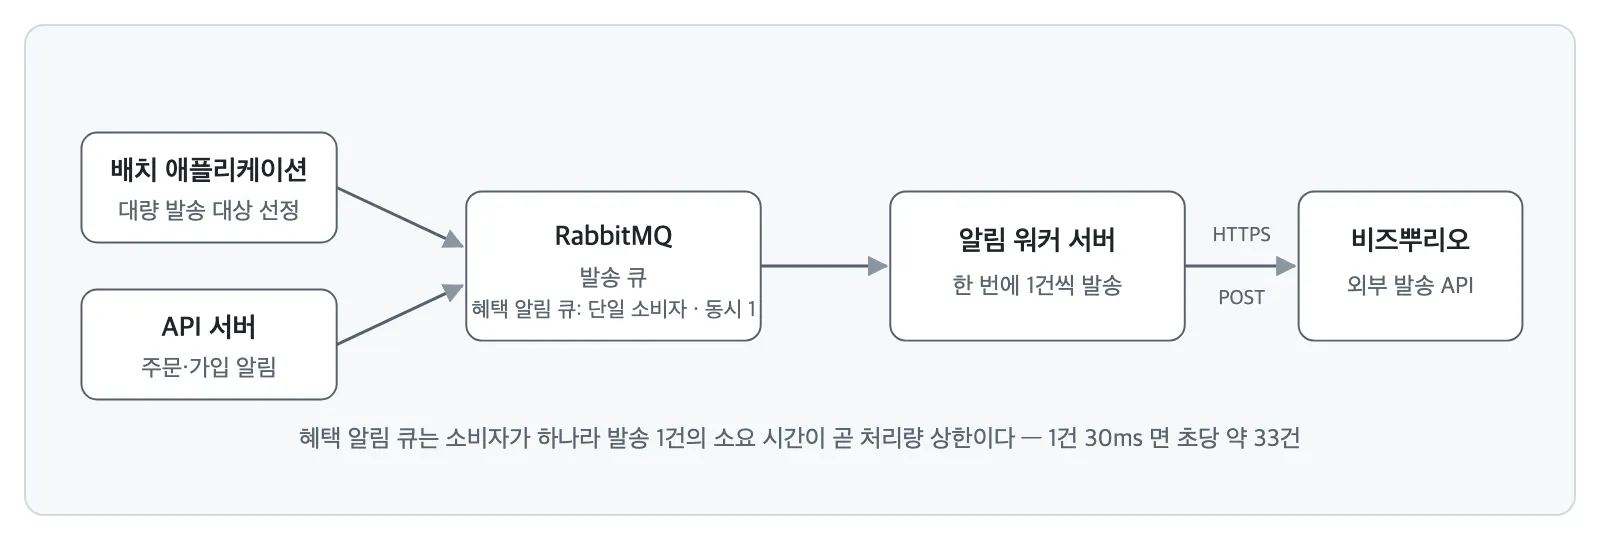
최근 알림 발송 시스템을 점검하면서 혜택 알림(이달의 별미·등급 유지·미션 독촉 등)을 배치의 직접 발송에서 이 큐로 옮겼다. 이때 두 가지 조건이 있었다.
- 혜택 알림 큐는 소비자가 하나이고 동시 처리도 1이다. 발송 한 건이 느려지면 전체가 그만큼 느려진다.
- 광고성 알림은 20:50 이후 발송할 수 없다. 저녁 대량 발송이 이 시각을 넘기면
OUTSIDE_SEND_WINDOW로 보류된다.
즉 대량 발송의 총 소요 시간은 발송 1건에 걸리는 시간에 건수를 곱한 값이다. 그래서 발송 1건의 시간이 어디에 쓰이는지부터 봤다.
2. 원인을 확인한 순서
2-1. 코드: 발송마다 클라이언트를 만들고 닫는다
먼저 발송 코드를 열었다. 비즈뿌리오를 부르는 BizPpurioUtils 는 요청할 때마다 HttpClient(CIO) 를 새로 만들고 .use { } 블록이 끝나면 닫는다.
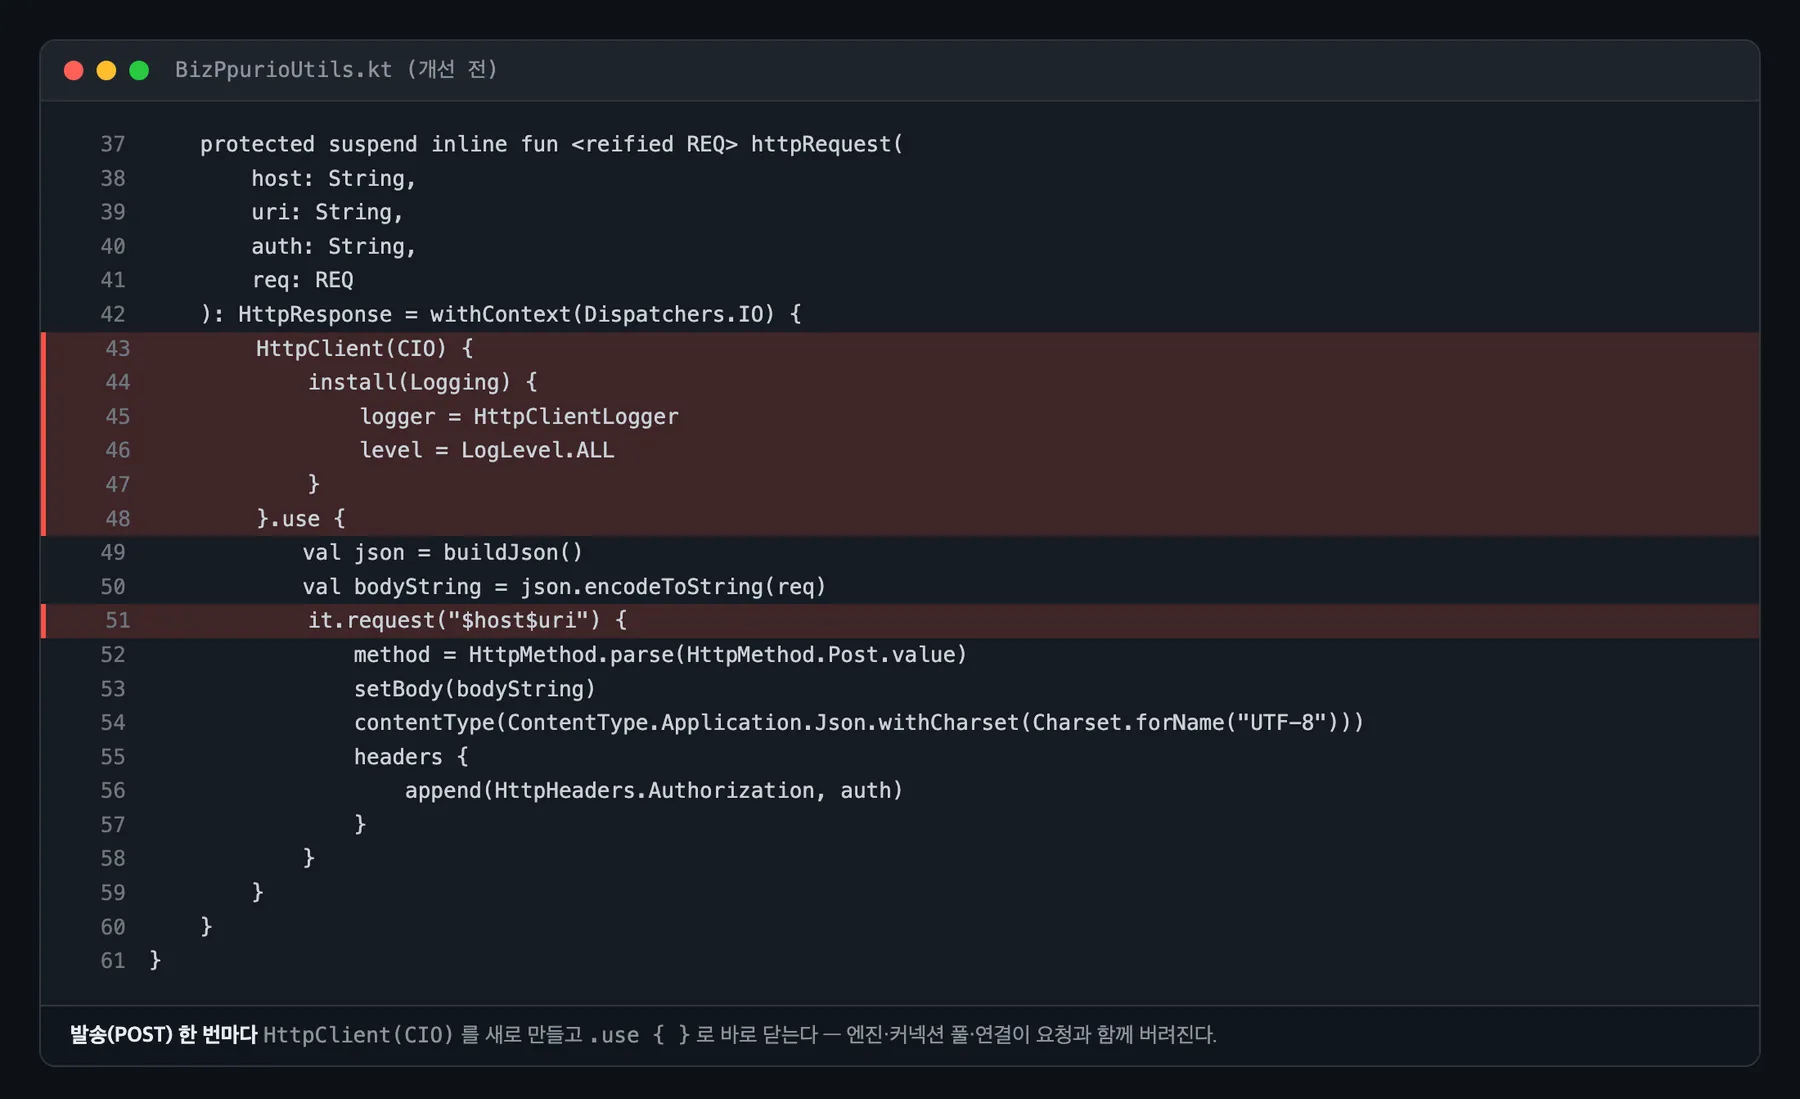
클라이언트를 닫으면 안의 엔진, 커넥션 풀, 열린 연결이 모두 사라진다. 다음 발송은 처음부터 다시 시작한다.
- TCP 3-way 핸드셰이크: 왕복 1번
- TLS 핸드셰이크: TLS 1.2 기준 왕복 2번, 키 교환과 인증서 검증에 드는 CPU
- 그다음 실제 POST
발송 1건마다 연결 1개와 핸드셰이크 1번이 붙는다. 저녁 대량 발송이 수천 건이면 핸드셰이크도 수천 번이다.
2-2. 클라이언트를 공유하면 해결될까: 라이브러리 소스 확인
처음에는 클라이언트를 하나 만들어 계속 쓰면 된다고 생각했다. 하지만 클라이언트를 공유해도 연결이 실제로 재사용되는지는 엔진 구현에 달려 있다. 그래서 운영과 같은 ktor-client-cio-jvm-2.3.13 소스를 확인했다.
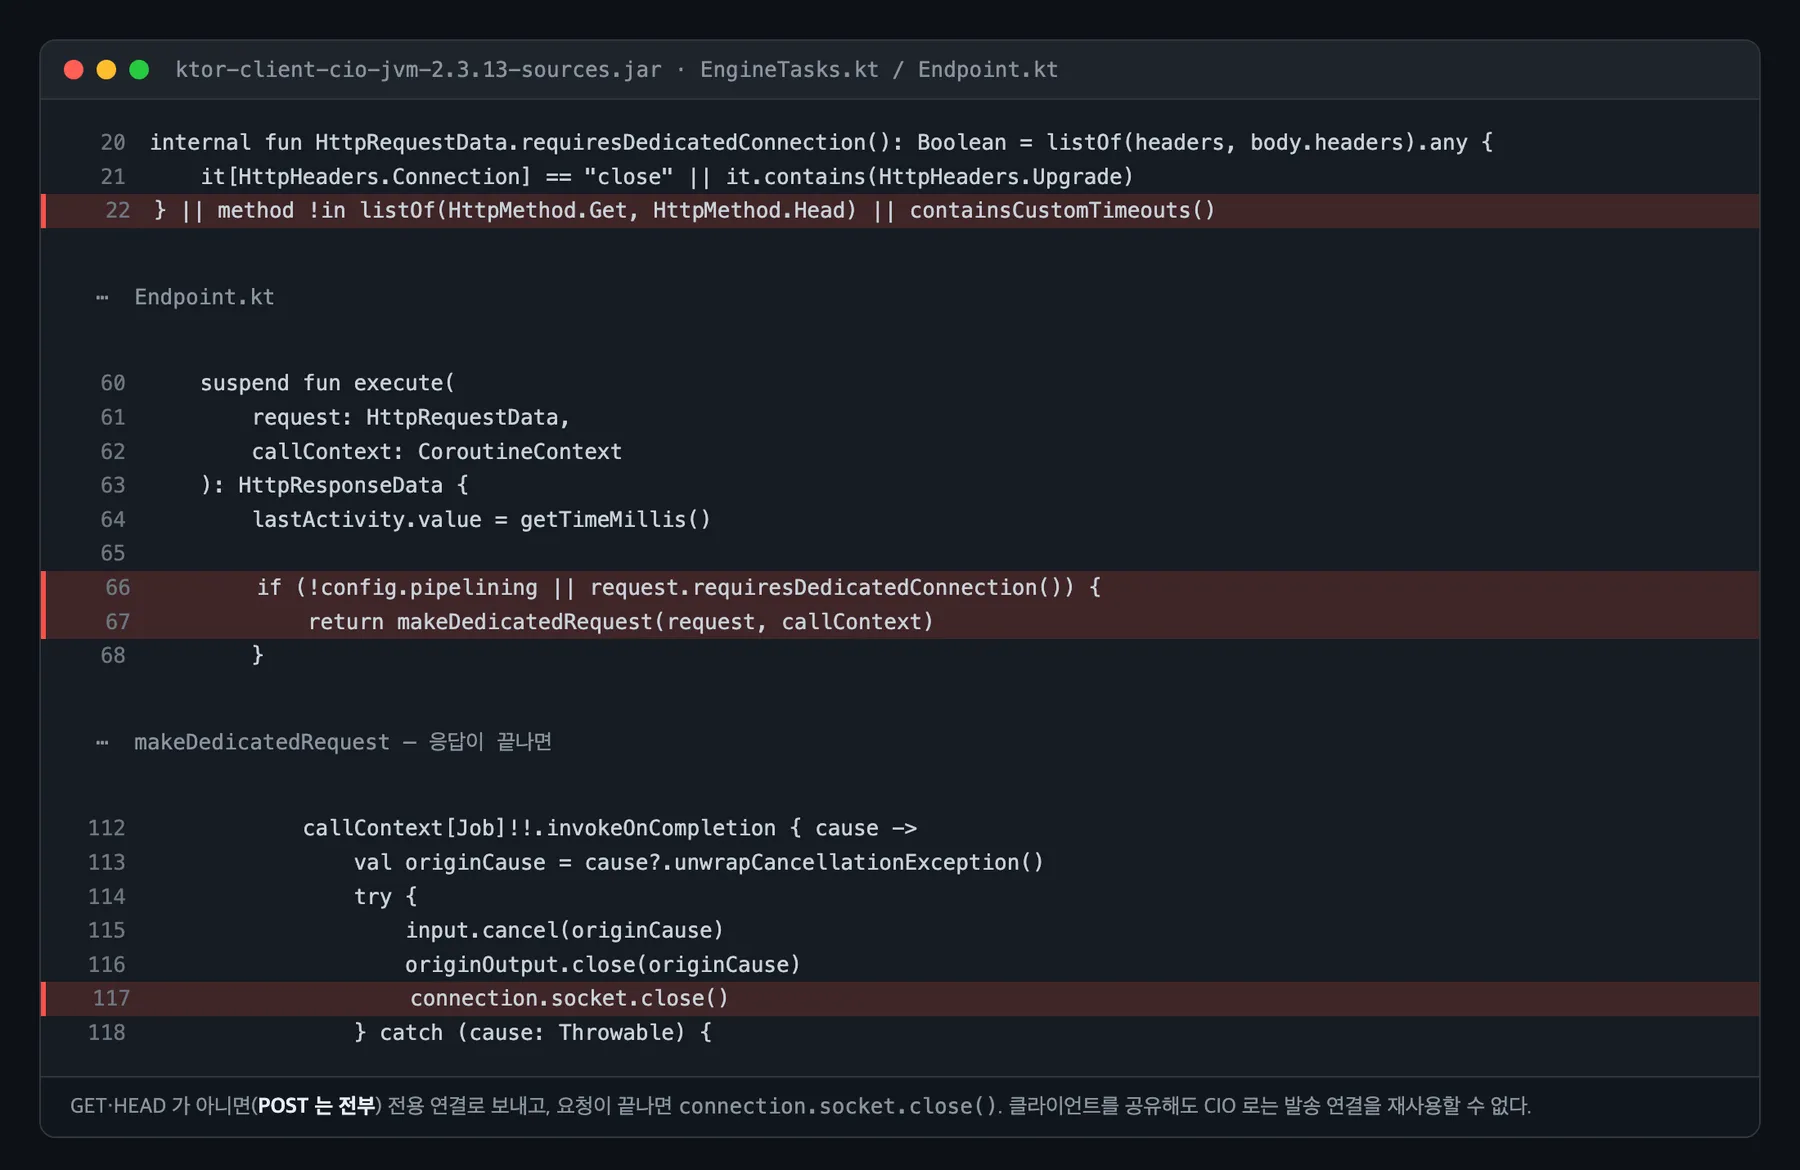
CIO 엔진은 POST 를 항상 전용 연결로 보내고 닫는다. 클라이언트를 공유해도 발송마다 TCP·TLS 를 다시 맺는다. 그래서 클라이언트 공유와 함께 엔진을 JDK HttpClient(Java 엔진)로 바꾸기로 했다. JDK 클라이언트는 POST 도 keep-alive 커넥션 풀로 재사용한다.
2-3. 상대 서버는 연결을 유지하고 있었나: 운영 로그
클라이언트가 연결을 재사용하려 해도 서버가 매번 닫으면 소용이 없다. 운영 로그를 읽기 전용으로 조회해 비즈뿌리오 응답 헤더를 확인했다.
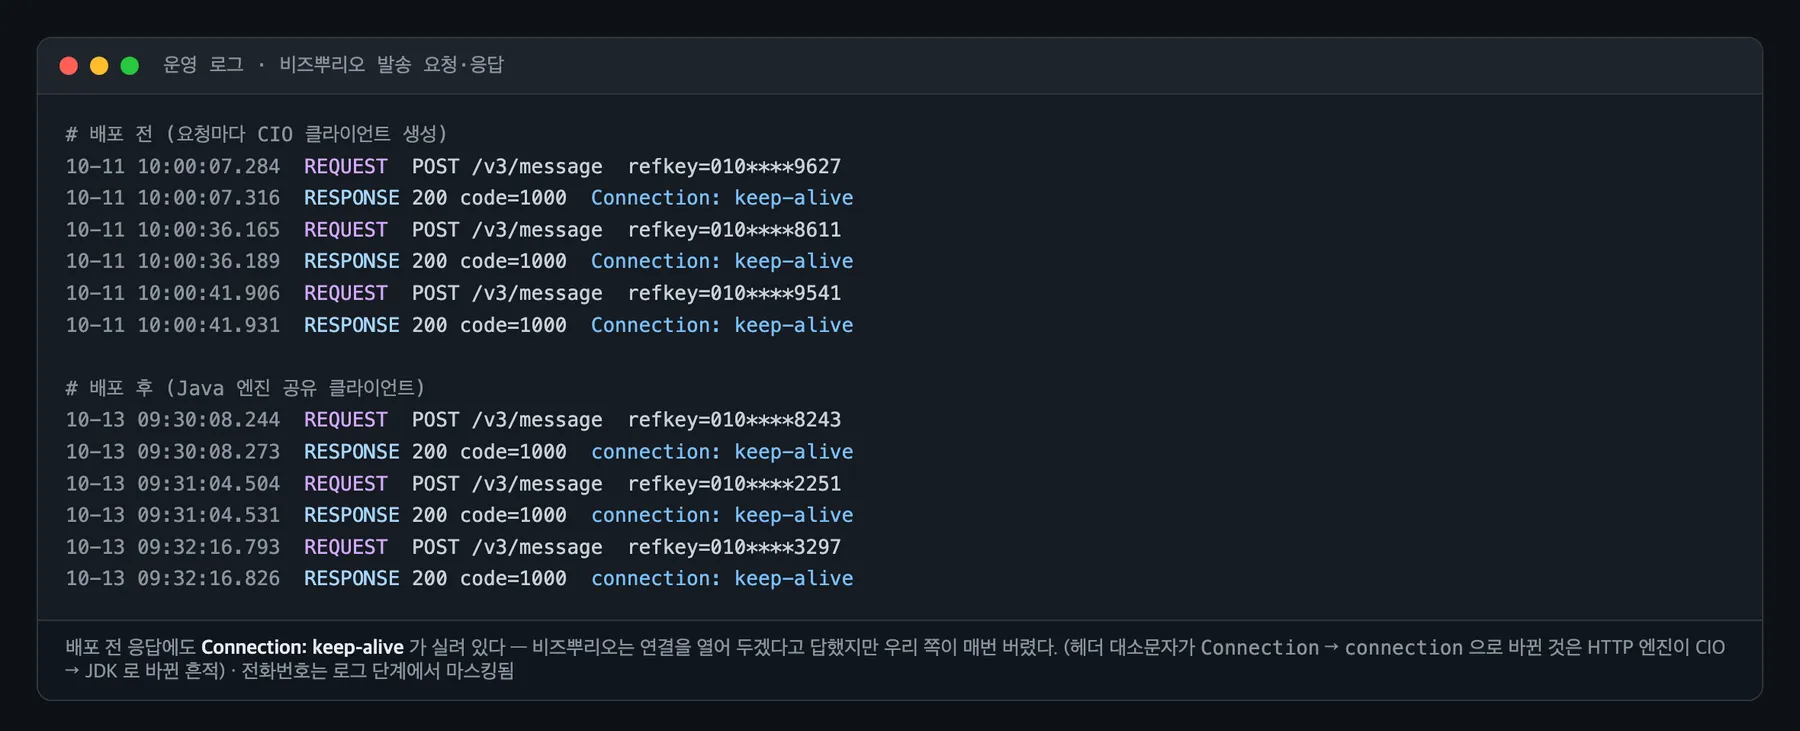
비즈뿌리오는 처음부터 연결을 열어 두고 있었고 연결을 버린 건 우리 쪽이었다.
keep-alive 헤더를 보내지 않아서 생긴 문제로 보기 쉽지만 그렇지 않았다. 로컬 재현에서 요청 헤더를 찍어 보니 개선 전 코드는 Connection 헤더를 아예 보내지 않았다(스냅샷 5 의 client_conn_header="-"). HTTP/1.1 은 헤더가 없으면 지속 연결이 기본이고 서버도 keep-alive 로 응답했다. 연결이 끊긴 이유는 클라이언트의 수명이었다. 요청마다 클라이언트를 만들고 닫았고 CIO 는 POST 연결을 스스로 닫았다. 그래서 헤더를 추가하지 않고 클라이언트를 하나로 오래 쓰면서 연결을 재사용하는 엔진으로 바꿨다.
2-4. 부하로 본 이유
- 처리량: 소비자가 하나라 발송 1건의 시간이 곧 처리량을 정한다. 발송마다 핸드셰이크 왕복 3번이 더해지고 비즈뿌리오까지의 지연이 클수록 손해도 커진다.
- CPU: TLS 핸드셰이크는 공개키 연산이라 일반 요청보다 CPU 를 많이 쓴다. 워커 pod 의 CPU request 는 1코어이고 다른 큐도 함께 처리한다. 클라이언트(엔진·셀렉터 스레드)를 매번 새로 만드는 비용도 있다.
- 연결 수: 발송이 수천 건이면 연결도 수천 개다. 짧게 쓰고 버린 연결은
TIME_WAIT로 남고 비즈뿌리오 쪽에도 그만큼 새 연결 요청이 간다.
처음 고칠 때는 로컬에 TLS 가 없어서 시간 차이를 재지 못했다. 남긴 수치는 "로컬 POST 300건: 연결 300개 → 1개"뿐이었다. 이 글을 쓰면서 TLS 를 포함한 재현 환경을 따로 만들어 다시 쟀다.
3. 바꾼 것
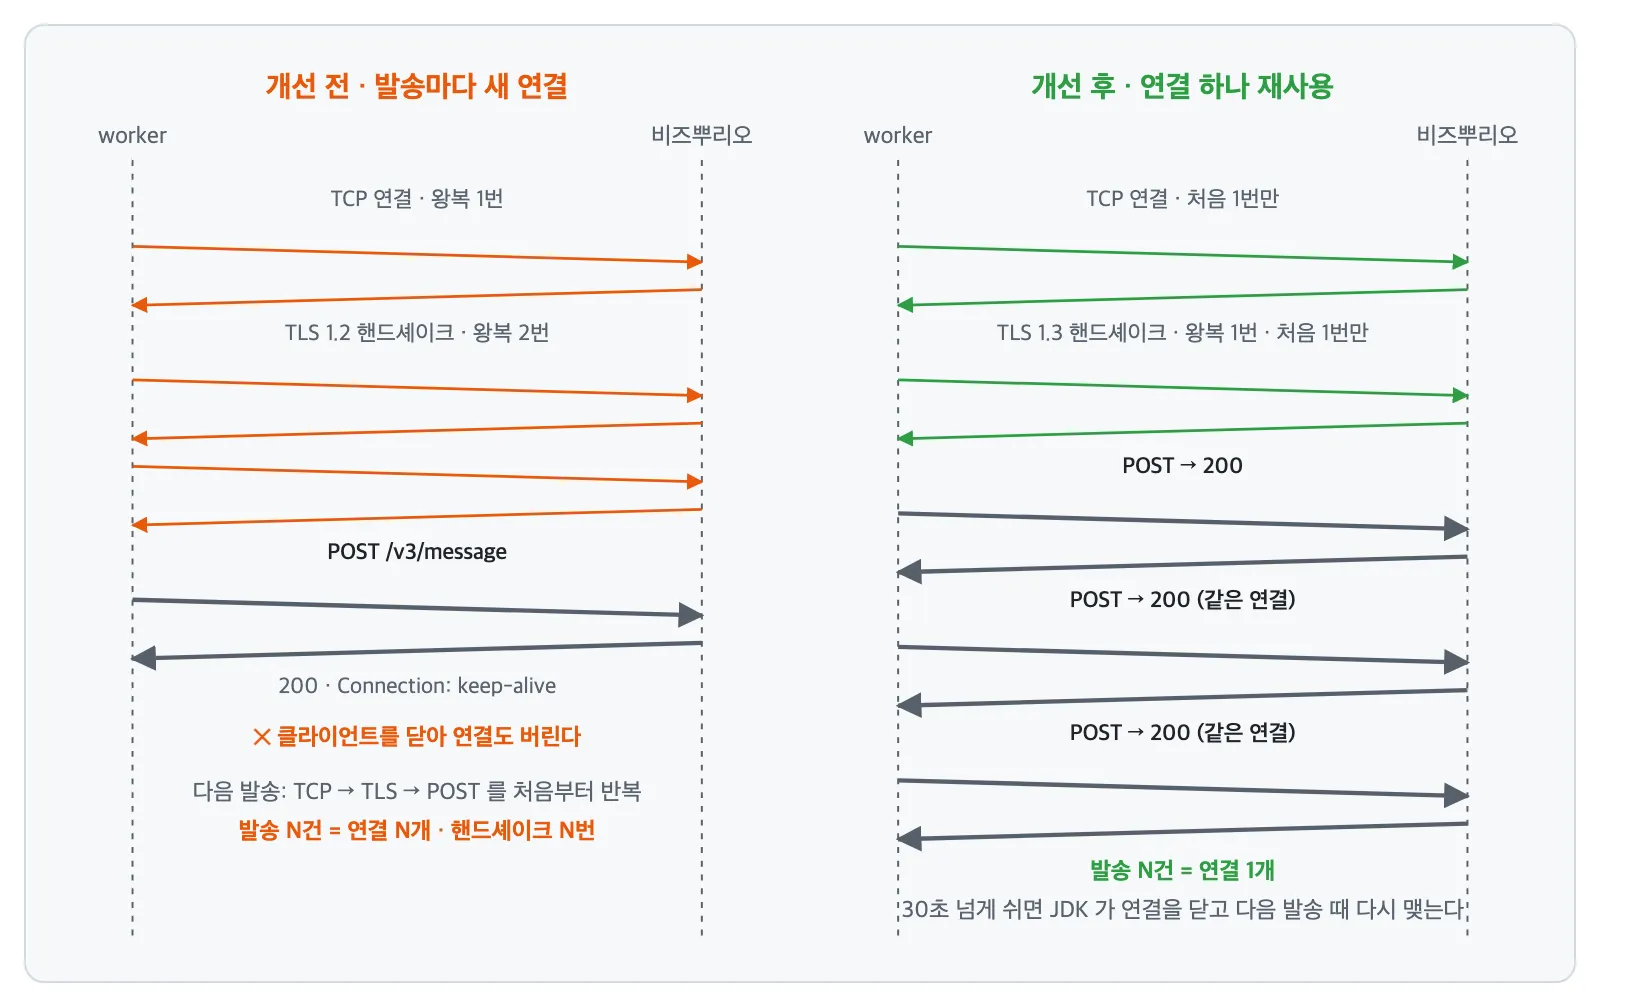
- 클라이언트를 하나로 두고 토큰 발급과 발송이 같이 쓴다. 빈이 내려갈 때(
@PreDestroy) 닫는다. - 엔진을 CIO 에서 Java(JDK HttpClient)로 바꿨다. POST 도 keep-alive 로 재사용하고 TLS 는 1.3 으로 협상한다. CIO 의 자체 TLS 구현은 1.3 을 지원하지 않아서 개선 전에는 1.2 로 연결됐다(4장 참고).
- 나머지 동작은 그대로 뒀다. 연결 5초·요청 15초(CIO 기본값과 같음), HTTP/1.1 고정, 로깅·헤더·본문 모두 같다.
- 중복 발송이 생기지 않는지 확인했다. 연결을 재사용하면 서버가 먼저 닫은 연결에 POST 가 실리는 경우가 새로 생긴다. JDK 는 비멱등 요청인 POST 를 자동으로 다시 보내지 않으므로, 이 경우는 "나갔는지 모름"으로 분류되고 두 번 나가지 않는다. 이 동작은 테스트로 고정했다.
- 클라이언트가 닫힌 뒤 들어온 요청은 벤더를 부르지 않고 "확실히 안 나감"으로 처리해 재시도 큐로 보낸다.
4. 부하테스트 환경
알림톡은 실제 고객에게 나가면 되돌릴 수 없다. 그래서 재현 환경에는 외부로 나가는 경로를 두지 않았다. 비즈뿌리오 대신 로컬 HTTPS 서버를 두고 운영과 비슷한 네트워크 지연만 넣었다.
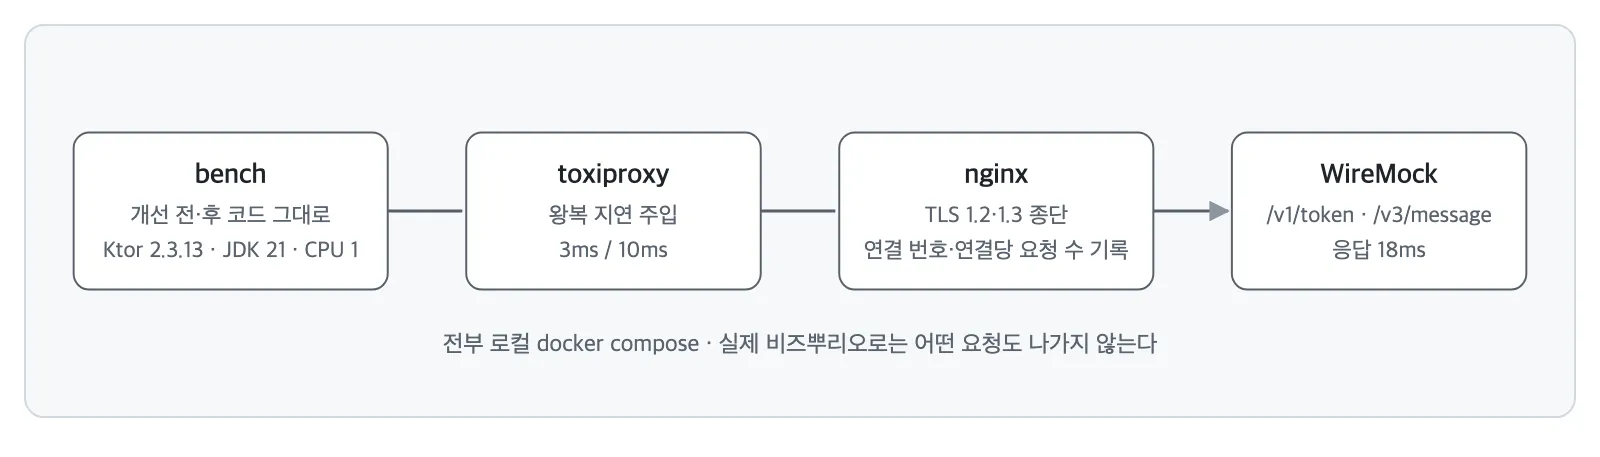
| 항목 | 설정 | 이유 |
|---|---|---|
| 측정 대상 코드 | 개선 전·후 BizPpurioUtils 를 그대로 옮김 | 변경점만 비교하려고 했다. Ktor 2.3.13·JDK 21 로 운영과 같고 로깅 플러그인(LogLevel.ALL)도 양쪽에 켜고 출력만 버렸다. |
| 발송 패턴 | 토큰 1번 → 발송 1,000건, 동시 1 (워밍업 50건은 결과에서 제외) | 혜택 알림 큐가 단일 소비자·동시 1 이다. 워밍업은 JIT 영향을 빼려고 넣었다. |
| CPU | bench 컨테이너 cpus: 1 | 워커 pod 의 CPU request 가 1000m 이다. |
| TLS | nginx 가 TLS 1.2·1.3 모두 허용, 세션 캐시 끔 | 실제 비즈뿌리오가 1.2·1.3 을 모두 받는다(curl 로 핸드셰이크만 해서 확인). 새로 만든 클라이언트는 세션 캐시가 없어 매번 전체 핸드셰이크를 한다. |
| 네트워크 왕복 지연 | 3ms(운영 근사) / 10ms(사무실 근사) | 사무실에서 비즈뿌리오까지 TCP 연결에 약 9.5ms 가 걸린다. 운영은 배포 전후 중앙값 차이가 6.8ms 였고 이를 새 연결의 추가 왕복(TCP 1번 + TLS 1.2 2번)으로 나누면 약 2~3ms 다. |
| 서버 처리 시간 | WireMock 응답 지연 18ms | 운영에서 연결을 재사용한 발송의 중앙값이 약 11ms, 배포 전 전체 중앙값이 약 28ms 여서 그 사이로 잡았다. 개선 전 p50 이 24.6ms 로 운영 배포 전(28.2ms)과 비슷하게 나왔다. |
| 측정 항목 | 처리량, 건당 p50/p90/p99, 건당 CPU, nginx 가 받은 TCP 연결 수 | 처리량과 지연은 사용자 영향, CPU 는 워커 여유, 연결 수는 원인을 보여준다. |
CIO 와 TLS 1.3: 처음에는 mock 을 TLS 1.3 전용으로 띄웠는데, 개선 전 코드가 TLSException: Received alert during handshake … ProtocolVersion 으로 연결하지 못했다. Ktor CIO 의 자체 TLS 구현이 1.3 을 지원하지 않기 때문이다. 운영에서 개선 전 코드가 동작했다면 비즈뿌리오와 TLS 1.2 로 협상하고 있었다는 뜻이다. TLS 1.2 는 1.3 보다 핸드셰이크 왕복이 한 번 더 많다.
5. 결과
5-1. 로컬 재현: 연결 사용
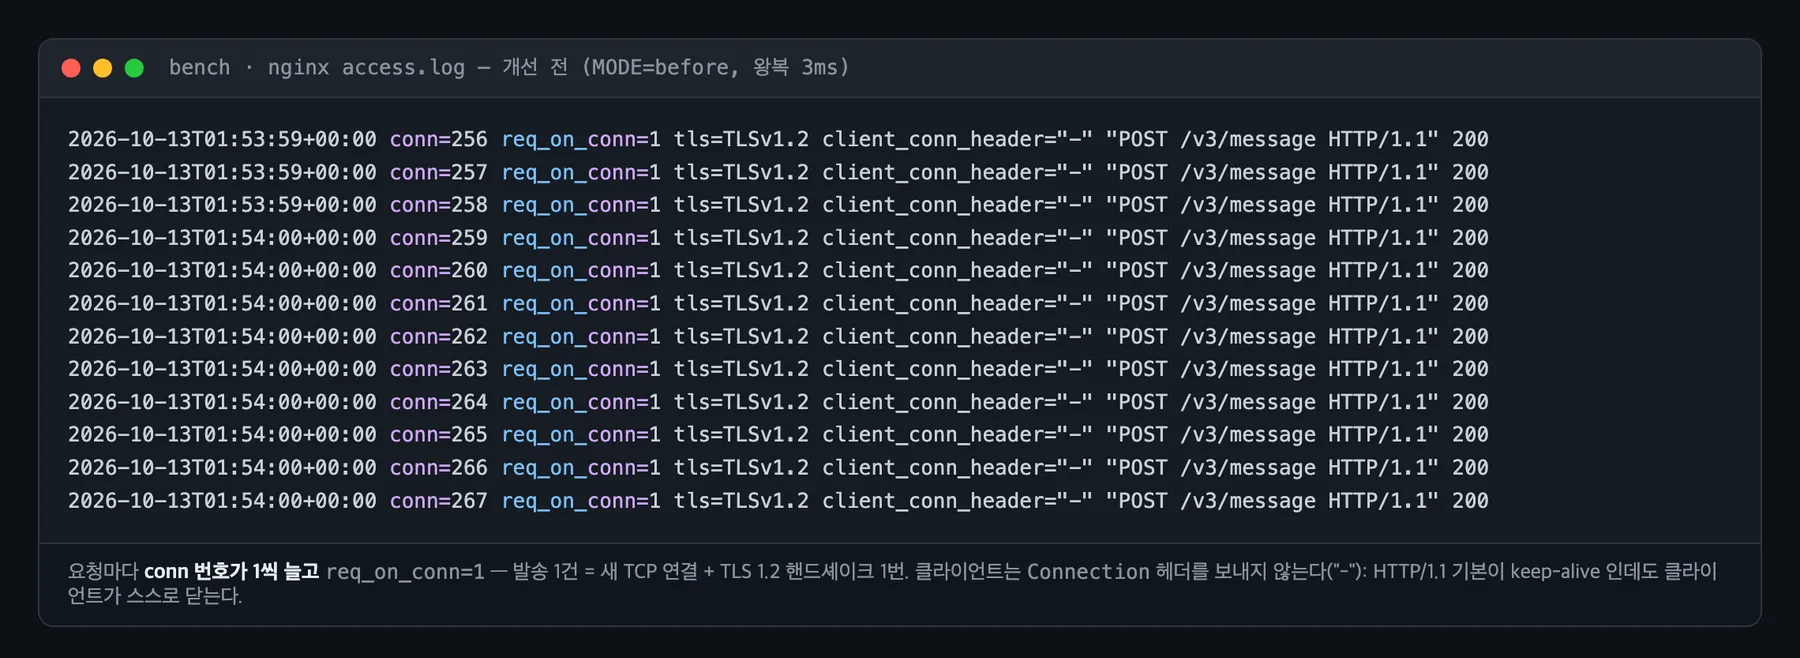
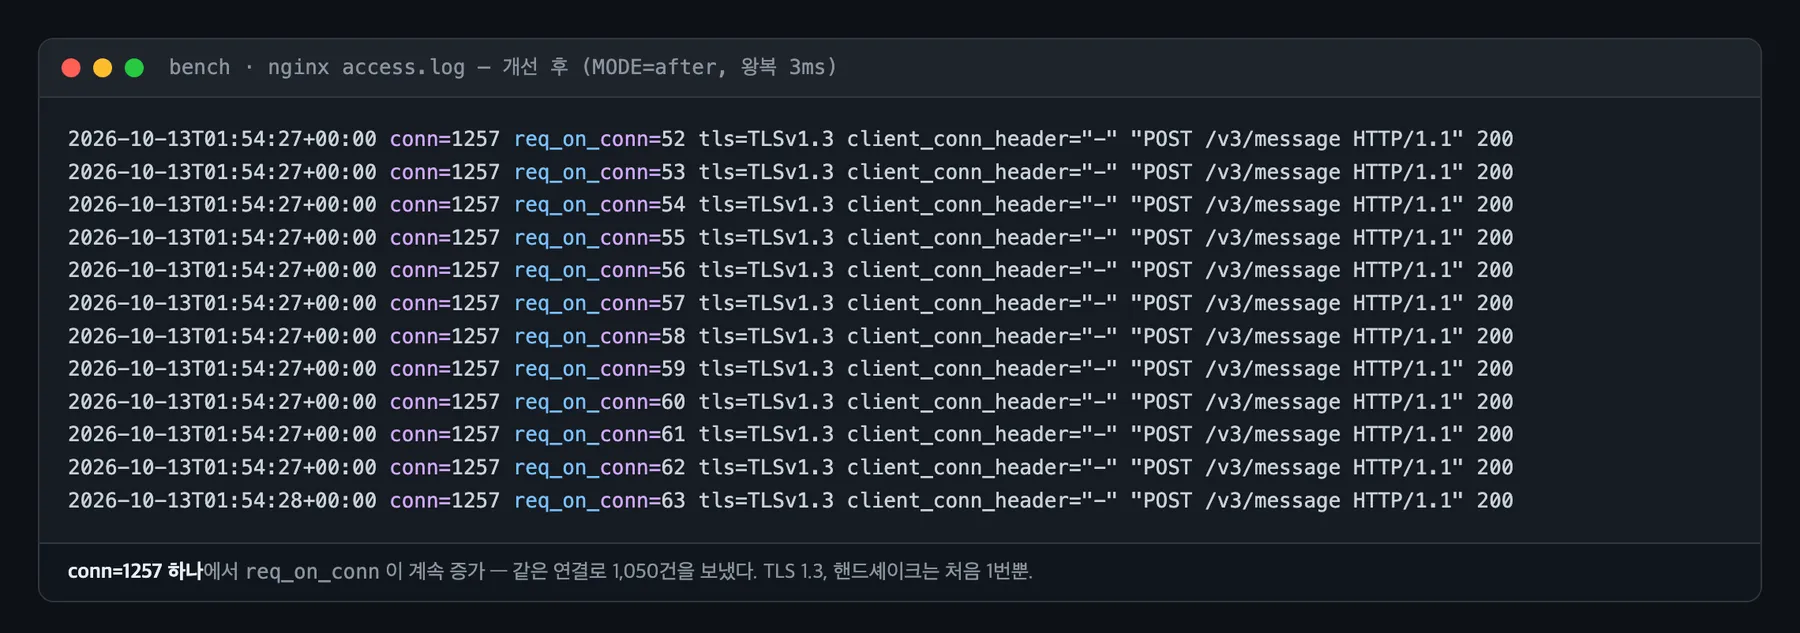
5-2. 로컬 재현: 수치
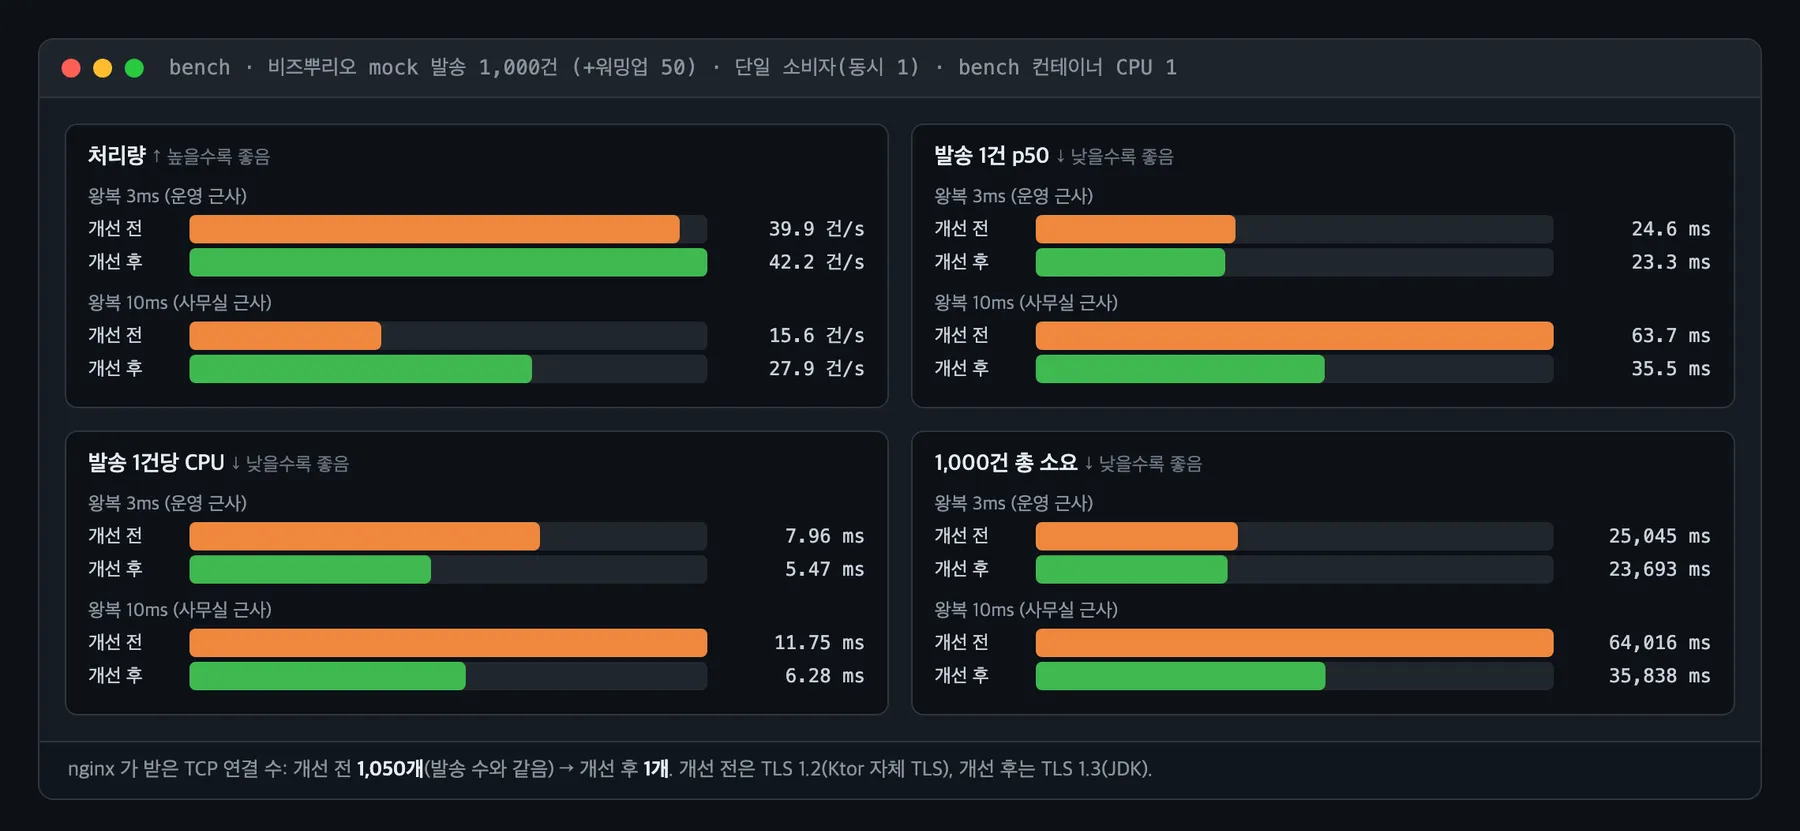
| 왕복 지연 | 처리량 | p50 | p99 | 건당 CPU | 1,000건 소요 | TCP 연결 | |
|---|---|---|---|---|---|---|---|
| 3ms | 개선 전 | 39.9 건/s | 24.6ms | 30.0ms | 7.96ms | 25.0s | 1,050 |
| 3ms | 개선 후 | 42.2 건/s | 23.3ms | 29.8ms | 5.47ms | 23.7s | 1 |
| 10ms | 개선 전 | 15.6 건/s | 63.7ms | 74.4ms | 11.75ms | 64.0s | 1,050 |
| 10ms | 개선 후 | 27.9 건/s | 35.5ms | 41.3ms | 6.28ms | 35.8s | 1 |
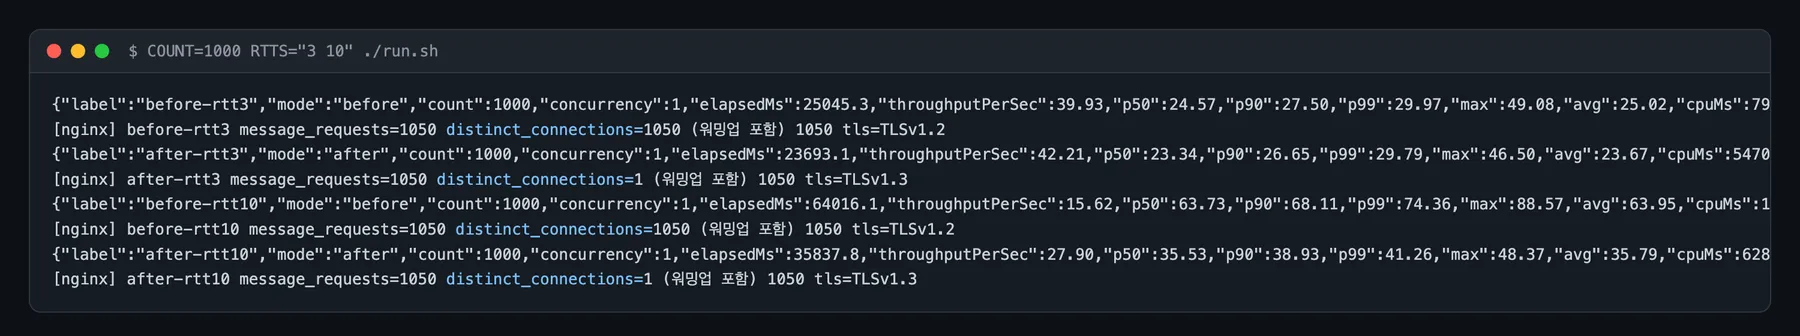
- 연결 수는 두 조건 모두 1,050개에서 1개로 줄었다.
- 건당 CPU 는 31%(왕복 3ms)~47%(왕복 10ms) 줄었다. 핸드셰이크와 클라이언트 생성 비용이 빠졌다.
- 처리량 개선 폭은 네트워크 지연이 클수록 커졌다. 새 연결마다 왕복 3번(TCP 1 + TLS 1.2 2)을 더 기다리기 때문이다. 왕복 10ms 에서는 +79%, 3ms 에서는 +6% 였다.
5-3. 운영: 배포 전후
배포 후 운영 로그에서 비즈뿌리오 요청 로그와 응답 로그를 같은 pod·refkey 로 짝지어 HTTP 왕복 시간을 구했다. 대상은 워커가 보낸 비즈뿌리오 발송 전체다. 이 기간에는 주문 알림 같은 개별 발송(알림톡·문자 발송 큐)이 대부분이었고 저녁 대량 발송은 없었다.
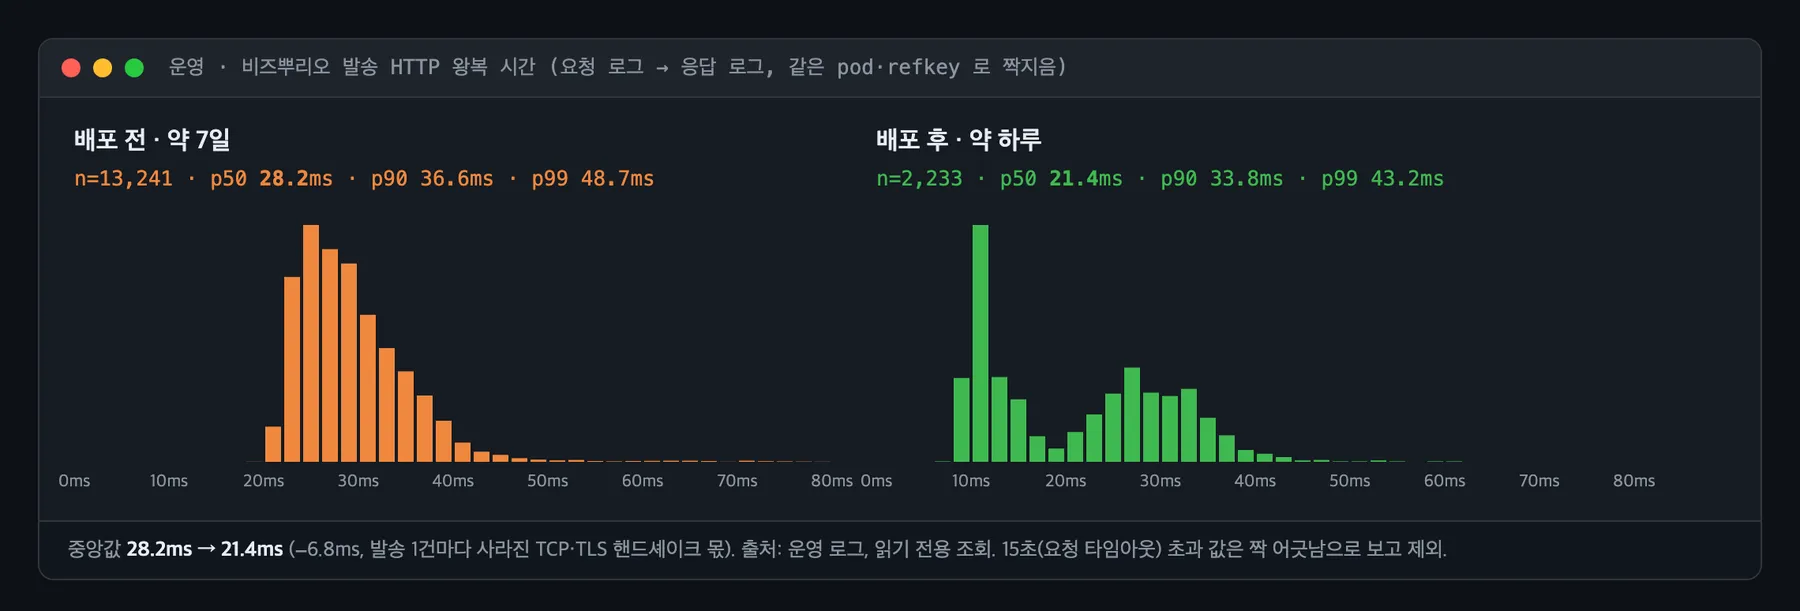
배포 후 분포가 둘로 나뉜 이유를 찾아봤다. 운영의 주문 알림은 수십 초 간격으로 드문드문 나가고 JDK HttpClient 는 쉬는 연결을 30초 뒤에 닫는다(jdk.httpclient.keepalive.timeout 기본값). 그래서 직전 발송과의 간격으로 다시 나눴다.
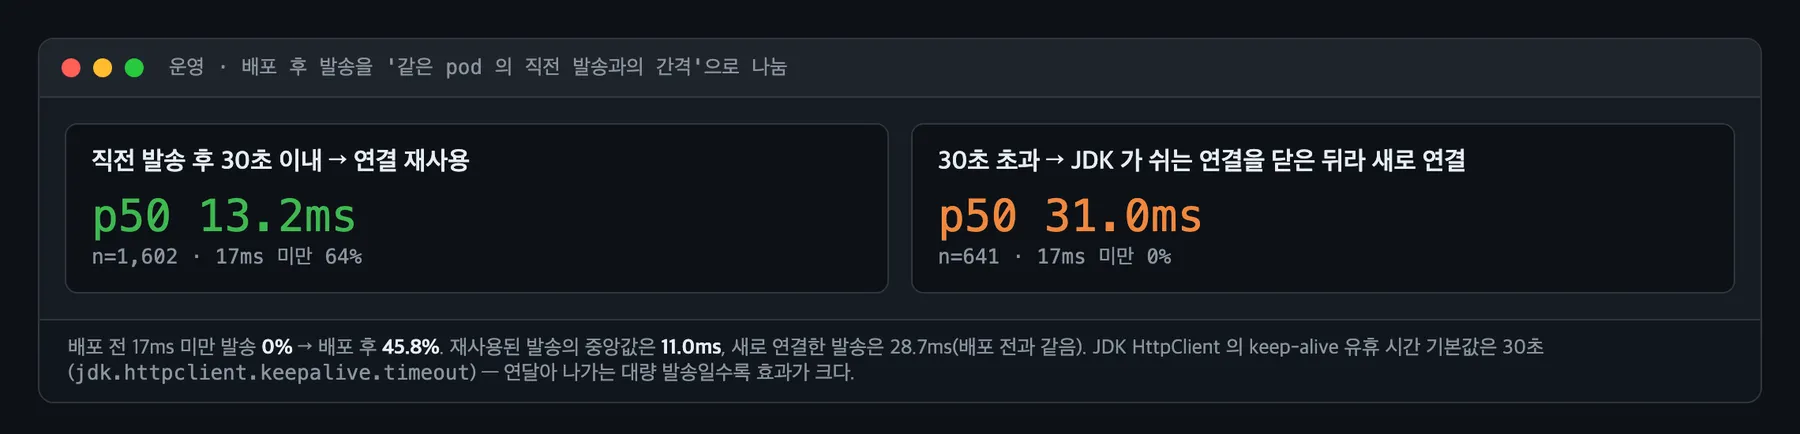
발송이 연달아 나갈수록 연결을 재사용한다. 이번 개선의 대상인 저녁 대량 발송은 소비자 하나가 쉬지 않고 연속으로 보내는 패턴이다.
6. 대량 발송으로 환산
운영에서 잰 HTTP 왕복 중앙값으로 소비자 하나가 1만 건을 연달아 보내는 경우를 계산했다. HTTP 구간만 센 값이고 발송 전후 처리(템플릿·로그·큐 확인)는 빠져 있다.
| 발송 1건 (중앙값) | 1만 건 HTTP 구간 합 | |
|---|---|---|
| 개선 전 · 매번 새 연결 | 28.2ms | 약 4분 42초 |
| 개선 후 · 연결 재사용 | 11.0ms | 약 1분 50초 |
건당 중앙값을 곱한 추정치이고 운영 대량 발송의 총 소요 시간을 직접 잰 값은 아니다. 혜택 알림 큐의 저녁 대량 발송이 실제로 몇 분 걸리는지는 다음 대량 발송 로그로 확인할 예정이다.
7. 정리
- 클라이언트를 공유하는 것만으로는 부족할 수 있다. 연결이 실제로 재사용되는지는 엔진 구현에 달려 있고 이번에는 라이브러리 소스를 보고 나서야 Ktor 2.3 CIO 가 POST 를 매번 새 연결로 보낸다는 것을 알았다.
- keep-alive 는 헤더 문제가 아니었다. HTTP/1.1 은 지속 연결이 기본이고 연결을 끊은 건 클라이언트를 만들고 닫는 코드였다. 서버 응답 헤더와 nginx 의 연결 번호를 함께 보고 원인을 확인했다.
- 재현 환경에는 TLS 를 넣어야 한다. 평문 HTTP 로 재면 이 문제가 거의 보이지 않는다. 처음 고칠 때 시간 차이를 재지 못한 이유도 이것이었다. 실제와 같은 TLS 버전 조건을 넣자 CIO 가 TLS 1.2 로만 연결된다는 것도 드러났다.
- 남은 위험은 벤더가 먼저 연결을 닫는 경우다. 비즈뿌리오가 쉬는 연결을 30초보다 먼저 닫으면, 그 순간과 겹친 발송이 "나갔는지 모름(ERROR)"으로 남을 수 있다. 중복 발송은 생기지 않는다. 배포 후 ERROR 비율을 지켜보고 필요하면
-Djdk.httpclient.keepalive.timeout을 벤더 값보다 짧게 준다.
요약
- 문제: 워커가 알림톡을 보낼 때마다 HTTP 클라이언트를 새로 만들고 닫았다. 발송 1건마다 TCP 연결과 TLS 핸드셰이크를 처음부터 다시 했다. 비즈뿌리오는 매번
Connection: keep-alive로 응답했지만 우리 쪽에서 연결을 버리고 있었다. - 클라이언트 공유만으로는 부족했다: 쓰던 Ktor CIO 엔진(2.3.13)은 POST 요청이면 클라이언트를 공유해도 매번 전용 연결을 열고 닫는다. 그래서 클라이언트를 하나로 두면서 엔진도 JDK HttpClient(Java 엔진)로 바꿨다.
- 로컬 재현 (mock 발송 1,000건, 소비자 1개)
- TCP 연결 수: 1,050개 → 1개 (워밍업 50건 포함)
- 발송 1건당 CPU: 31~47% 감소
- 처리량: 왕복 지연 10ms 조건에서 15.6 → 27.9건/s (+79%)
- 운영
- 발송 HTTP 왕복 시간 중앙값: 28.2ms → 21.4ms
- 연결을 재사용한 발송만 보면 중앙값 11.0ms
- 발송이 연달아 나갈수록 효과가 크다.
부록: 재현 방법과 데이터
./gradlew -q fatJar                      # 개선 전·후 코드를 담은 bench.jar
COUNT=1000 RTTS="3 10" ./run.sh          # mock(toxiproxy → nginx TLS → WireMock) 기동 후 4가지 조합 실행
# 결과: results/bench-*.json · results/nginx/access-*.log- 라이브러리 소스:
ktor-client-cio-jvm-2.3.13-sources.jar—EngineTasks.kt:20-22,Endpoint.kt:66-67, 117 - 운영 로그: 워커의 비즈뿌리오 요청·응답 로그를 읽기 전용으로 조회했다.
- 배포 전: 약 7일 (n=13,241)
- 배포 후: 약 하루 (n=2,233)
- 짝이 어긋나 15초(요청 타임아웃)를 넘은 값은 제외했다.
- 비즈뿌리오 TLS 확인:
curl --tls-max 1.2/--tls-max 1.3으로 비즈뿌리오 API 서버와 핸드셰이크만 했고 발송 요청은 보내지 않았다. - 스냅샷: 측정 데이터로 화면을 만들고 Chrome headless 로 캡처했다.
댓글
댓글을 불러오는 중…