타임아웃 정리 – 왜 나고, 어떤 종류가 있고, 코틀린에서는 어떻게 다룰까
들어가며
외부 API 를 붙여 쓰다 보면 타임아웃 로그를 가끔 본다. 어느 서비스인지는 적지 않겠지만 최근 몇 달 사이에도 이런 로그가 몇 번 남았다.
java.net.SocketTimeoutException: Read timed out평소 수백 ms 안에 오던 응답이 특정 시간대에만 몇 초씩 걸리다 끊겼다. 처음에는 상대 서버가 잠깐 느렸던 것으로 보고 넘겼는데 같은 일이 반복되자 몇 가지가 궁금해졌다.
- 타임아웃이 났을 때 상대 서버는 그 요청을 처리했을까?
- 재시도해도 될까? 같은 요청이 두 번 처리되지는 않을까?
- 우리 쪽 타임아웃은 몇 초였고 그 값은 어떻게 정해진 걸까?
withTimeout으로 감쌌는데 왜 한참 뒤에야 끝날까?
찾아보니 "타임아웃"이라는 말 하나에 서로 다른 것들이 섞여 있었다. 연결을 맺는 시간, 패킷 사이 간격, 호출 전체 시간, 커넥션 풀 대기 시간, 코루틴 취소. 이 글은 그것들을 나눠 정리한 기록이다. 예제는 코틀린으로 썼고 전부 직접 실행해 결과를 붙였다(Kotlin 2.4.21, kotlinx-coroutines 1.11.0, OkHttp 4.12.0, JDK 21).
1. 타임아웃이란
타임아웃은 기다리는 시간의 상한이다.
호출하는 쪽에서는 상대가 느린 것인지 죽은 것인지 구분할 수 없다. 응답이 아직 오지 않았다는 사실만으로는 조금 더 기다리면 올지 알 수 없으니 어딘가에서는 기다림을 끊어야 한다.
이때 타임아웃의 결과는 실패가 아니라 "알 수 없음"이다. Connection refused 는 상대가 연결을 거절했으니 요청이 처리되지 않은 게 확실하다. Read timed out 은 요청은 보냈지만 응답을 받지 못한 상태다. 상대가 아직 처리 중일 수도, 처리하고 응답을 보내다 유실됐을 수도, 요청을 받지 못했을 수도 있다. 그래서 첫 번째 질문의 답은 "알 수 없다"이다. 뒤에 나오는 재시도와 멱등성 이야기는 이 상태를 어떻게 다룰지에 관한 것이다.
기다림을 끊어야 하는 건 기다리는 동안 자원을 쥐고 있어서다. AWS Builders' Library 의 글도 여기서 시작한다.
When a client is waiting longer than usual for a request to complete, it also holds on to resources it was using for that request for a longer time.
스레드, 커넥션, 메모리를 쥔 채로 기다린다. 타임아웃이 없으면 하위 서비스 하나가 느려졌을 때 호출하는 쪽의 스레드 풀과 커넥션 풀이 차고 결국 상관없는 요청까지 멈춘다. 타임아웃은 이 전파를 끊는다.
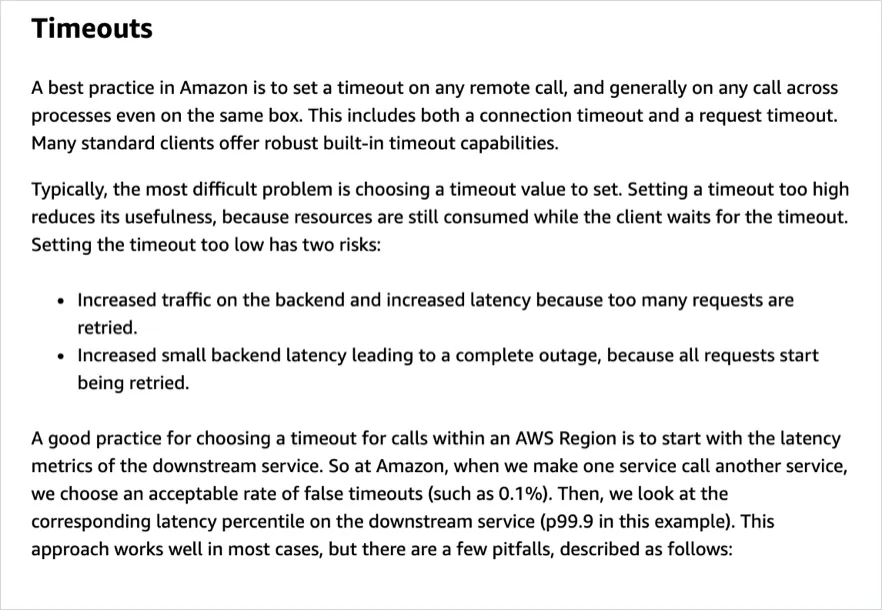
출처: AWS Builders' Library – Timeouts, retries, and backoff with jitter. 원격 호출에는 연결 타임아웃과 요청 타임아웃을 모두 건다고 적혀 있다.
2. 타임아웃은 왜 나는가
HTTP 요청 하나가 응답으로 돌아오기까지를 단계별로 나눠 보면 단계마다 걸리는 타임아웃이 따로 있다.
| 단계 | 늦어지는 이유 | 보통 이 구간을 재는 타임아웃 |
|---|---|---|
| 커넥션 풀에서 커넥션 빌리기 | 풀이 차서 반납을 기다림 | pool acquire / connectionTimeout(Hikari) |
| DNS 조회 | DNS 서버 지연, 재시도 | 대개 따로 없음, 전체 타임아웃에 포함 |
| TCP 연결 (3-way handshake) | 상대가 SYN 에 답하지 않음 (방화벽 drop, 서버 다운, 백로그 가득) | connect timeout |
| TLS 핸드셰이크 | 인증서 교환, 상대 CPU 부족 | TLS handshake timeout |
| 요청 전송 | 큰 본문, 상대 수신 버퍼 가득 | write timeout |
| 서버 처리 | 느린 쿼리, 락 대기, 스레드 풀 고갈, GC 멈춤, 하위 서비스 지연 | read(socket) timeout |
| 응답 수신 | 큰 응답, 패킷 유실과 재전송 | read(socket) timeout |
| 전체 | 위 단계의 합, 리다이렉트·재시도 포함 | call / request timeout |
실제로 자주 보는 타임아웃은 대부분 서버 처리 단계에서 난다. 원인은 서버 코드가 느려서라기보다 대기열이 길어져서인 경우가 많다. 요청이 처리 스레드나 DB 커넥션을 얻으려고 기다리는 시간이 늘어나면 평소 50ms 걸리던 API 도 트래픽이 몰릴 때 몇 초씩 걸린다.
2-1. 연결 실패도 두 가지다
connect timeout 과 connection refused 는 둘 다 연결 실패지만 성격이 다르다. 소켓으로 확인해 봤다.
import java.net.InetSocketAddress
import java.net.ServerSocket
import java.net.Socket
import kotlin.system.measureTimeMillis

fun probe(label: String, block: () -> Unit) {
    val took = measureTimeMillis {
        try { block(); println("$label → 성공") }
        catch (e: Exception) { println("$label → ${e::class.qualifiedName}: ${e.message}") }
    }
    println("    걸린 시간: ${took}ms")
}

fun main() {
    // 1) 응답 없는 주소: SYN 에 아무도 답하지 않는다
    probe("connect 10.255.255.1:80") {
        Socket().use { it.connect(InetSocketAddress("10.255.255.1", 80), 1_000) }
    }
    // 2) 닫힌 포트: 커널이 RST 를 바로 돌려준다
    val closedPort = ServerSocket(0).use { it.localPort }
    probe("connect 127.0.0.1:$closedPort (닫힌 포트)") {
        Socket().use { it.connect(InetSocketAddress("127.0.0.1", closedPort), 1_000) }
    }
    // 3) 연결은 받는데 응답을 안 하는 서버
    ServerSocket(0).use { server ->
        Thread { server.accept(); Thread.sleep(10_000) }.apply { isDaemon = true }.start()
        probe("read (응답 없는 서버, soTimeout=1s)") {
            Socket().use {
                it.connect(InetSocketAddress("127.0.0.1", server.localPort), 1_000)
                it.soTimeout = 1_000
                it.getInputStream().read()
            }
        }
    }
}
connect 10.255.255.1:80 → java.net.SocketTimeoutException: Connect timed out
걸린 시간: 1043ms
connect 127.0.0.1:50397 (닫힌 포트) → java.net.ConnectException: Connection refused
걸린 시간: 3ms
read (응답 없는 서버, soTimeout=1s) → java.net.SocketTimeoutException: Read timed out
걸린 시간: 1003ms- Connection refused 는 3ms 만에 끝났다. 호스트는 살아 있고 그 포트에 받는 프로세스가 없다는 응답(RST)이 바로 온다.
- Connect timed out 은 설정한 1초를 다 썼다. 호스트가 없거나, 방화벽이 패킷을 버리거나, 서버의 연결 대기열(backlog)이 찼을 때 이렇게 된다. 타임아웃을 걸지 않으면 OS 의 SYN 재전송이 끝날 때까지 기다린다(리눅스 기본값
tcp_syn_retries=6이면 약 2분). - Read timed out 은 연결은 됐는데 응답이 없는 경우다. 실제 요청이었다면 상대에게 전달됐을 수 있다.
들어가며에서 본 로그가 Read timed out 이었으니 연결은 됐고 상대가 요청을 받았을 가능성이 있다. 이 구분이 6장의 재시도 판단으로 이어진다.
3. 타임아웃의 종류
같은 이름이어도 재는 구간이 다르다. 네 가지로 나눠 봤다.
3-1. 연결 단계: connect timeout
TCP 연결(과 TLS 핸드셰이크)을 맺는 시간의 상한이다. 같은 리전 안이면 수 ms, 인터넷을 건너도 보통 수백 ms 안에 끝난다. 연결이 안 된다는 건 상대가 아예 응답하지 않는다는 뜻에 가까우니 짧게 잡아도 된다.
3-2. 데이터 단계: read(socket) / write timeout
이름 때문에 응답 전체를 기다리는 시간으로 오해하기 쉽다. 실제로는 패킷과 패킷 사이의 최대 공백이다. Ktor 문서에 그렇게 적혀 있다.
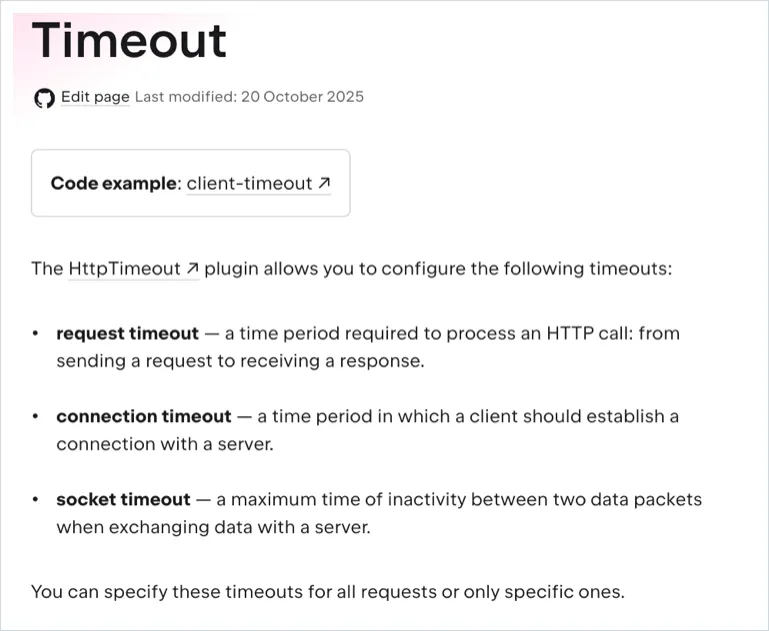
출처: Ktor – Timeout. socket timeout 을 "a maximum time of inactivity between two data packets" 로 설명한다.
OkHttp 의 readTimeout 도 같다. 소스 KDoc 에 "applied to both the TCP socket and for individual read IO operations" 라고 되어 있고 read 가 한 번 성공할 때마다 시간을 다시 잰다. 그렇다면 서버가 조금씩 꾸준히 보내면 어떻게 될까.
3-3. 전체 단계: call / request timeout
헤더는 바로 보내고 본문은 0.5초에 1바이트씩 20바이트(총 10초)를 보내는 서버를 만들어 OkHttp 로 호출했다.
import okhttp3.OkHttpClient
import okhttp3.Request
import java.net.ServerSocket
import java.util.concurrent.TimeUnit
import kotlin.system.measureTimeMillis

// 헤더는 바로 주고, 본문을 0.5초에 1바이트씩 20바이트(총 10초) 흘려보내는 서버
fun trickleServer(): ServerSocket {
    val server = ServerSocket(0)
    Thread {
        while (true) {
            val s = runCatching { server.accept() }.getOrNull() ?: break
            Thread {
                runCatching {
                    s.use {
                        it.getInputStream().read(ByteArray(4096))
                        val out = it.getOutputStream()
                        out.write("HTTP/1.1 200 OK\r\nContent-Length: 20\r\n\r\n".toByteArray()); out.flush()
                        repeat(20) { Thread.sleep(500); out.write('x'.code); out.flush() }
                    }
                }
            }.apply { isDaemon = true }.start()
        }
    }.apply { isDaemon = true }.start()
    return server
}

fun call(label: String, client: OkHttpClient, url: String) {
    val took = measureTimeMillis {
        try {
            client.newCall(Request.Builder().url(url).build()).execute()
                .use { println("$label → ${it.body!!.string().length}바이트 받음") }
        } catch (e: Exception) {
            println("$label → ${e::class.qualifiedName}: ${e.message}")
        }
    }
    println("    걸린 시간: ${took}ms")
}

fun main() {
    trickleServer().use { server ->
        val url = "http://127.0.0.1:${server.localPort}/"
        call("readTimeout=1s", OkHttpClient.Builder().readTimeout(1, TimeUnit.SECONDS).build(), url)
        call("readTimeout=1s + callTimeout=3s",
            OkHttpClient.Builder().readTimeout(1, TimeUnit.SECONDS).callTimeout(3, TimeUnit.SECONDS).build(), url)
    }
}
readTimeout=1s → 20바이트 받음
걸린 시간: 10086ms
readTimeout=1s + callTimeout=3s → java.io.InterruptedIOException: timeout
걸린 시간: 3013msreadTimeout 을 1초로 뒀는데 10초를 기다렸다. 패킷 간격이 0.5초라 read timeout 조건에 한 번도 걸리지 않았다. 응답을 천천히 내려주는 서버나 프록시 앞에서는 read timeout 이 최대 대기 시간 역할을 하지 못한다.
그래서 호출 전체에 거는 타임아웃이 따로 필요하다. OkHttp 의 callTimeout 은 DNS 조회부터 응답 본문을 다 읽을 때까지, 리다이렉트와 재시도까지 포함한 시간이다. 기본값은 0(무제한)이다. OkHttp 소스에 적힌 기본값은 이렇다.
// okhttp3.OkHttpClient.Builder (OkHttp 소스)
internal var callTimeout = 0
internal var connectTimeout = 10_000
internal var readTimeout = 10_000
internal var writeTimeout = 10_000
설정 없이 만든 OkHttp 클라이언트는 connect·read·write 가 각각 10초이고 전체 시간에는 제한이 없다. 위 서버 같은 상대를 만나면 계속 기다린다.
Spring WebClient(Reactor Netty)도 구조가 같다. 연결 타임아웃(CONNECT_TIMEOUT_MILLIS), 패킷 간격 타임아웃(ReadTimeoutHandler/WriteTimeoutHandler), 응답 전체를 기다리는 responseTimeout 이 따로 있다.
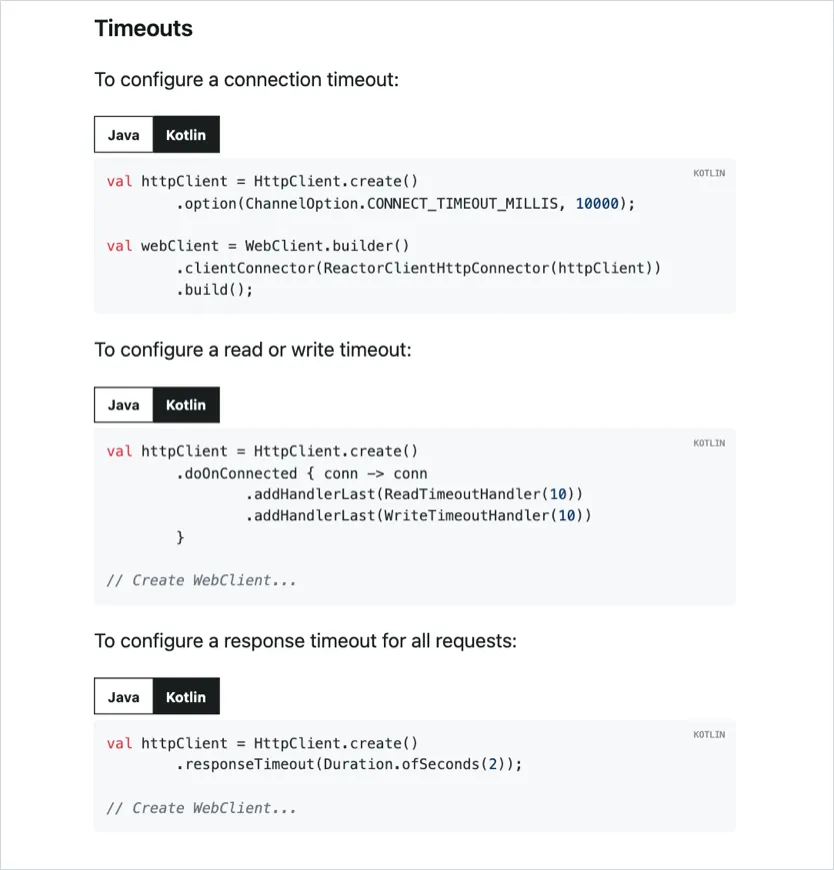
출처: Spring Framework – WebClient Configuration › Timeouts
3-4. 대기 단계: 커넥션 풀 타임아웃
네트워크를 타기 전에 애플리케이션 안에서 나는 타임아웃도 있다. 커넥션 풀에서 커넥션을 빌리려고 기다리는 시간이다. HikariCP 의 connectionTimeout 이 여기에 해당한다.
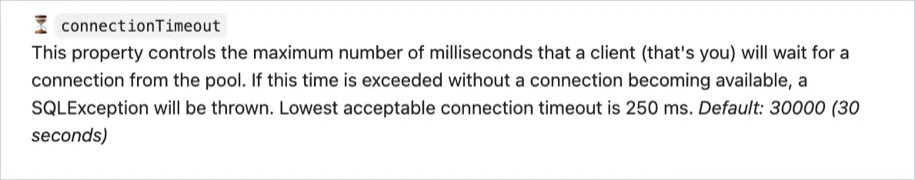
출처: HikariCP README. 기본값은 30초다.
이름은 connect timeout 과 비슷하지만 DB 에 연결하는 시간은 아니다. 풀에서 차례를 기다리는 시간이다. 이 타임아웃이 나면 DB 가 느린지보다 커넥션을 오래 쥐는 코드(긴 트랜잭션, 트랜잭션 안의 외부 API 호출 등)부터 의심한다. 기본값 30초는 사용자 요청을 받는 API 서버에는 길다. 풀이 바닥났을 때 30초씩 기다리게 하기보다 빨리 실패하고 알람을 받는 편이 낫다고 본다.
DB 드라이버에도 타임아웃이 있다. PostgreSQL JDBC 드라이버의 기본값은 connectTimeout=10(초), socketTimeout=0(무제한)이다. 쿼리가 끝나지 않으면 드라이버는 계속 기다린다. 쿼리 단위로는 Statement.setQueryTimeout(Spring 에서는 @Transactional(timeout = ...))이나 DB 쪽 statement_timeout 을 함께 쓴다.
3-5. 기본값 모아 보기
라이브러리마다 기본값이 달라서 쓰는 클라이언트가 설정 없이 얼마나 기다리는지는 확인해 둬야 한다. 아래는 소스와 공식 문서에서 확인한 값이다.
| 클라이언트 | connect | read / socket | 전체(call / request) | 풀 대기 |
|---|---|---|---|---|
| OkHttp 4.x / 5.x | 10s | 10s (write 도 10s) | 0 (무제한) | – |
Ktor HttpTimeout 플러그인 | 설정하지 않으면 걸지 않음 (엔진 기본값을 따름) | 〃 | 〃 | – |
| Ktor CIO 엔진 | 5s | 무제한 | 15s | – |
| HikariCP | – | – | – | 30s (connectionTimeout) |
| PostgreSQL JDBC | 10s | 0 (무제한, socketTimeout) | – | – |
무제한인 항목이 생각보다 많다. 기본값에 기대지 않고 값을 직접 적어 두는 편이 안전하다.
4. 코틀린 코루틴의 타임아웃
코틀린에는 I/O 라이브러리 타임아웃 말고도 코루틴의 withTimeout / withTimeoutOrNull 이 있다.
출처: Kotlin docs – Cancellation and timeouts
val profile = withTimeoutOrNull(500.milliseconds) {
    profileClient.fetch(userId)
} ?: Profile.EMPTY            // 시간 안에 못 받으면 기본값으로
withTimeout 은 시간이 지나면 블록을 취소하고 TimeoutCancellationException 을 던진다. withTimeoutOrNull 은 예외 대신 null 을 돌려준다. 여기서 말하는 취소가 어떻게 동작하는지에 따라 결과가 달라져서 세 가지를 확인했다.
4-1. 블로킹 코드는 취소되지 않는다
import kotlinx.coroutines.*
import kotlin.time.Duration.Companion.seconds
import kotlin.time.measureTime

suspend fun attempt(label: String, block: suspend () -> Unit) {
    val took = measureTime {
        try {
            withTimeout(1.seconds) { block() }
            println("$label → 정상 종료")
        } catch (e: TimeoutCancellationException) {
            println("$label → ${e::class.simpleName}")
        }
    }
    println("    걸린 시간: ${took.inWholeMilliseconds}ms")
}

fun main() = runBlocking {
    attempt("delay(3s)") { delay(3_000) }
    attempt("Thread.sleep(3s)") { Thread.sleep(3_000) }
    attempt("runInterruptible { Thread.sleep(3s) }") {
        runInterruptible(Dispatchers.IO) { Thread.sleep(3_000) }
    }
}
delay(3s) → TimeoutCancellationException
걸린 시간: 1016ms
Thread.sleep(3s) → 정상 종료
걸린 시간: 3004ms
runInterruptible { Thread.sleep(3s) } → TimeoutCancellationException
걸린 시간: 1003ms두 번째 결과를 보면 1초 타임아웃을 걸었는데 3초를 다 기다렸고 예외도 나지 않았다. Dispatchers.Default 에서 돌려도 같았다(3010ms, 정상 종료).
코루틴 취소는 협조적(cooperative)이다. 타임아웃은 취소 신호를 보낼 뿐이고 코루틴은 delay 같은 중단 지점에서 그 신호를 확인하고 멈춘다. Thread.sleep 이나 블로킹 I/O 에는 중단 지점이 없어서 신호를 확인하지 못한다. KDoc 에도 이렇게 적혀 있다.
withTimeout will not automatically stop all code inside it from being executed once the timeout gets triggered. It only cancels the running block, but it's up to the block to notice that it was cancelled. —
withTimeoutKDoc
네 번째 질문의 답이 이것이었다. OkHttp 의 execute(), JDBC 쿼리, RestTemplate 같은 블로킹 호출은 withTimeout 으로 감싸도 멈추지 않는다. 블로킹 호출을 끊으려면 두 가지 방법이 있다.
- 클라이언트 자체의 타임아웃(
callTimeout,queryTimeout등)을 건다. 가장 확실한 방법이다. - 스레드 인터럽트에 반응하는 코드라면
runInterruptible로 감싼다. 코루틴이 취소될 때 스레드를 인터럽트한다(세 번째 결과).
출처: Kotlin docs – Interrupt blocking code when coroutines are canceled
Ktor 클라이언트처럼 suspend 로 만들어진 클라이언트는 취소에 반응하므로 withTimeout 과 잘 맞는다. 블로킹 클라이언트를 코루틴에서 쓴다면 타임아웃은 클라이언트에 걸고 withTimeout 은 보조로 쓰는 게 맞다고 본다.
4-2. TimeoutCancellationException 은 CancellationException 이다
TimeoutCancellationException 은 CancellationException 을 상속한다. 그래서 두 가지 문제가 생긴다.
첫째, catch (e: Exception) 이 타임아웃까지 잡는다. 실패하면 로그만 남기고 계속 도는 코드가 withTimeout 안에 있으면 이렇게 된다.
import kotlinx.coroutines.*
import kotlin.time.Duration.Companion.milliseconds
import kotlin.time.Duration.Companion.seconds

fun main() = runBlocking {
    val result = withTimeoutOrNull(1.seconds) {
        repeat(5) { i ->
            try {
                delay(400.milliseconds)
                println("poll #$i 성공")
            } catch (e: Exception) {           // CancellationException 까지 삼킨다
                println("poll #$i 실패 무시: ${e::class.simpleName}")
            }
        }
        "완료"
    }
    println("결과: $result")
}
poll #0 성공
poll #1 성공
poll #2 실패 무시: TimeoutCancellationException
poll #3 실패 무시: TimeoutCancellationException
poll #4 실패 무시: TimeoutCancellationException
결과: null1초가 지나 타임아웃이 났지만 루프는 계속 돌았다. 예외를 일반 실패로 처리하고 다음 반복으로 넘어갔기 때문이다. 이 예제는 취소된 코루틴의 delay 가 즉시 예외를 던져서 빨리 끝났을 뿐이다. 중단 지점이 없는 작업이었다면 끝까지 실행됐을 것이다. 로그에는 실패만 쌓여서 원인을 찾기도 어렵다.
catch (e: Exception) 을 써야 한다면 CancellationException 은 다시 던진다. runCatching 도 CancellationException 까지 잡으니 같은 주의가 필요하다.
try {
    poll()
} catch (e: CancellationException) {
    throw e                     // 취소·타임아웃은 그대로 올려 보낸다
} catch (e: Exception) {
    log.warn(e) { "poll 실패, 다음 주기에 재시도" }
}
둘째, 부모 코루틴이 실패하지 않는다. 취소 예외는 오류로 취급되지 않아 부모에게 전파되지 않는다.
coroutineScope {
    launch {
        withTimeout(100.milliseconds) { awaitCancellation() }
    }
}
println("자식이 타임아웃으로 끝났지만 coroutineScope 는 정상 종료")
자식이 타임아웃으로 끝났지만 coroutineScope 는 정상 종료launch 안에서 타임아웃이 났는데 바깥에서는 아무 일도 없었던 것처럼 보인다. 타임아웃을 실패로 다뤄야 한다면 KDoc 에서 권하듯 withTimeoutOrNull 결과를 확인해 일반 예외로 바꿔 던진다.
withTimeoutOrNull(10.milliseconds) { callExternal() }
    ?: throw ExternalApiTimeoutException("외부 API 응답 없음")
5. 타임아웃 값 정하기
5-1. 지연 시간 분포에서 출발한다
AWS 는 허용할 오탐 비율(예: 0.1%)을 먼저 정하고 하위 서비스 지연 시간의 해당 백분위수(p99.9)를 타임아웃으로 쓴다고 한다. 앞의 AWS 스크린샷 마지막 문단에 나오는 내용이다. 인터넷을 건너는 호출이면 네트워크 최악값을 더한다. p50 과 p99.9 가 거의 같은 서비스라면 여유를 조금 둔다.
외부 API 라면 우리 쪽에서 잰 응답 시간 분포(APM, 로그의 소요 시간)를 보고 정하면 된다. 상대가 문서에 처리 시간 SLA 를 적어 뒀다면 그보다 짧게 잡을 이유는 없다.
5-2. 바깥 층이 안쪽 층보다 길어야 한다
요청은 여러 층을 지난다(클라이언트 → 로드밸런서 → 우리 서버 → 외부 API). 층마다 타임아웃이 있고 순서가 맞아야 한다.
사용자 앱 타임아웃     10s
  └ 로드밸런서 idle    60s   (AWS ALB 기본값)
      └ 우리 서버 → 외부 API callTimeout  3s
          └ 커넥션 풀 대기  1s
안쪽이 바깥보다 길면 아무도 기다리지 않는 작업을 계속하게 된다. 사용자 앱은 10초에 포기했는데 서버가 외부 API 를 30초 기다린다면 그 20초 동안 쥐고 있는 스레드와 커넥션은 낭비다. 사용자가 다시 시도하면 같은 작업이 하나 더 쌓인다.
5-3. 요청 전체 예산을 나눠 쓴다
한 요청 안에서 외부 호출을 여러 번 한다면 호출마다 고정 타임아웃만 주는 것으로는 부족하다. 500ms 씩 세 번이면 최악의 경우 1.5초가 된다. 요청 전체의 예산(deadline)을 정하고 각 호출은 남은 시간 안에서만 기다리게 할 수 있다. gRPC 의 deadline 이 이 방식이다.
import kotlinx.coroutines.*
import kotlin.time.Duration
import kotlin.time.Duration.Companion.milliseconds
import kotlin.time.TimeSource

// 요청 하나에 주어진 전체 예산. 하위 호출은 "남은 시간" 안에서만 기다린다.
class Deadline(budget: Duration) {
    private val end = TimeSource.Monotonic.markNow() + budget
    fun remaining(): Duration = -end.elapsedNow()
}

suspend fun <T> Deadline.call(name: String, cap: Duration, block: suspend () -> T): T {
    val timeout = minOf(cap, remaining())
    println("  $name: 제한 ${timeout.inWholeMilliseconds}ms")
    return withTimeout(timeout) { block() }
}

fun main() = runBlocking {
    val deadline = Deadline(1_000.milliseconds)
    try {
        deadline.call("회원 조회", cap = 500.milliseconds) { delay(300) }
        deadline.call("쿠폰 조회", cap = 500.milliseconds) { delay(450) }
        deadline.call("재고 조회", cap = 500.milliseconds) { delay(400) }
        println("주문서 완성")
    } catch (e: TimeoutCancellationException) {
        println("예산 초과: ${e.message}")
    }
}
회원 조회: 제한 500ms
쿠폰 조회: 제한 500ms
재고 조회: 제한 233ms
예산 초과: Timed out waiting for 234 ms세 번째 호출은 자기 상한(500ms) 대신 남은 예산(233ms)만큼 기다렸다. 각 호출은 자기 상한 안에 들어왔지만 합이 예산을 넘어서 1초 시점에 끊겼다. 여기서는 delay 라서 withTimeout 이 통했다. 블로킹 클라이언트라면 4-1 처럼 남은 시간을 클라이언트의 요청별 타임아웃으로 넘겨야 한다.
6. 타임아웃 이후: 재시도
6-1. 끊긴 위치에 따라 재시도 여부가 갈린다
타임아웃의 결과는 "알 수 없음"이라서 재시도할지는 어디서 끊겼는지와 요청의 성격으로 정한다.
| 상황 | 상대가 처리했을 가능성 | 재시도 |
|---|---|---|
| connect timeout / connection refused | 없음 (요청이 도달하지 않음) | 해도 된다 |
| 풀 대기 타임아웃 | 없음 (요청이 나가지 않음) | 해도 되지만 풀 고갈 원인부터 본다 |
| read / call timeout, 조회(GET) | 있음, 부작용 없음 | 대체로 괜찮다 |
| read / call timeout, 결제·발송·생성 | 있음 | 멱등성이 보장될 때만 |
두 번째 질문(같은 요청이 두 번 처리되지 않을까)은 마지막 줄에 해당한다. AWS 글에도 같은 내용이 있다.
APIs with side effects aren't safe to retry unless they provide idempotency.
부작용이 있는 외부 API 라면 멱등키 지원 여부를 먼저 확인한다. 멱등키는 요청마다 고유한 키를 함께 보내서 상대가 중복을 걸러 주게 하는 방식이다(Idempotency-Key 헤더 등). 지원하지 않는다면 재시도 대신 상태 조회 API 로 결과를 확인한다.
6-2. 재시도는 부하를 늘린다
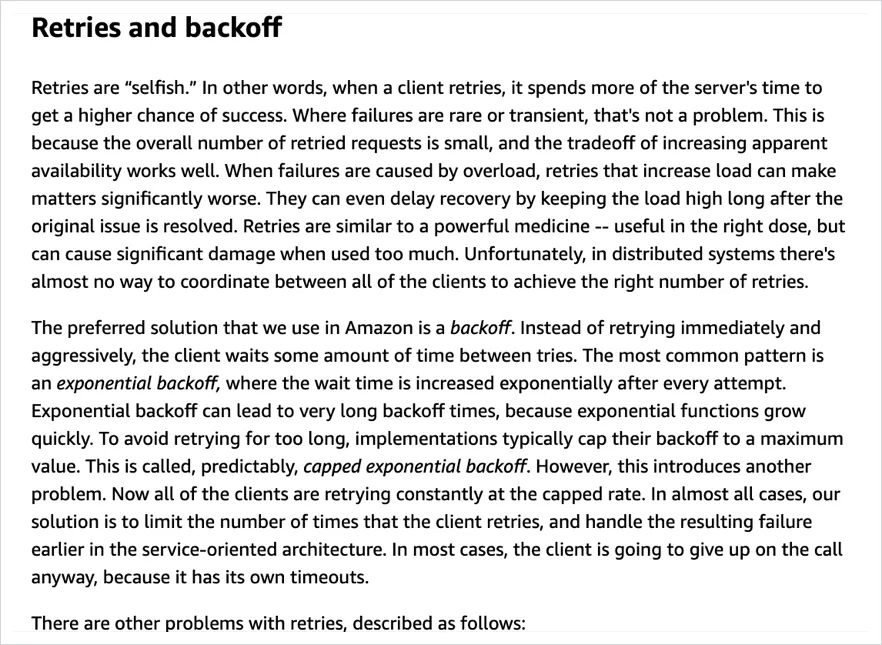
출처: AWS Builders' Library – Timeouts, retries, and backoff with jitter
Retries are "selfish." In other words, when a client retries, it spends more of the server's time to get a higher chance of success.
상대가 과부하로 느려진 상황이라면 재시도는 부하를 더한다. 같은 글에 나오는 예시로는 5단 호출 스택에서 층마다 독립적으로 3번씩 시도하면 맨 아래 DB 부하가 243배(3⁵)가 된다. 타임아웃이 짧고 재시도가 공격적일수록 하위 서비스의 일시적인 지연이 전체 장애로 번지기 쉽다.
그래서 재시도에는 보통 세 가지를 같이 둔다.
- 횟수 제한: 2~3회. 가능하면 한 층에서만 재시도한다.
- 지수 백오프: 재시도 간격을 100ms, 200ms, 400ms 처럼 늘리고 상한을 둔다.
- 지터(jitter): 간격에 무작위 값을 섞어 여러 클라이언트의 재시도가 한꺼번에 몰리지 않게 한다.
import kotlinx.coroutines.*
import java.net.SocketTimeoutException
import kotlin.random.Random
import kotlin.time.Duration
import kotlin.time.Duration.Companion.milliseconds

suspend fun <T> retryWithBackoff(
    maxAttempts: Int = 3,
    base: Duration = 100.milliseconds,
    cap: Duration = 2_000.milliseconds,
    retryable: (Throwable) -> Boolean,
    block: suspend (attempt: Int) -> T,
): T {
    var attempt = 1
    while (true) {
        try {
            return block(attempt)
        } catch (e: CancellationException) {
            throw e                                   // 취소·상위 타임아웃은 재시도하지 않는다
        } catch (e: Exception) {
            if (attempt >= maxAttempts || !retryable(e)) throw e
            // Full Jitter: 0 ~ min(cap, base * 2^(attempt-1)) 사이에서 무작위로 기다린다
            val ceiling = minOf(cap, base * (1 shl (attempt - 1)))
            val wait = Random.nextLong(ceiling.inWholeMilliseconds + 1).milliseconds
            println("  #$attempt 실패(${e::class.simpleName}) → ${wait.inWholeMilliseconds}ms 뒤 재시도")
            delay(wait)
            attempt++
        }
    }
}

fun main() = runBlocking {
    val result = retryWithBackoff(retryable = { it is SocketTimeoutException }) { attempt ->
        if (attempt < 3) throw SocketTimeoutException("Read timed out")
        "OK (시도 $attempt)"
    }
    println(result)
}
#1 실패(SocketTimeoutException) → 36ms 뒤 재시도
#2 실패(SocketTimeoutException) → 12ms 뒤 재시도
OK (시도 3)CancellationException을 먼저 잡아 그대로 던진다. 이게 없으면 바깥 예산이 끝난 뒤에도 재시도가 계속된다(4-2).- 재시도할 예외는
retryable로 명시한다. 모든 예외를 재시도하면 400 Bad Request 같은 영구 실패도 세 번씩 보낸다.
실서비스에서는 Resilience4j 의 Retry·CircuitBreaker 나 Spring Retry 를 쓰는 경우가 많다. 서킷 브레이커를 같이 두면 상대가 계속 실패할 때 호출을 멈추고 바로 실패시킨다. 그러면 외부 API 장애 동안 우리 서버 스레드가 타임아웃만 기다리며 쌓이는 것을 막을 수 있다.
7. 정리
들어가며의 질문에 답을 달아 보면 이렇다.
- 타임아웃이 났을 때 상대는 처리했을까: 알 수 없다. connect 단계에서 끊겼다면 처리되지 않았고 read 단계라면 처리됐을 수 있다. 로그에 예외 종류(
ConnectException,Connect timed out,Read timed out)를 구분해 남긴다. - 재시도해도 될까: 조회이거나 멱등키가 있을 때만 한다. 아니면 상태 조회로 확인한다. 재시도에는 횟수 제한, 백오프, 지터를 둔다.
- 우리 타임아웃은 몇 초였을까: 기본값을 확인하고 직접 적는다. OkHttp
callTimeout, PgJDBCsocketTimeout은 기본이 무제한이다. connect·read·전체 세 가지를 모두 정한다. withTimeout이 왜 안 먹을까: 코루틴 취소는 협조적이다. 블로킹 호출은 클라이언트 타임아웃으로 끊고CancellationException은 삼키지 않는다.
값을 정할 때 기준으로 삼을 것들:
- 하위 서비스의 지연 분포(p99, p99.9)를 보고 정한다.
- 바깥 층을 안쪽 층보다 길게 둔다.
- 한 요청 안에서 여러 번 호출하면 예산을 나눠 쓴다.
- 커넥션 풀 대기 타임아웃은 짧게 둔다.
타임아웃은 설정값 하나지만 얼마나 기다릴지, 포기한 뒤 무엇을 할지까지 함께 정해야 의미가 있다. 다음에 Read timed out 로그를 보면 어느 단계에서 끊겼고 그 요청이 어떻게 됐는지까지 확인해 볼 생각이다.
참고 자료
- Kotlin docs – Cancellation and timeouts
- kotlinx.coroutines –
withTimeout소스와 KDoc (Timeout.kt) - AWS Builders' Library – Timeouts, retries, and backoff with jitter
- Ktor – Timeout
- OkHttp – OkHttpClient.kt (타임아웃 기본값과 KDoc)
- Spring Framework – WebClient Configuration › Timeouts
- HikariCP README – Configuration
- PostgreSQL JDBC – Connection Parameters
댓글
댓글을 불러오는 중…