00시, 새로 뜬 pod 만 무너졌다 – 프로파일러로 Spring Data 의 숨은 락을 찾고, 고친 뒤에도 무너진 이유까지
성능 개선
목록 보기숨기기1/2
- 00시, 새로 뜬 pod 만 무너졌다 – 프로파일러로 Spring Data 의 숨은 락을 찾고, 고친 뒤에도 무너진 이유까지
- 5KB 응답을 만들려고 2.5MB 를 읽던 홈 API – 모니터링으로 원인을 좁히고, DataLoader·projection·2중 캐시로 32배
이 글의 수치는 모두 로컬 재현 환경에서 잰 값이다. 코드 수정·캐시·동시성 제한은 로컬에서 실험으로 구현해 측정했고 운영에는 아직 반영하지 않았다. 흐름은 토스 SLASH 23 「프로파일러로 시스템 성능 향상시키기」를 참고했다 — 추측 대신 프로파일러로 근거를 잡고, 고치고, 다시 잰다.
0. 재현 환경
| 항목 | 값 | 이유 |
|---|---|---|
| 서버 | API 서버 컨테이너 CPU 1코어 · RAM 2GB | 운영 pod 의 requests(cpu 1, memory 2Gi) |
| 데이터 | dev Postgres·Mongo 덤프를 로컬에 복원, 외부 연동은 WireMock | dev 에 부하를 주지 않는다 |
| 부하 | k6 ramping-arrival-rate, 9개 오퍼레이션을 실제 00시 비율로, 10초 만에 200/s 로 올려 3분 유지 | 00시 급증 재현. 도착률 기반이라 서버가 느려져도 요청 속도는 유지된다 |
| 막 띄운 서버 | 새 컨테이너가 healthy 가 된 뒤 40초 쉬고 바로 부하 | 00시에 HPA 가 새 pod 를 띄우는 상황 |
| 관측 | Prometheus(앱 actuator + k6 remote write, k6 지연은 네이티브 히스토그램) · Grafana · async-profiler 4.1 | k6 의 trend 통계는 시작부터 누적이라 구간별 p95 를 보려고 네이티브 히스토그램을 켰다 |
1. 증상 — 모니터링이 보여 준 것과 보여 주지 못한 것
막 띄운 서버는 처리량 119/s · 실패 8% · getExhibition p95 2분(타임아웃)으로 무너졌다. 대시보드에서 세 가지가 보였다.
- CPU 는 100% 인데 처리량은 목표의 60%. 일을 많이 하는데 처리는 못 한다.
- runnable 스레드는 거의 그대로인데 waiting 스레드만 폭증. 무언가를 기다리고 있다.
- 서버 지표가 2분 넘게 비어 있다. 서버가 Prometheus 의 5초 주기 수집에도 답하지 못했다. 정작 장애 구간에서 모니터링이 눈을 감는다.
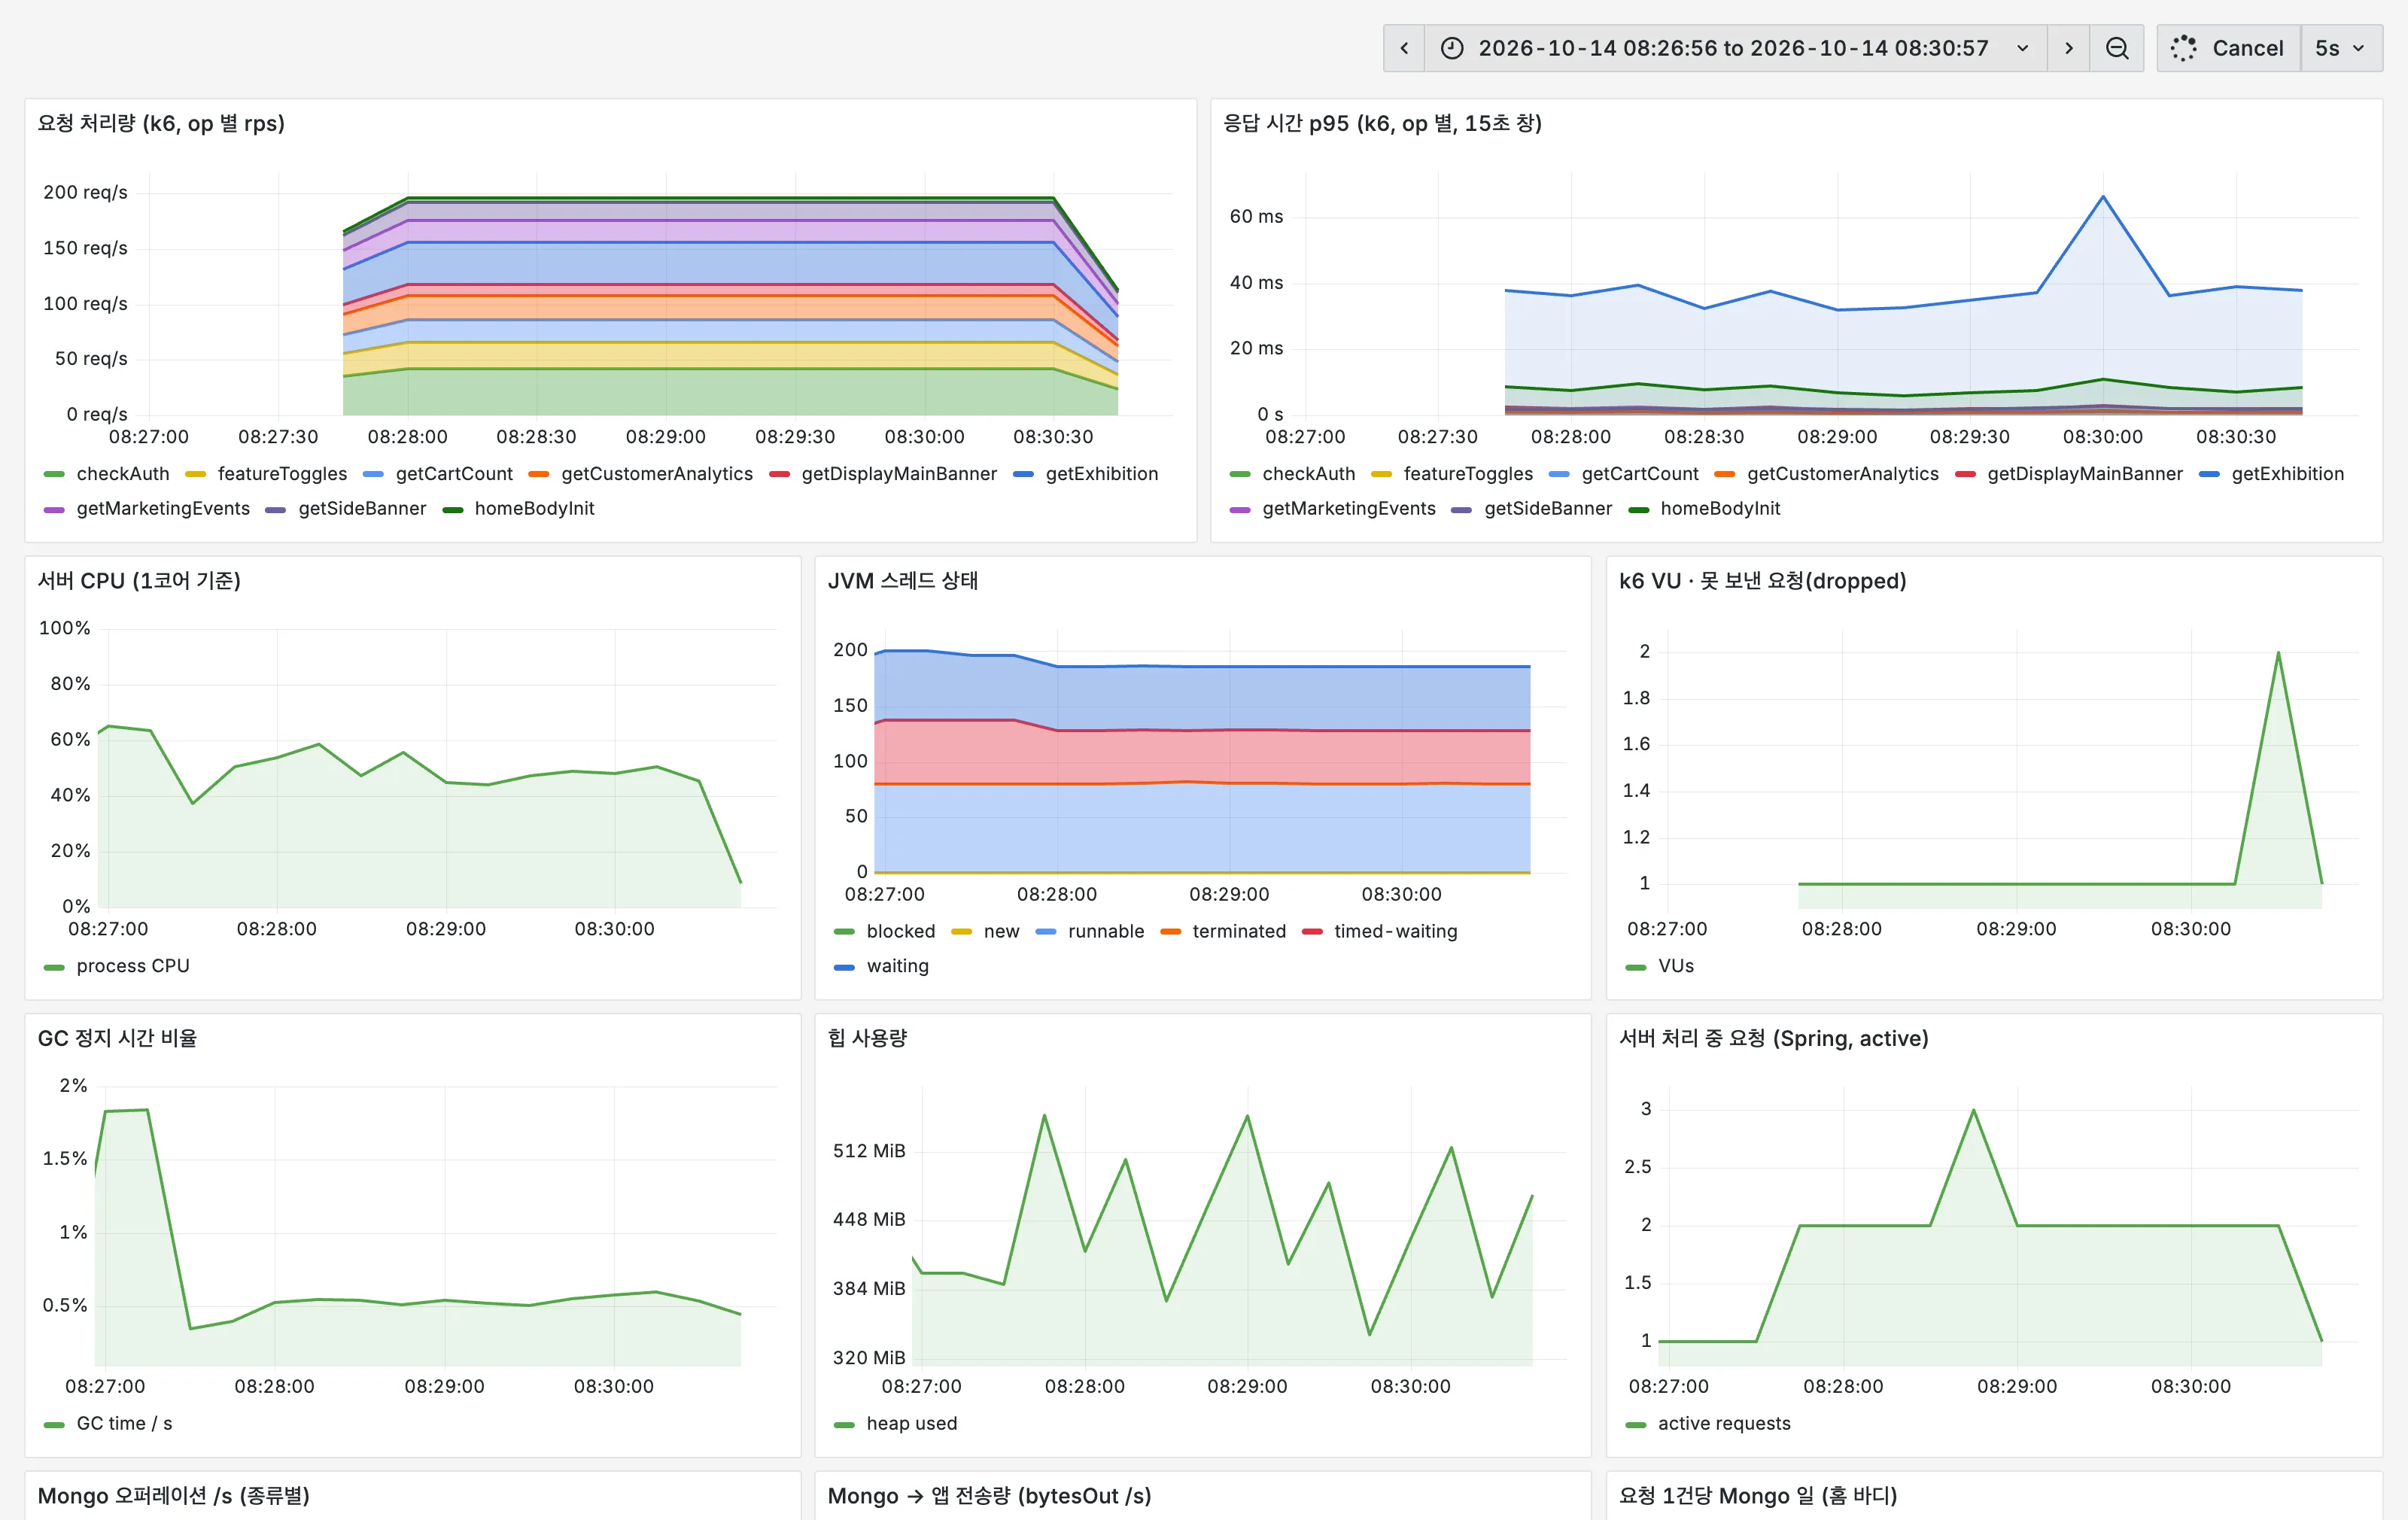
같은 코드를 데운 서버는 191/s · 실패 0% · p95 38ms 로 여유 있게 버텼다. 그러니 "서버가 부족하다"가 아니라 "막 뜬 JVM 에서만 커지는 무언가"가 있다. 그런데 그 무언가는 대시보드에 없다. 스레드가 기다린다는 건 알겠는데 무엇을 기다리는지는 모른다. 여기서부터는 프로파일러의 일이다.
측정 함정 하나 — 처음에는 데운 서버도 162/s 로 밀렸다. 워밍업을 20/s 로 너무 약하게 했고 프로파일러(lock 1ms + wall + itimer)를 켠 채 쟀기 때문이다. lock 프로파일러는 경합하는 락마다 끼어들어 바로 그 락 경합을 키운다. 그 뒤로는 수치를 재는 실험과 프로파일을 찍는 실험을 분리했다.
2. 프로파일러 — 무엇을 기다리나
async-profiler 를 컨테이너의 JVM(PID 1)에 붙여 부하 3분 동안 세 모드를 동시에 기록했다(-e itimer --wall 20ms --lock 1ms). 컨테이너의 perf_event_paranoid 가 2 라 CPU 는 perf 대신 itimer 로 잡았다.
| 모드 | 묻는 질문 | SimplePropertyPath.from 이 차지한 비율 |
|---|---|---|
| lock | 스레드가 어떤 락 앞에서 기다리나 | 96.3% |
| wall | 스레드가 시간을 어디에 쓰나(대기 포함) | 42.8% |
| cpu | CPU 를 어디에 쓰나 | 12.6% (+ 예외 스택 채우기 8.1%, 예외 생성 6.2%) |
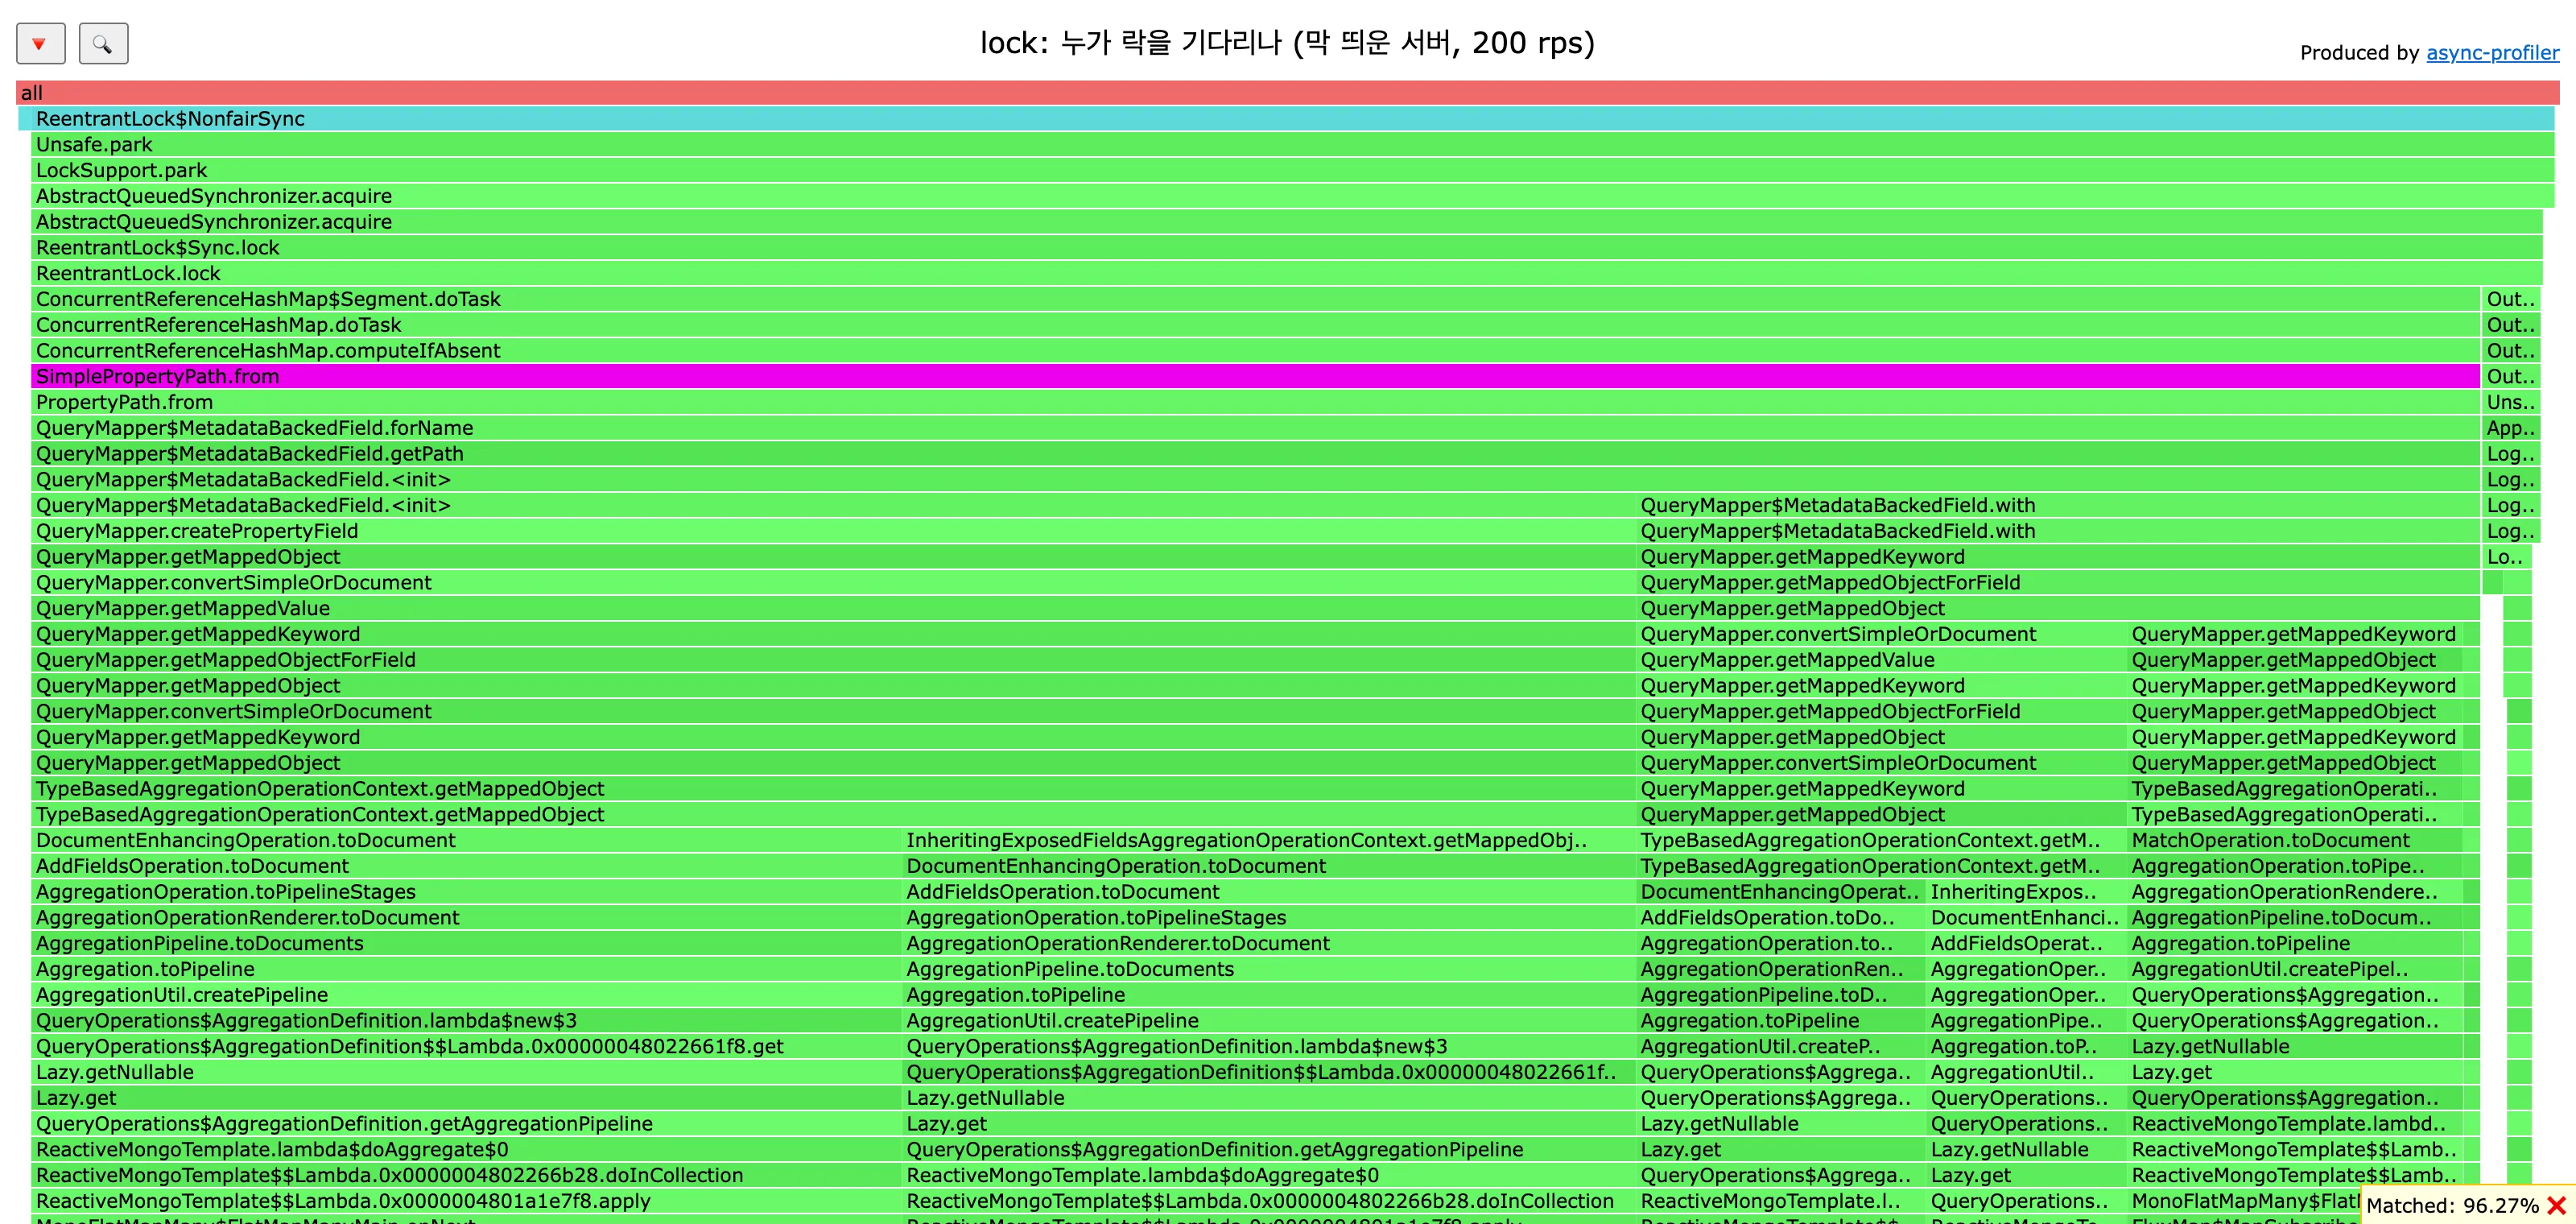
플레임그래프 읽는 팁 — 리액티브 스택은 1,000프레임 가까이 깊어 일반 플레임그래프는 세로로 수십 화면이 된다. jfrconv --lock --reverse --simple --minwidth 0.5 로 대기 지점부터 거꾸로 그리면 원인이 첫 화면에 들어온다.
2-1. 왜 그 락에 줄이 서나 — Spring 원문
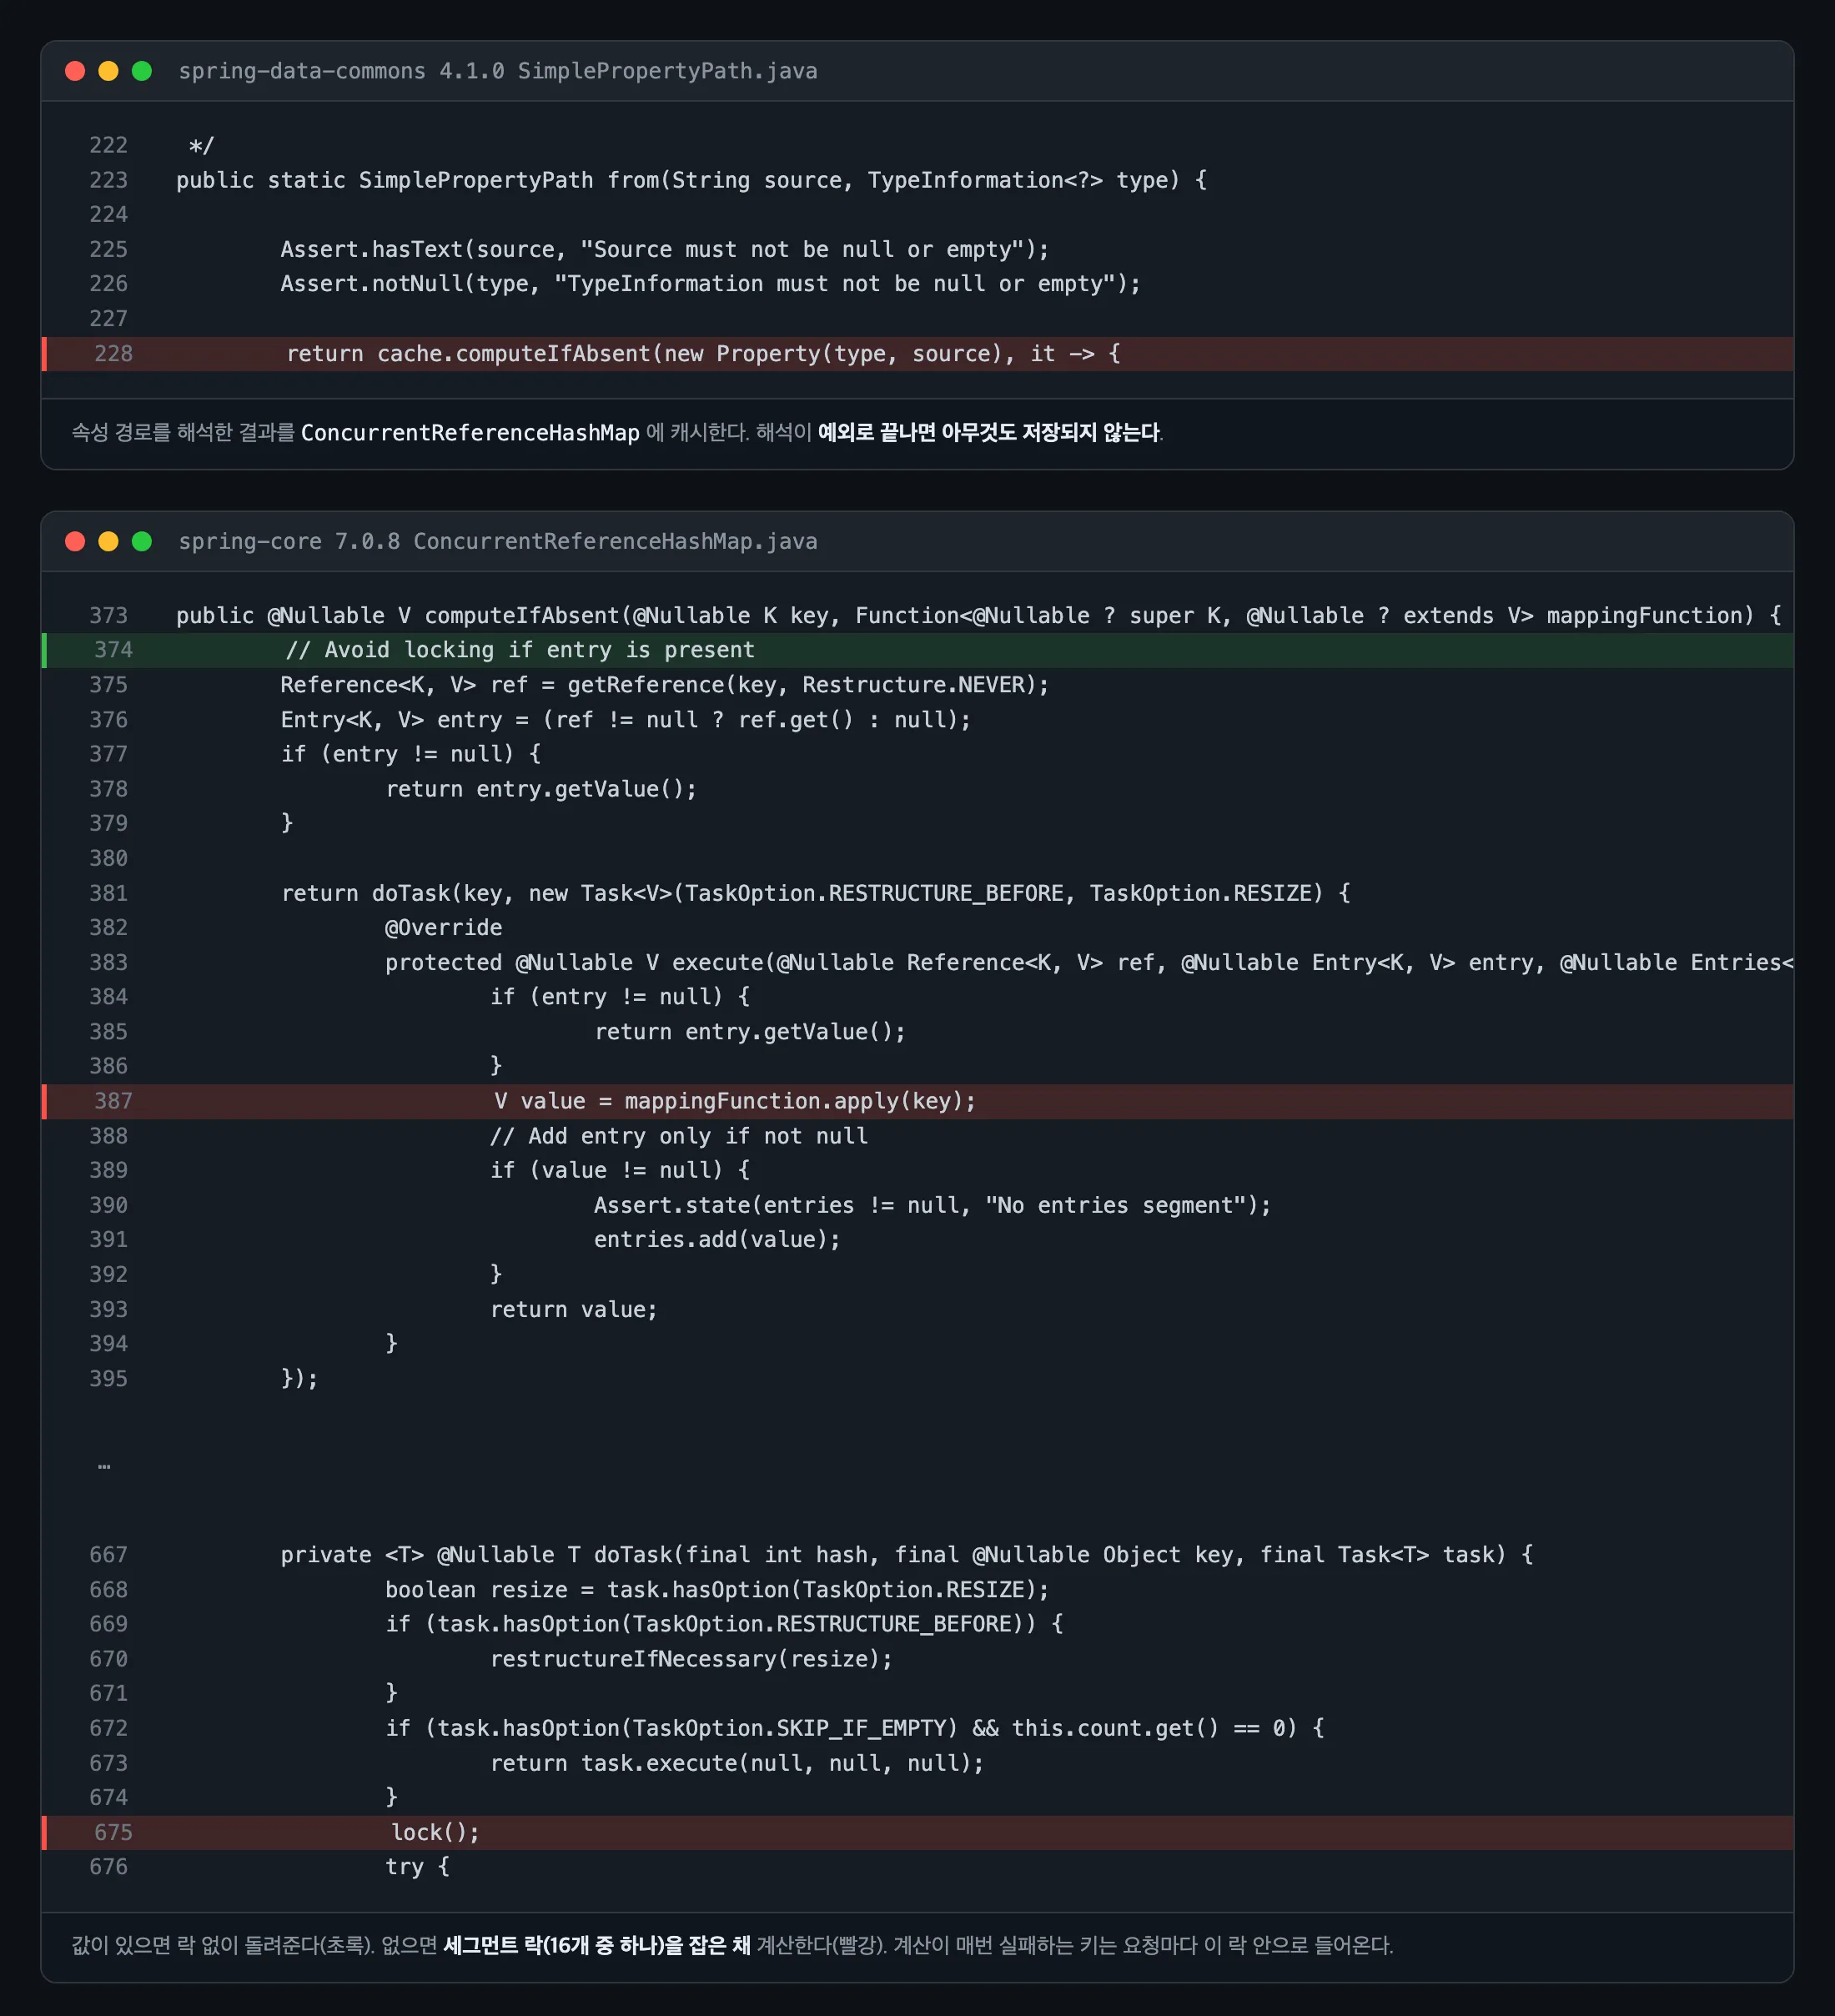
정리하면 이렇다.
- 해석이 성공하는 경로는 한 번 캐시되면 락 없이 읽힌다. 문제없다.
- 해석이 실패하는 경로는 영원히 캐시되지 않는다. 그 경로를 묻는 모든 요청이 세그먼트 락(16개 중 하나)을 잡고 다시 계산하고 다시 실패한다.
- 실패는
PropertyReferenceException이고 예외를 만들면 스택을 채운다. 리액티브 스택은 약 1,000프레임이라 이 비용이 크다. 그 비싼 일을 락을 잡은 채 한다. - 막 뜬 JVM 에서는 이 코드가 아직 JIT 되지 않아 더 느리다 → 락을 오래 잡는다 → 줄이 길어진다 → Mongo 드라이버의 콜백 스레드(상한 없음)가 계속 늘어난다 → 그만큼 더 느려진다. 한 번 밀리면 돌아오지 못하는 준안정 붕괴다.
2-2. 어떤 경로가 실패하나 — 우리 코드
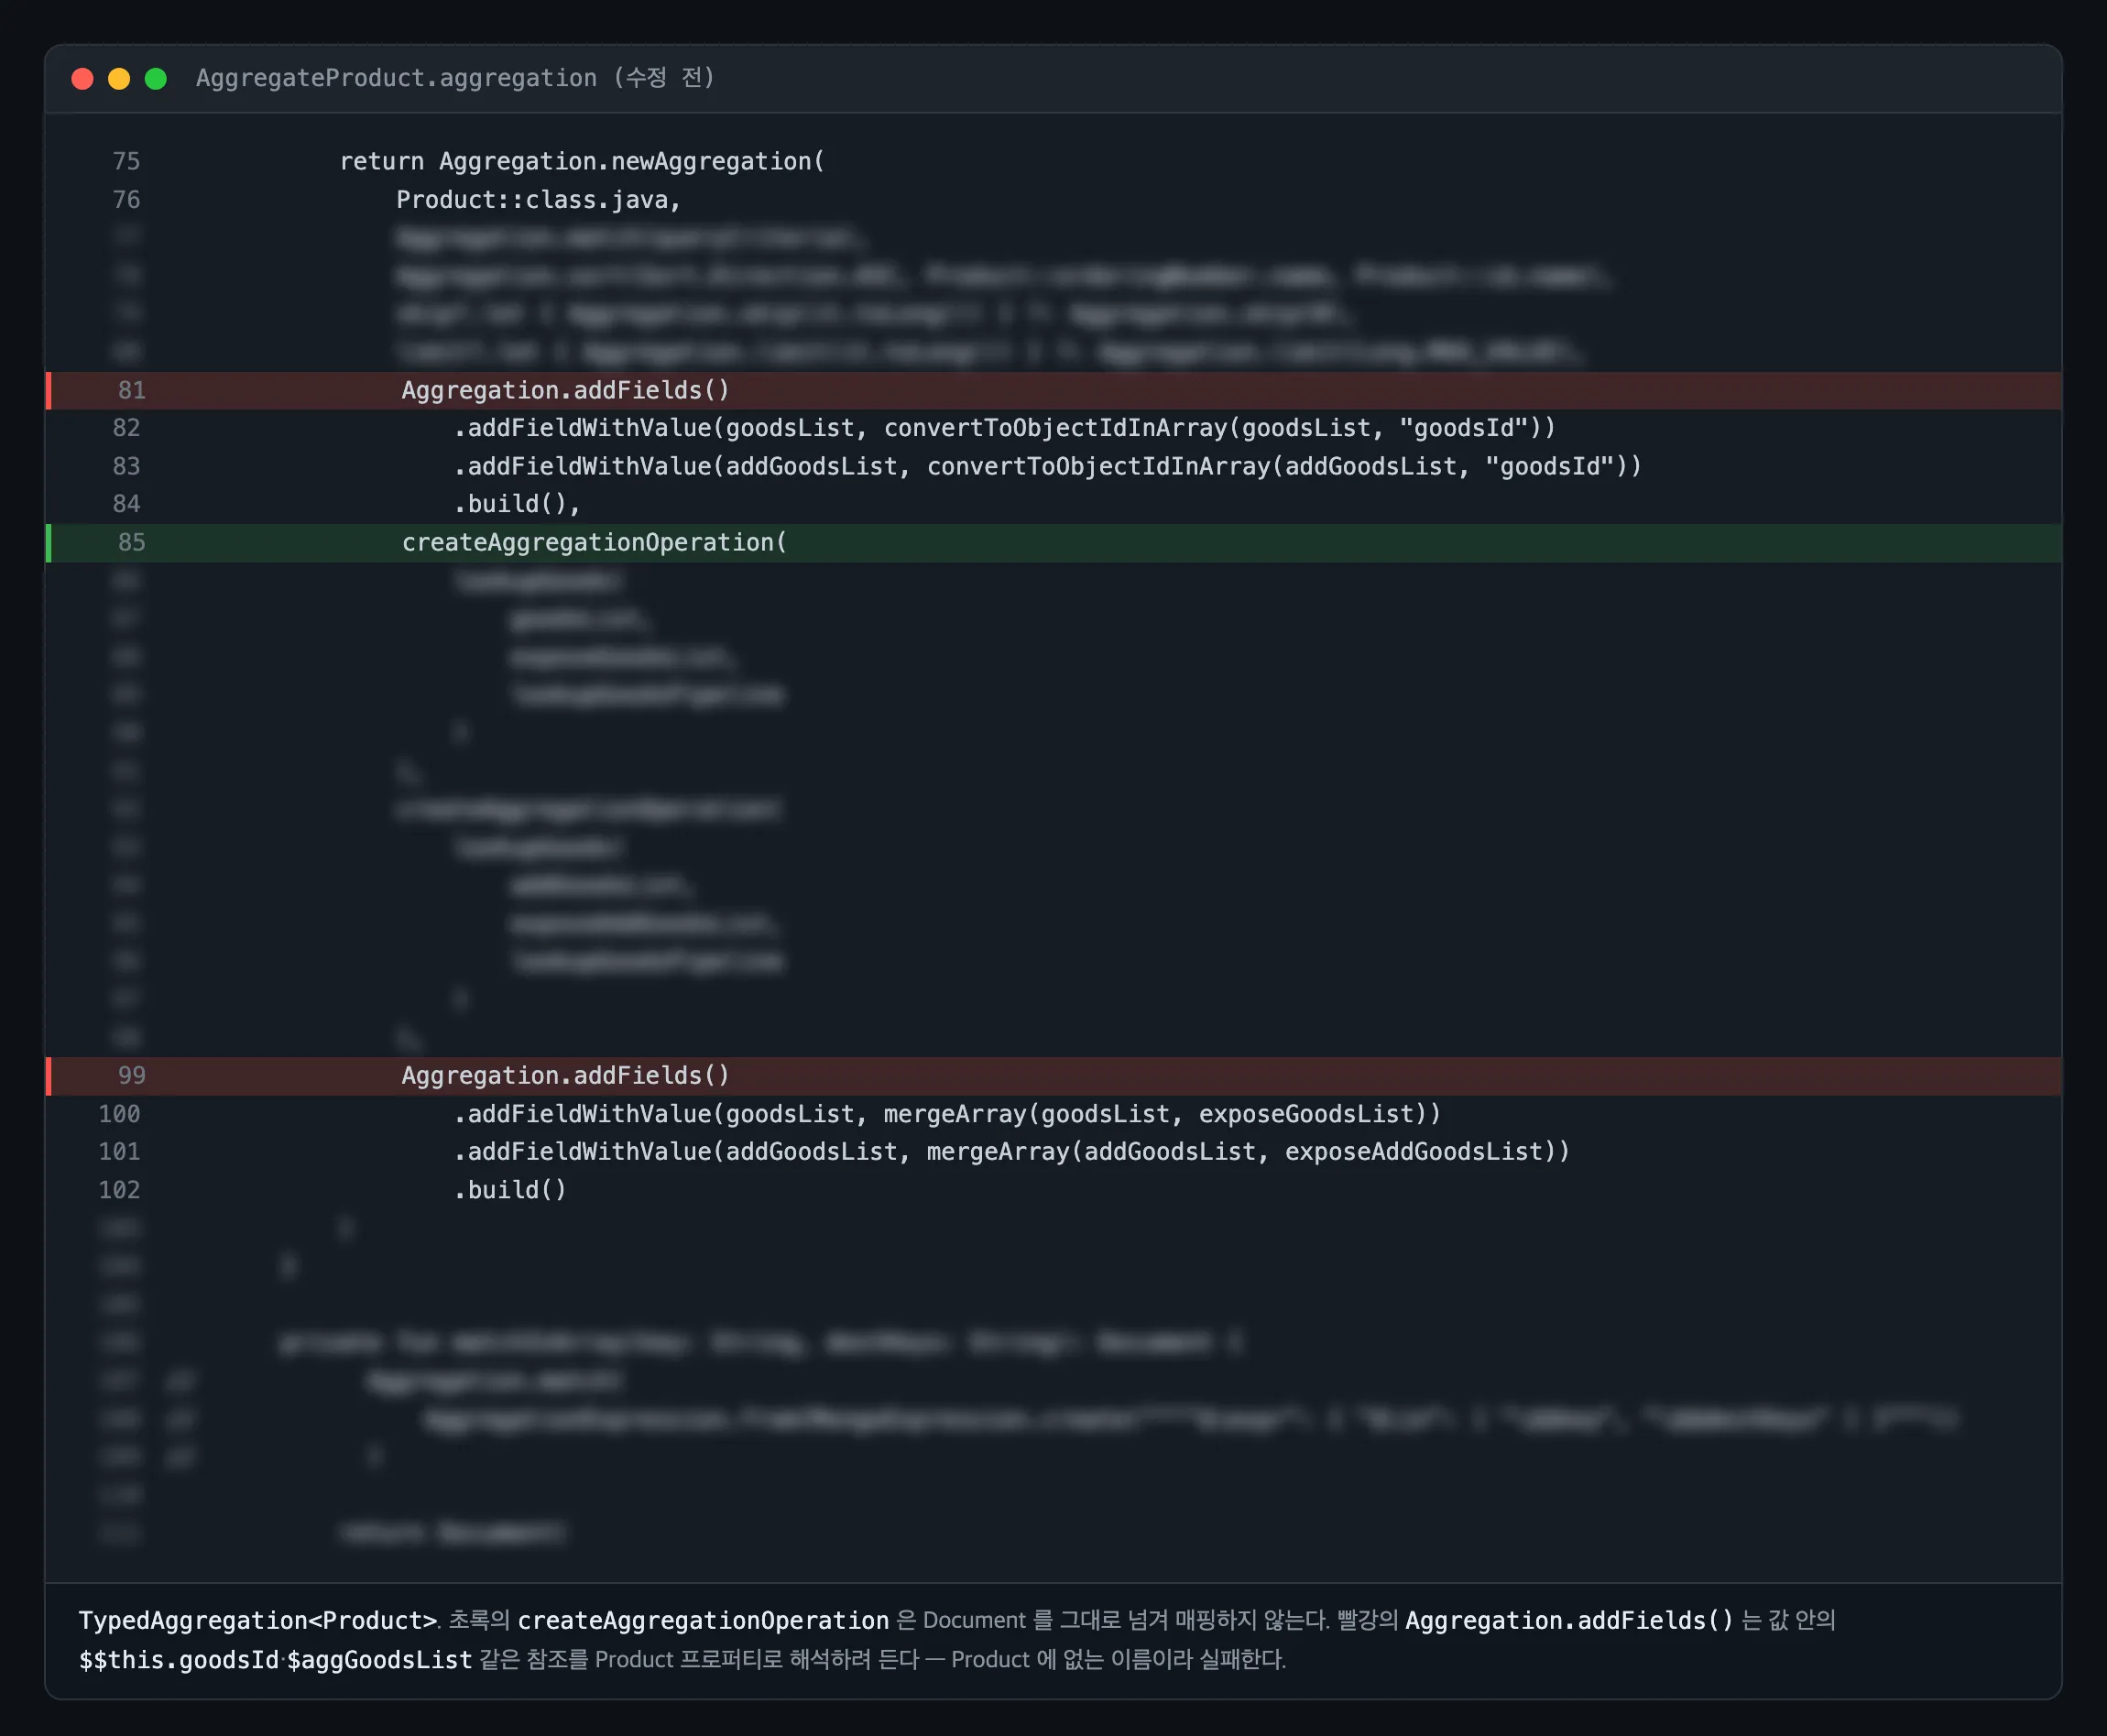
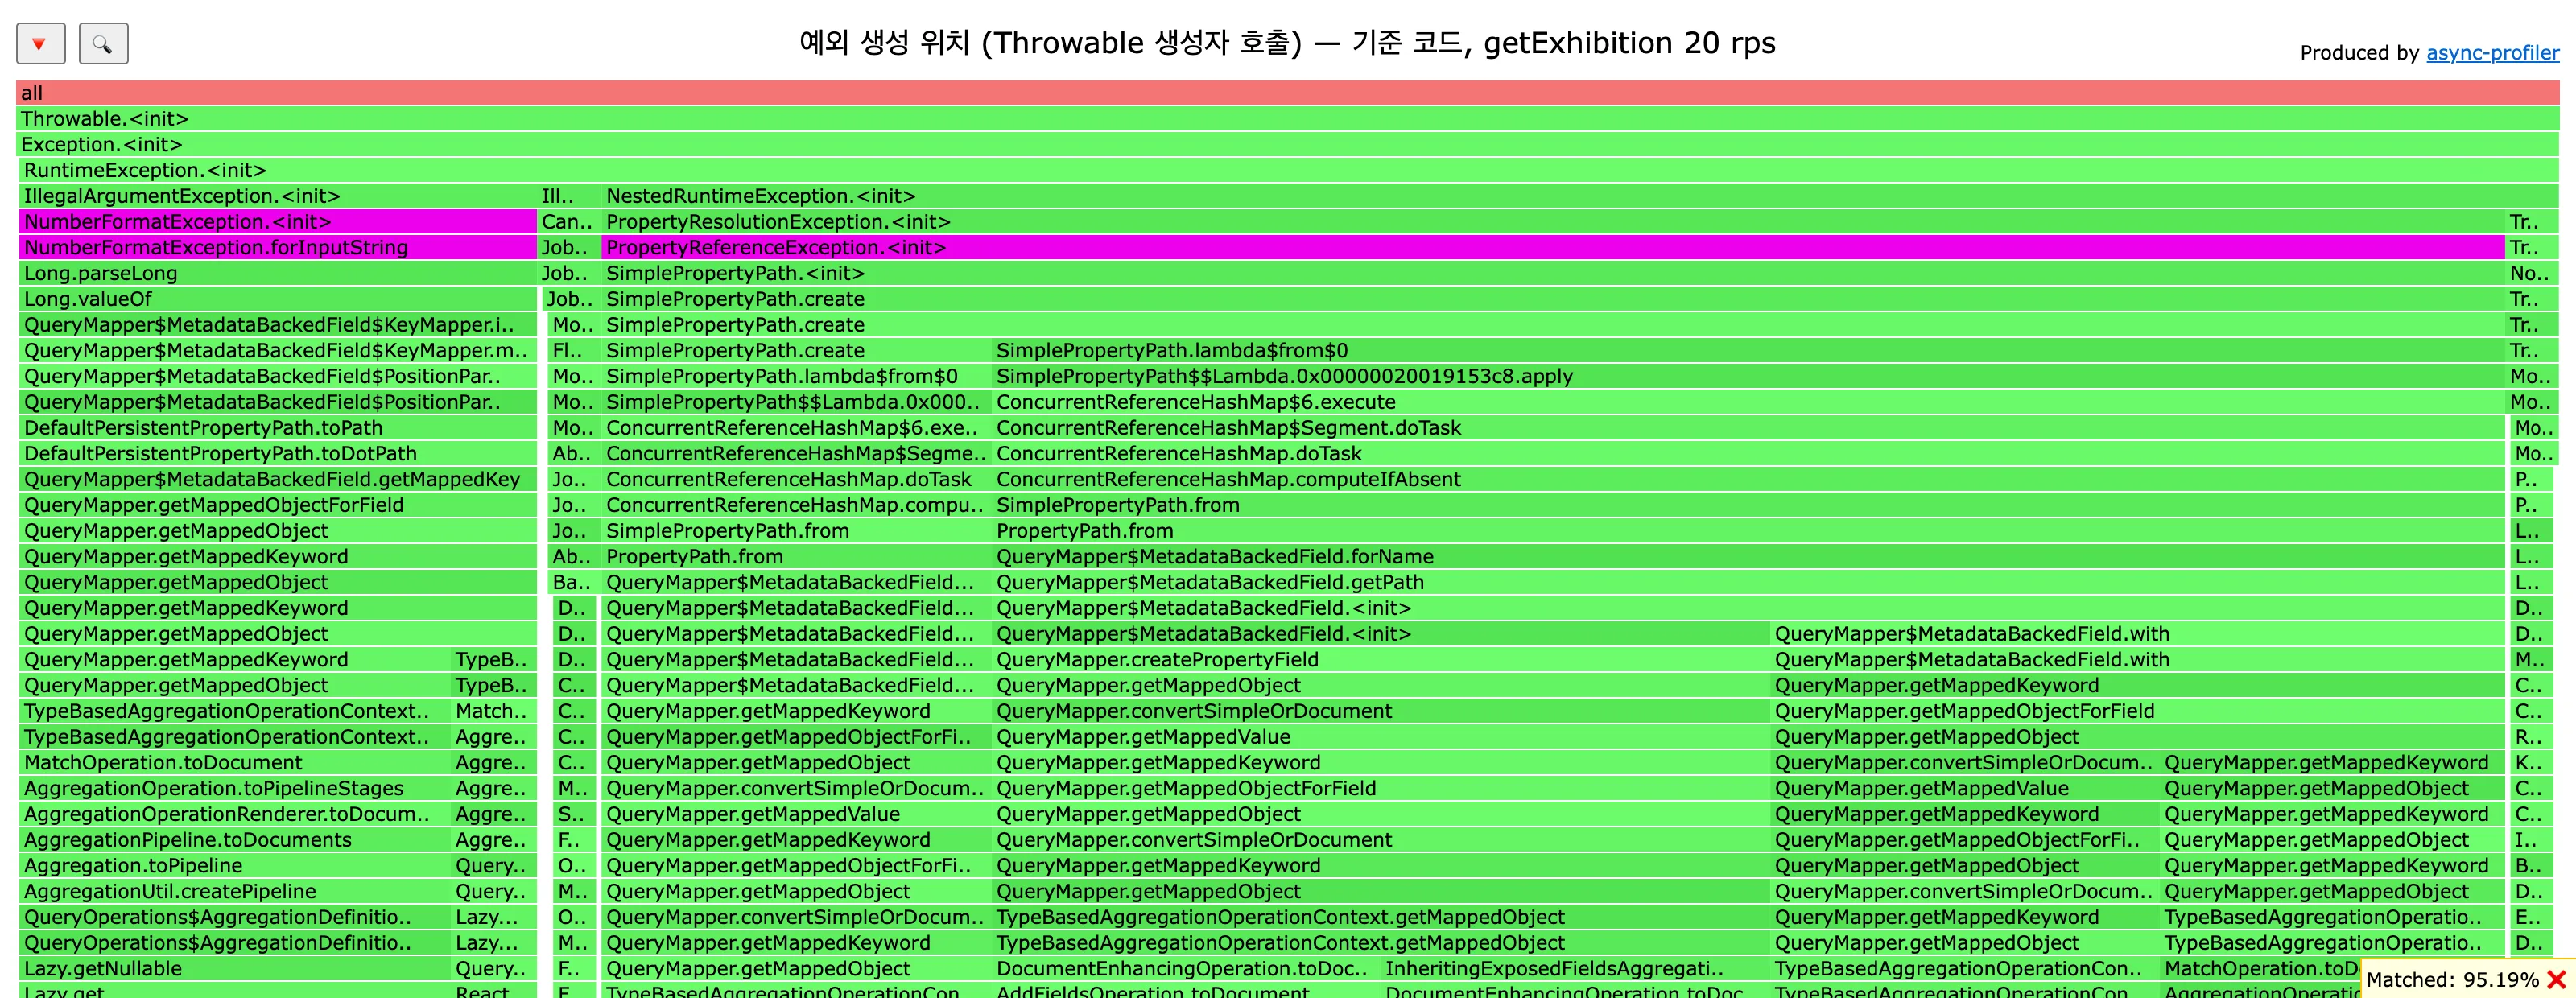
async-profiler 로 java.lang.Throwable.<init> 을 계측해(-e 'java.lang.Throwable.<init>' -i 1) 세어 보니 요청 468건에 예외 218,352개 — 요청당 약 467개였다. 기획전 하나에 상품그룹이 8개이고 GraphQL resolver 는 그룹마다 이 aggregation 을 순차로 한 번씩 부른다. aggregation 한 번에 수십 개, 요청 하나에 수백 개의 예외가 나온다.
3. 첫 번째 수정 — 그리고 "고친 줄 알았다"
$addFields 의 값은 이미 완성된 집계식이라 매핑이 필요 없다. 그래서 그 두 단계를 매핑을 거치지 않는 raw Document 로 바꿨다(코드는 4장의 스냅샷 10). 운영과 같은 문맥(TypeBasedAggregationOperationContext)으로 렌더링한 파이프라인과 결과가 같다는 것을 단위 테스트로 고정했다.
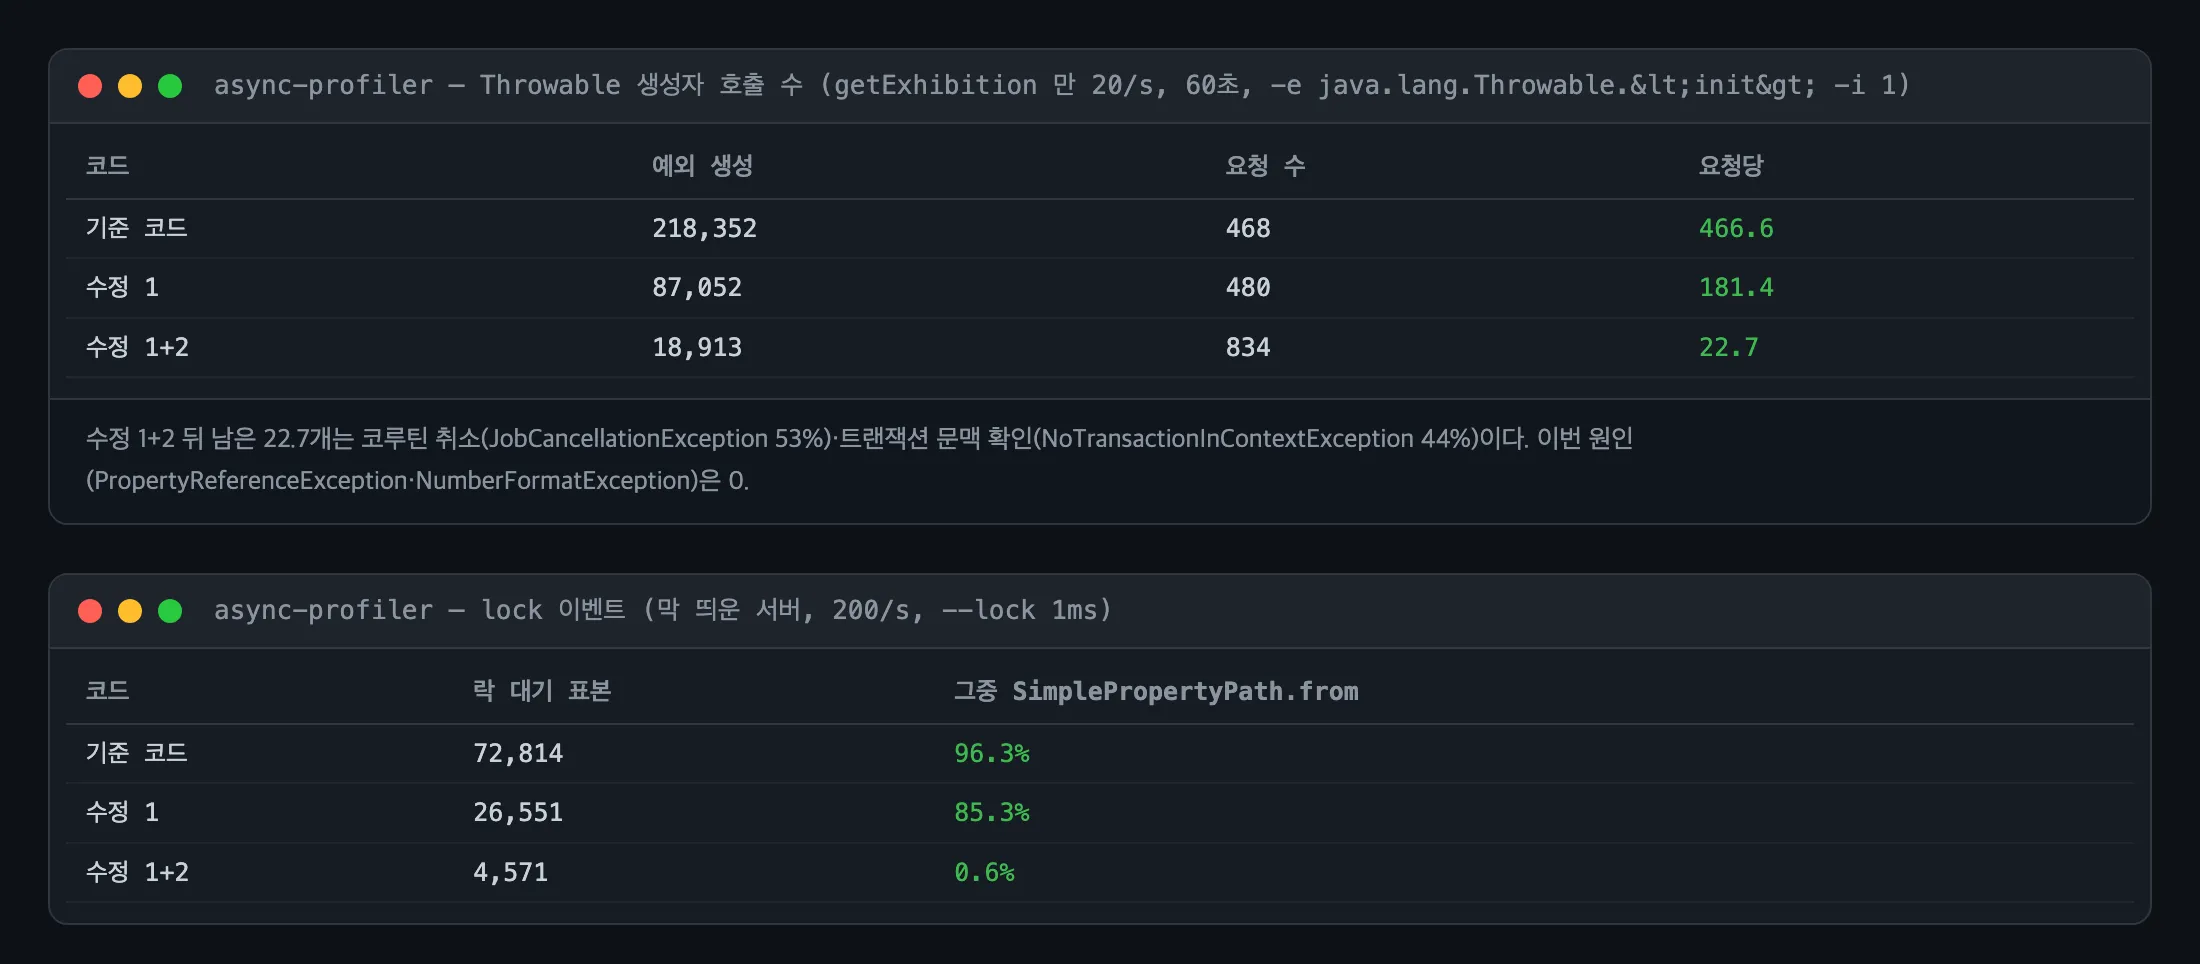
그리고 막 띄운 서버에 다시 200/s 를 걸었다. 여전히 무너졌다(130/s, 실패 7.3%, p95 2분). "예외 하나 없애면 끝"이라는 첫 가설은 절반만 맞았다. 다시 프로파일러를 붙였다.
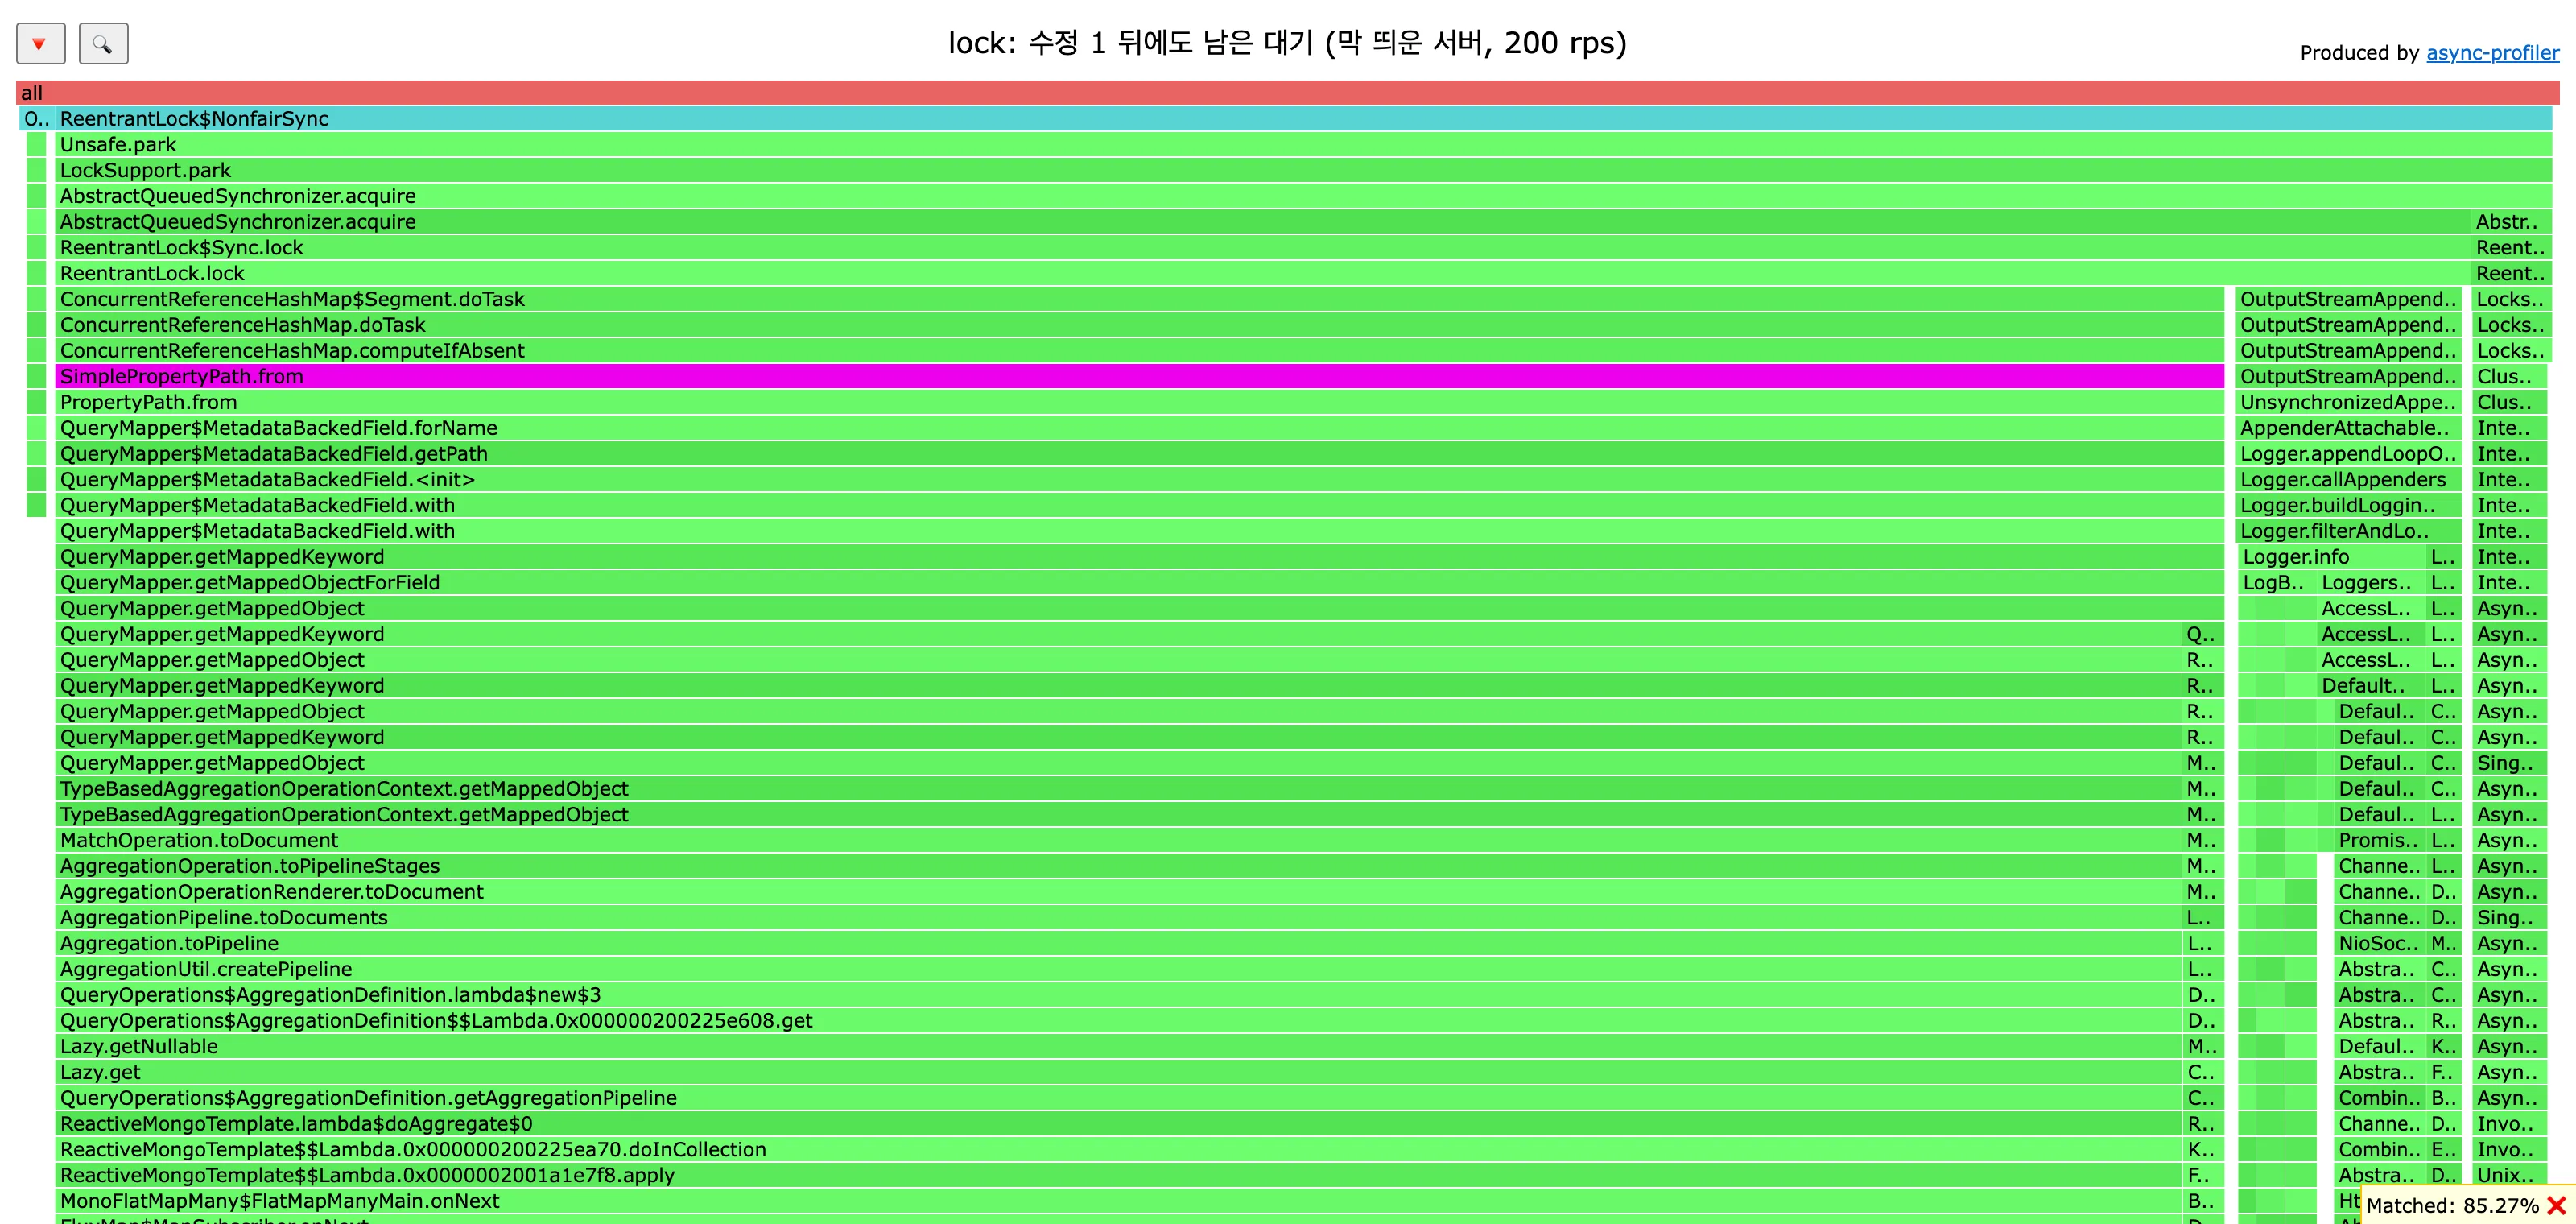
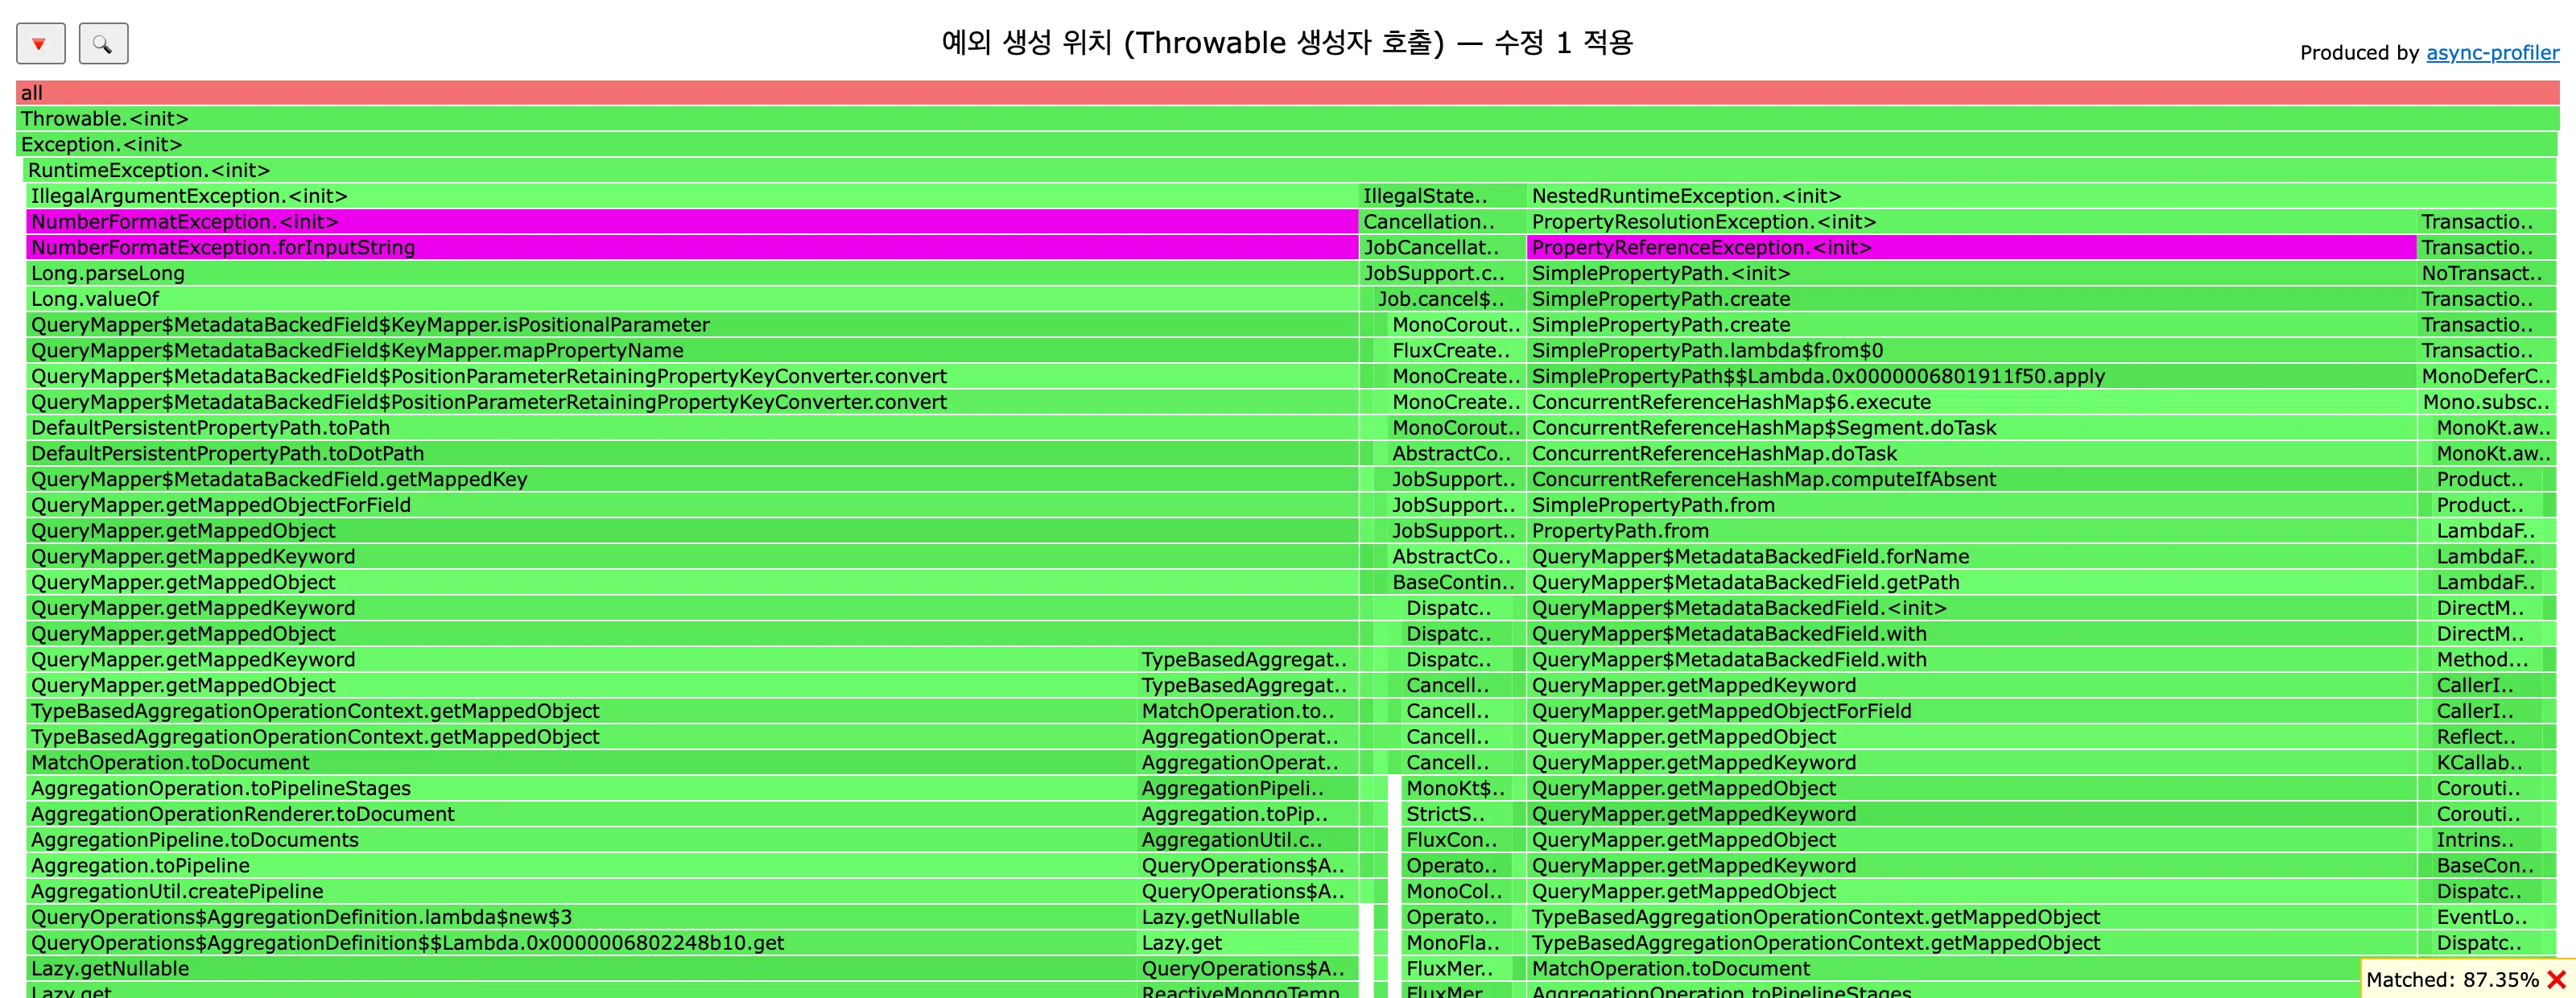
3-1. 남은 두 범인
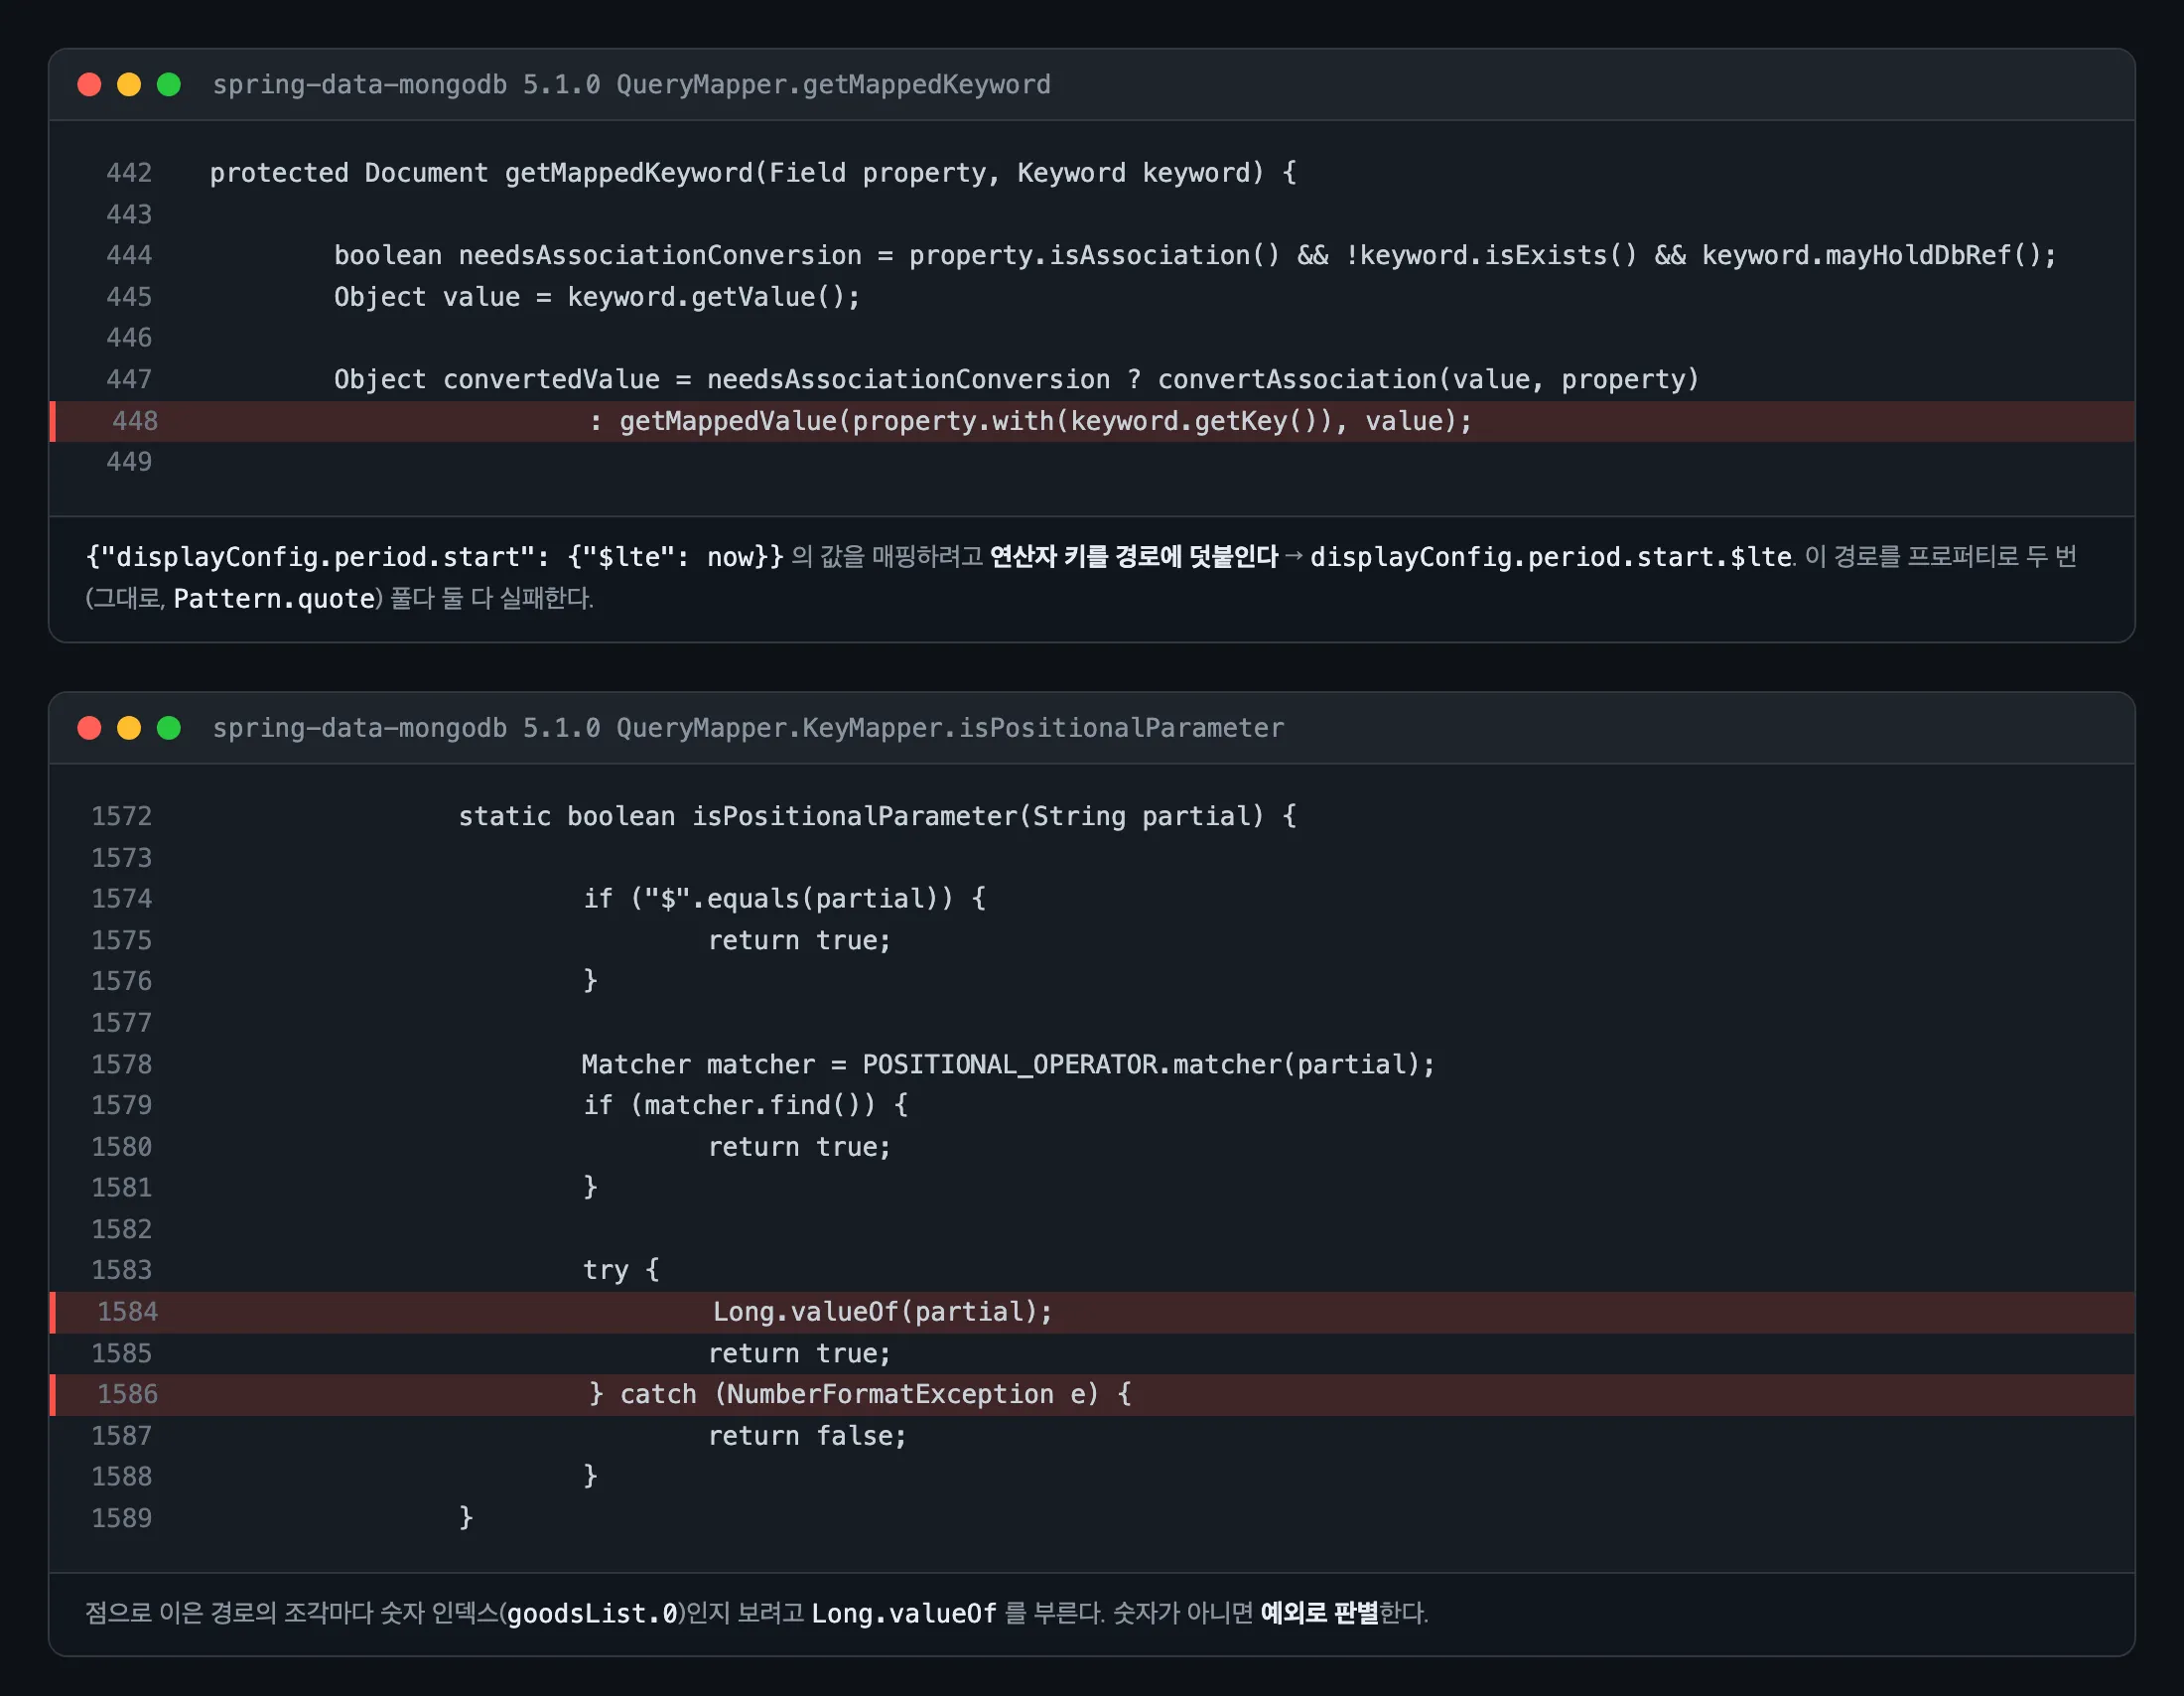
- 연산자를 경로에 붙인다:
{"displayConfig.period.start": {"$lte": now}}의 값을 매핑하려고property.with("$lte")를 부른다. 그러면displayConfig.period.start.$lte라는 경로가 생기고, 이걸 프로퍼티로 두 번(그대로,Pattern.quote) 풀다 둘 다 실패한다. 날짜 범위 조건 4개 × 2 = 렌더링당 8개. - 예외로 숫자를 판별한다: 점으로 이은 경로 조각마다 배열 인덱스인지 보려고
Long.valueOf를 부르고NumberFormatException으로 "숫자 아님"을 안다. 렌더링당 12개.
두 번째는 락과 상관없지만 예외 생성(스택 채우기) 비용은 똑같이 든다.
4. 두 번째 수정 — 예외 0, 그런데도
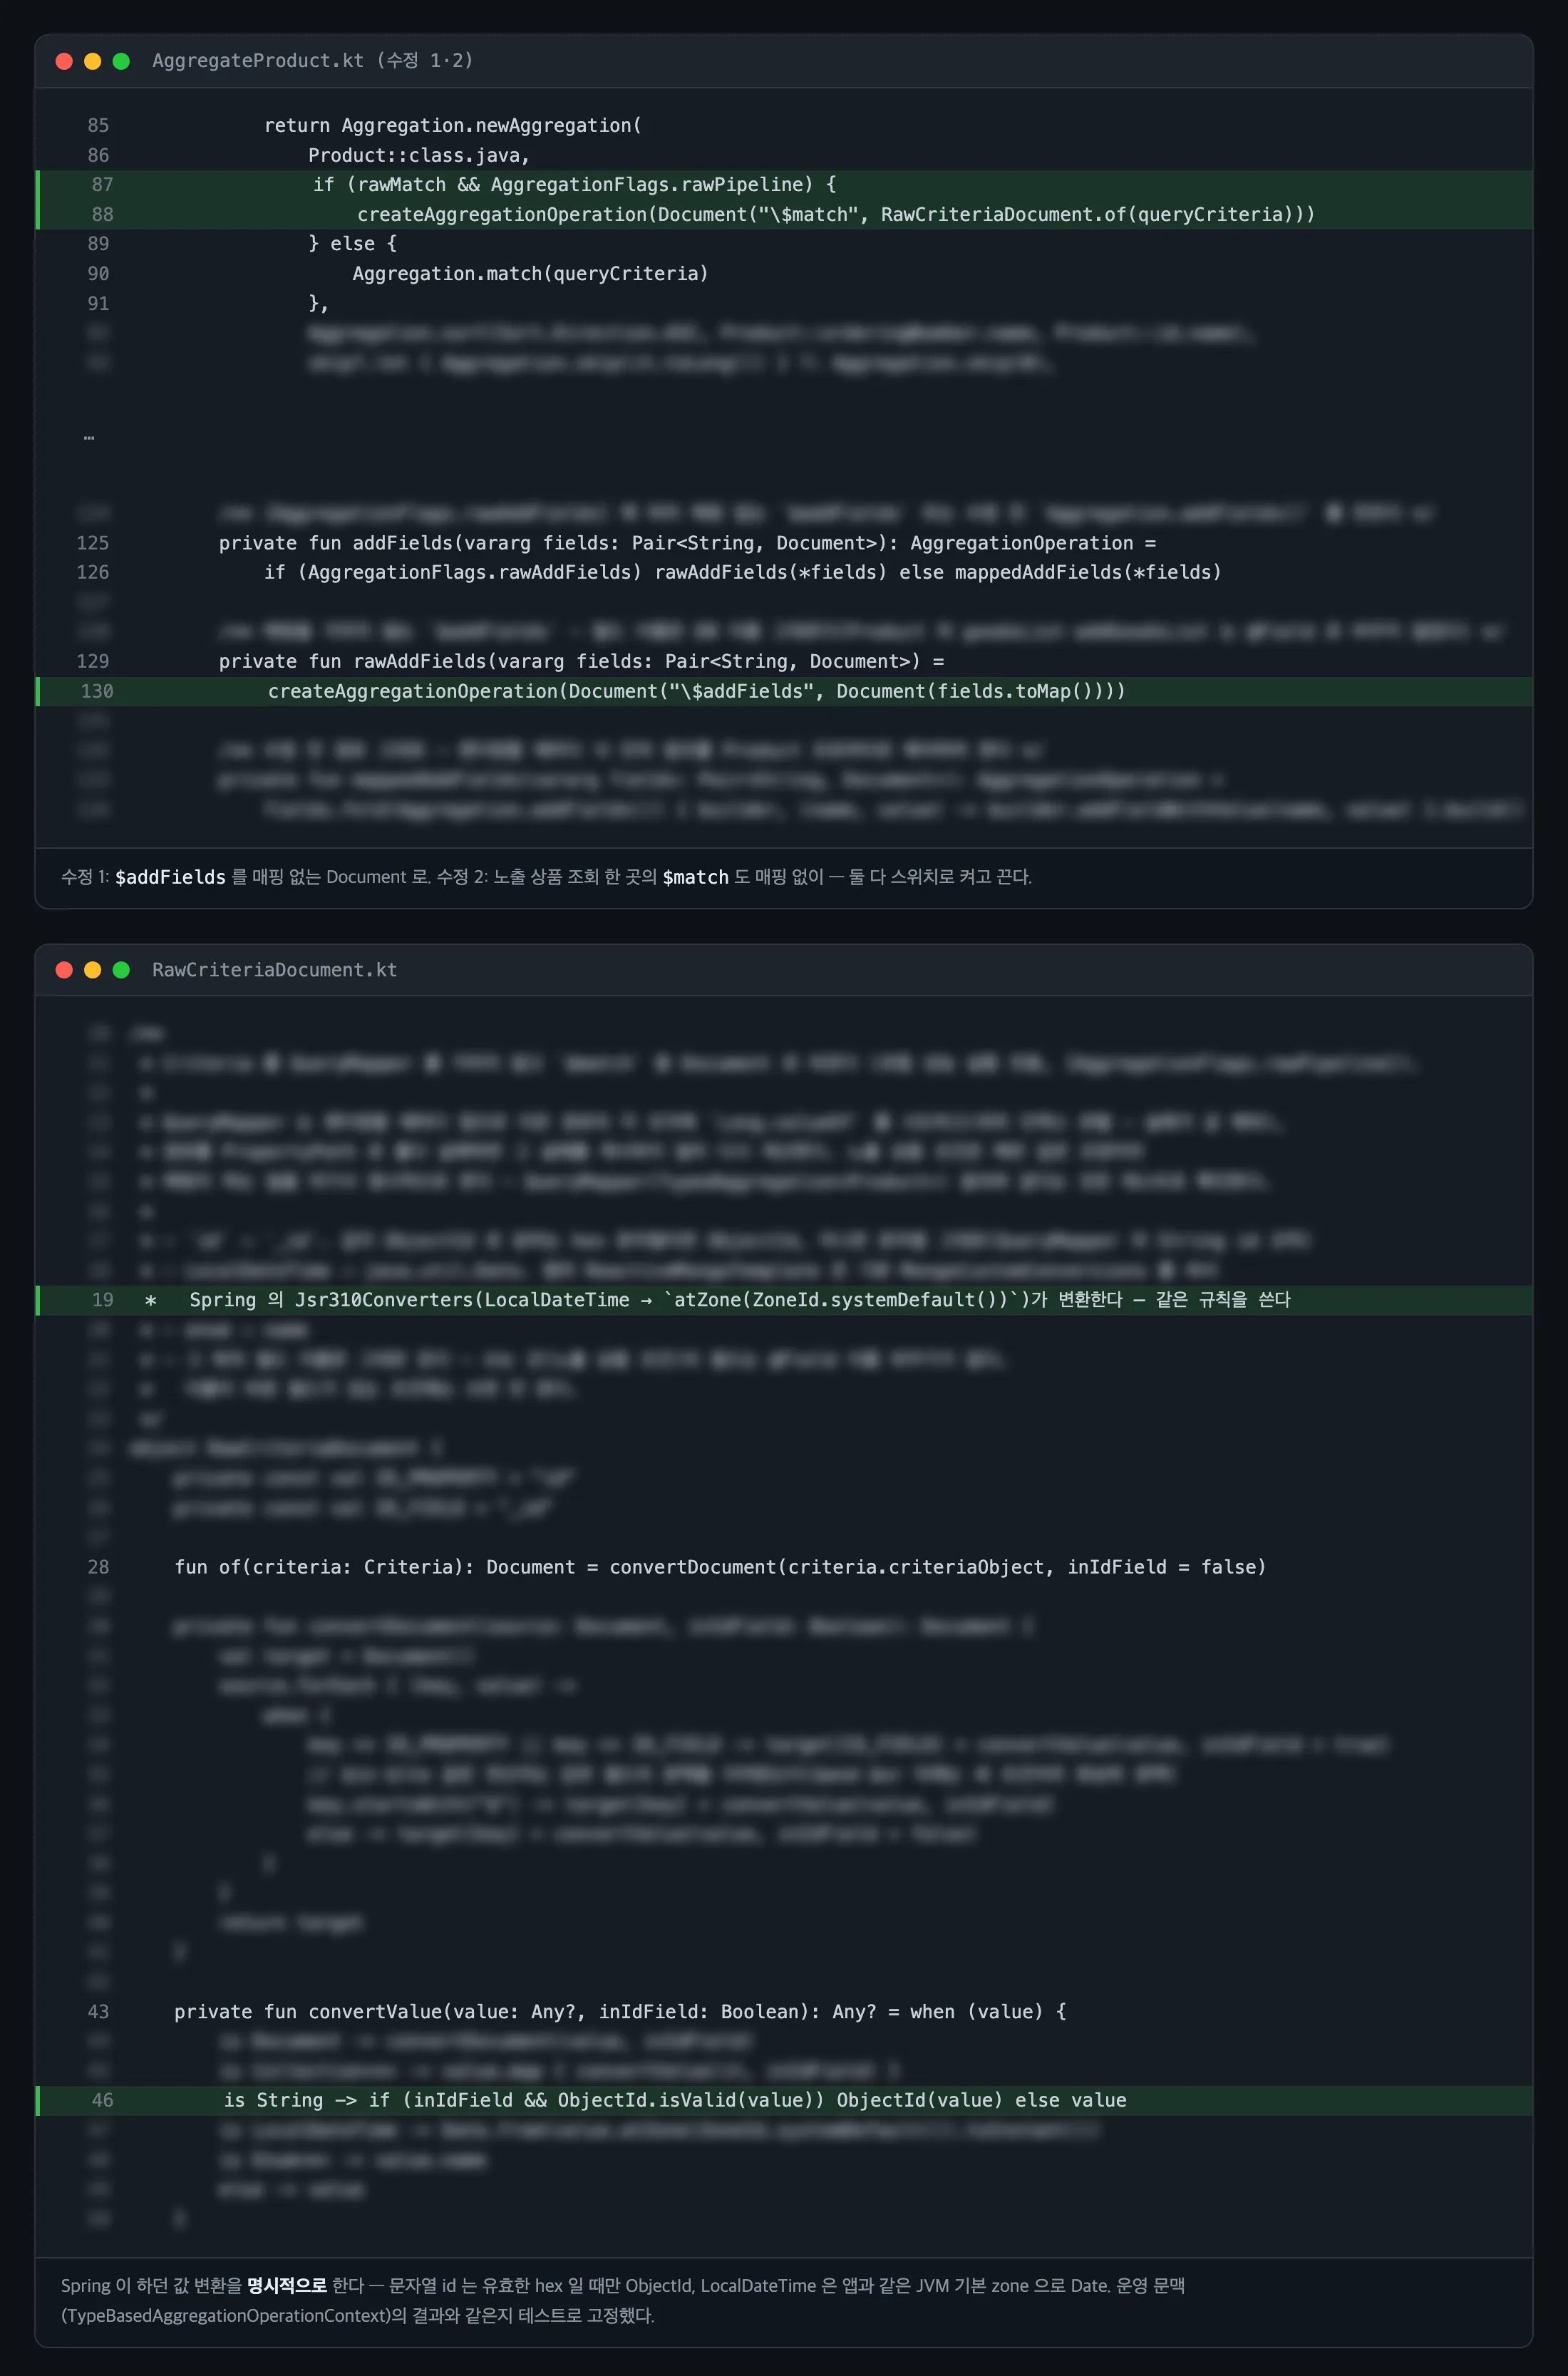
노출 상품 조회 한 곳의 $match 도 매핑 없이 만든다. Spring 이 하던 값 변환(문자열 id → ObjectId, LocalDateTime → Date)을 앱과 같은 규칙으로 명시적으로 하고 운영 문맥의 결과와 같은지 테스트로 고정했다. 이름을 바꾼 필드(@Field)·연관 필드가 있는 조건에는 쓰면 안 되는 방식이라 이 한 곳에만 켰다.
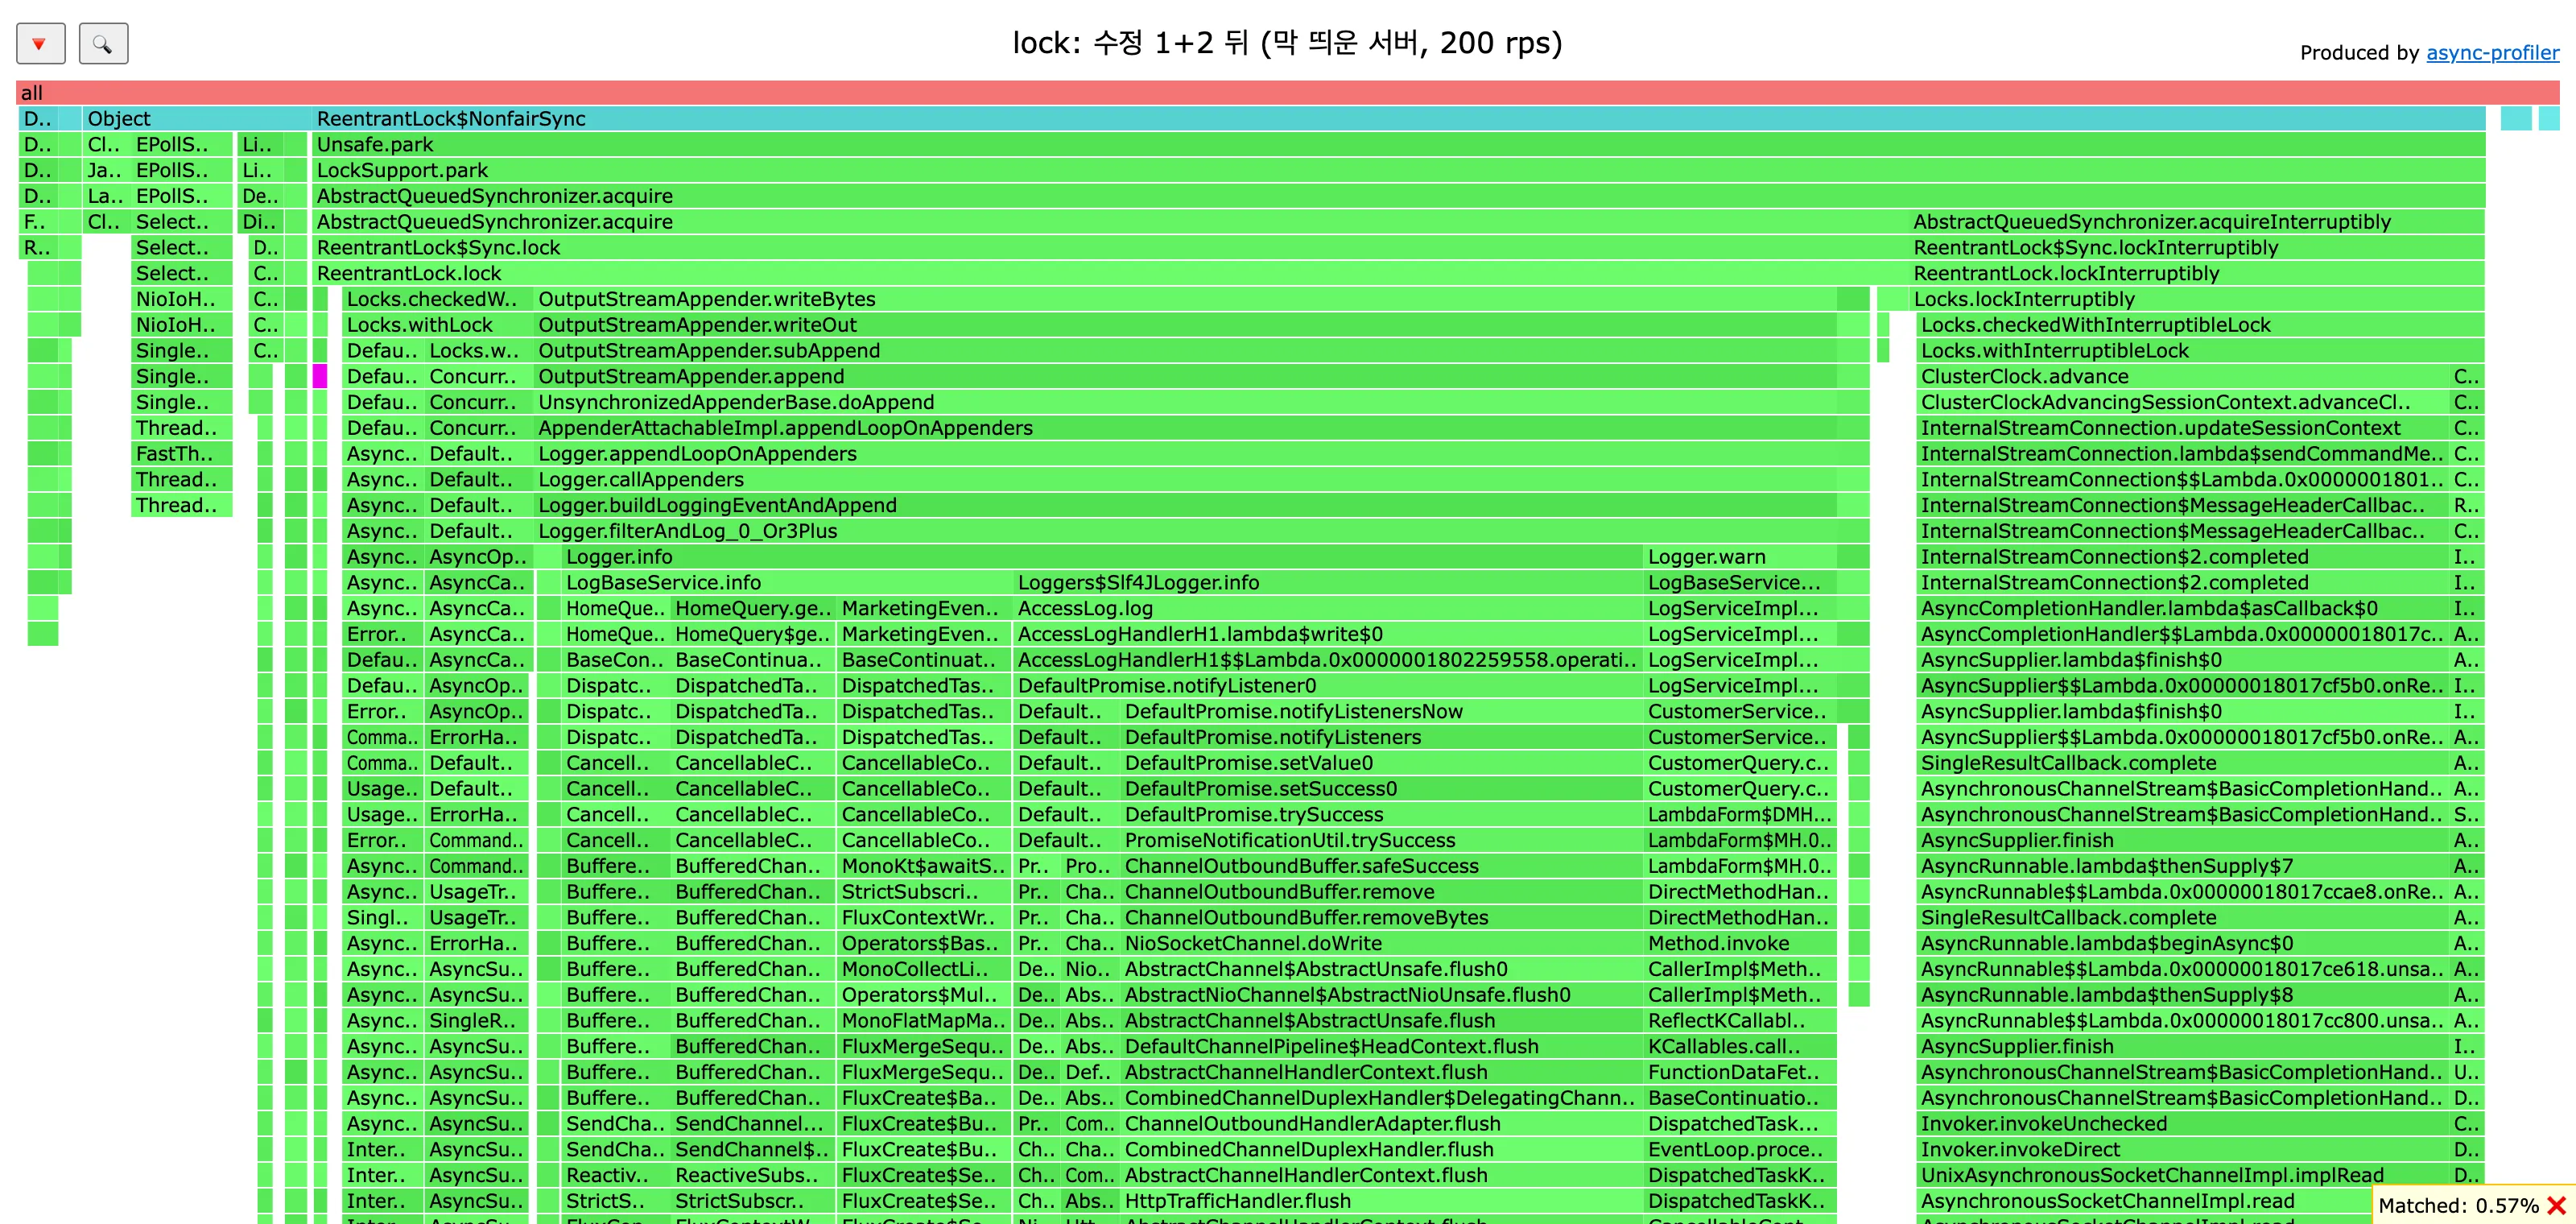
요청당 예외는 22.7개가 남았는데, 정체는 코루틴 취소(JobCancellationException)와 트랜잭션 문맥 확인(NoTransactionInContextException)이다. 이번 원인 두 종류는 0 이 됐다.
비용은 분명히 줄었다(119 → 130 → 141/s). 하지만 무너지는 모양은 같다. 이유는 둘이다.
- 막 뜬 JVM 은 원래 느리다. 첫 몇 분은 JIT 컴파일이 CPU 의 10~20% 를 가져가고(CPU 프로파일의
CompileBroker·C2Compiler), 코드도 아직 인터프리터로 돈다. 1코어에 200/s 는 데운 서버(CPU 50%)에겐 여유지만 막 뜬 서버에겐 버거운 양이다. - 서버가 거절할 줄 모른다. 처리 못 하는 요청도 전부 받아 줄을 세운다. 줄이 길어질수록 스레드가 늘고 스레드가 늘수록 더 느려진다. 처리량보다 많이 받는 순간 회복하지 못한다.
그래서 "요청 하나를 싸게"에서 멈추지 않고, "같은 일을 덜 하게"와 "넘치면 버리게"를 더했다.
5. 같은 일을 덜 하게 — jitter 만으로는 안 되는 이유
GraphQL getExhibition 에는 캐시가 없었다. 00시 트래픽은 거의 전부 키 하나(오픈한 기획전)로 몰린다. 흔히 캐시 스탬피드 대책으로 TTL 에 무작위 값을 더하는 jitter 를 떠올리는데, jitter 는 "여러 키의 만료 시각"을 흩는 기법이다. 키가 하나면 만료가 언제로 밀리든 그 순간 기다리던 요청이 전부 같이 미스를 낸다.
| 상황 | jitter 만 | single-flight (+ XFetch, stale-while-revalidate) |
|---|---|---|
| 키 1,000개가 같은 시각에 만료 | 효과 있음 | — |
| 키 하나에 초당 38건 | 만료 순간 전부 다시 조립 | 한 건만 조립, 나머지는 그 결과를 기다림 |
| 캐시가 빈 새 pod | 효과 없음 | 첫 미스부터 한 건만 조립 |
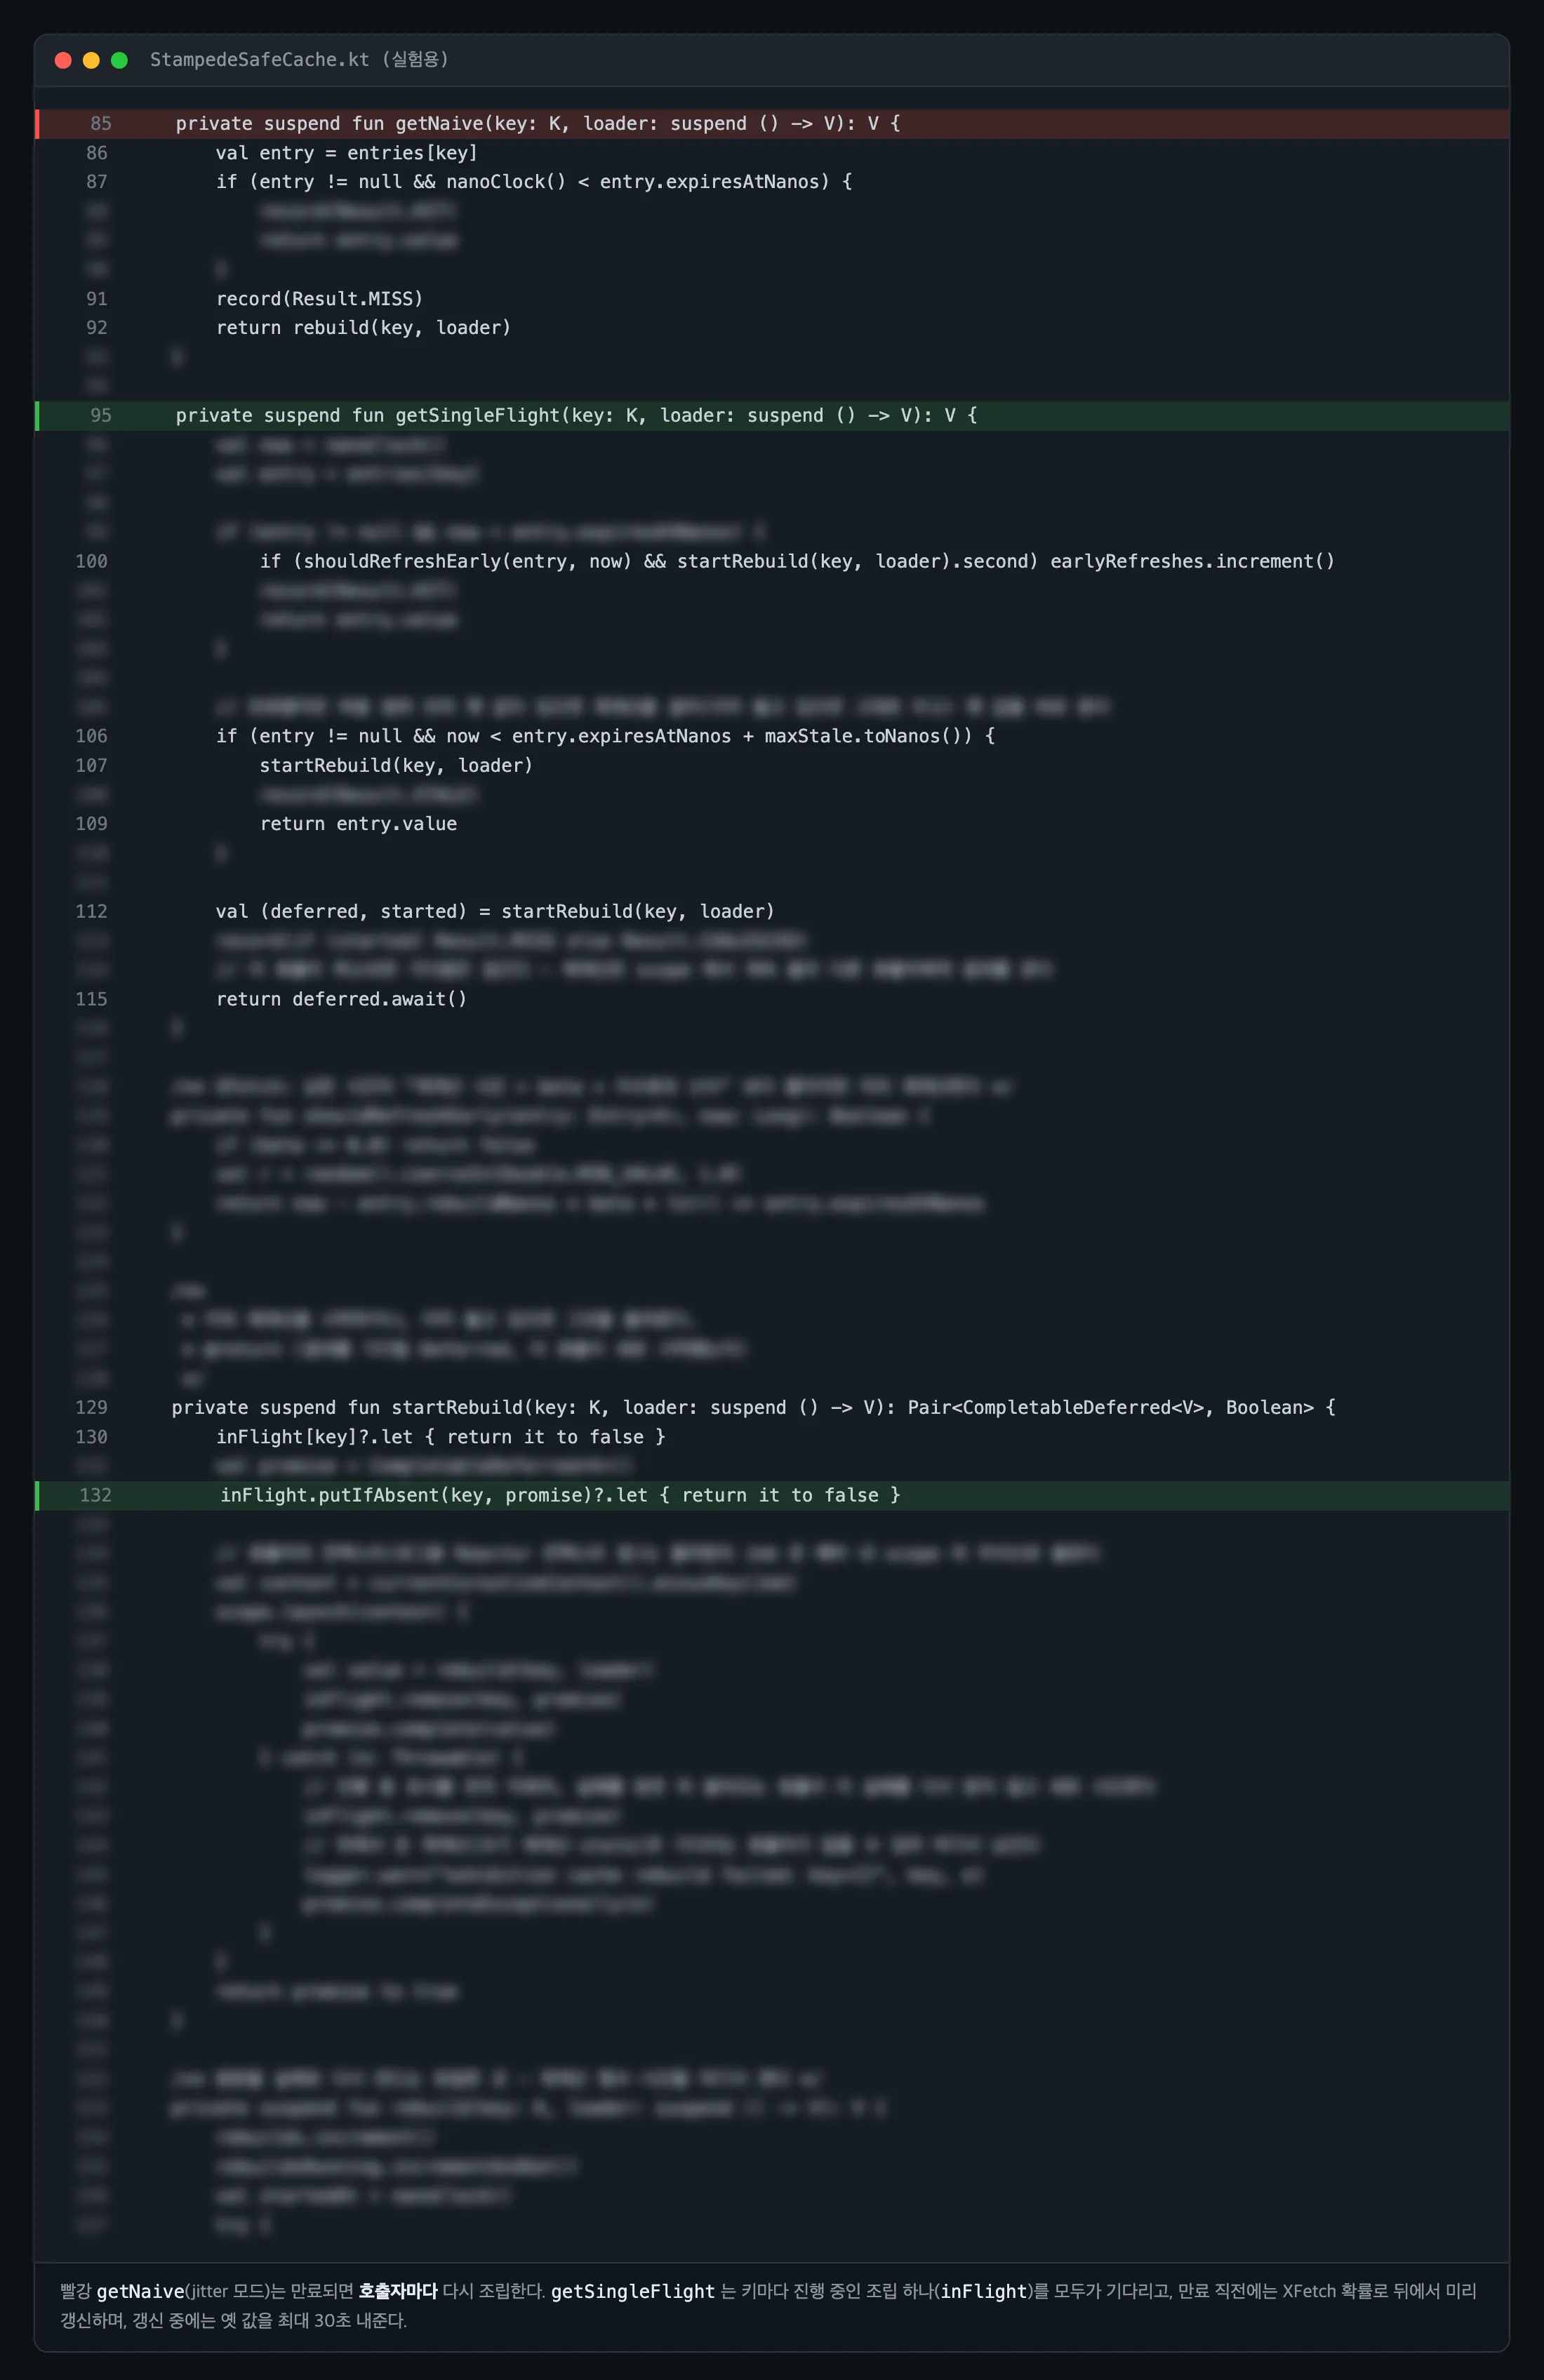
single-flight 모드는 만료 직전에는 XFetch(Vattani 외, VLDB 2015) 확률로 뒤에서 미리 갱신하고 갱신 중에는 옛 값을 최대 30초 내준다. 등급 검사는 캐시 밖에서 매 요청 한다.
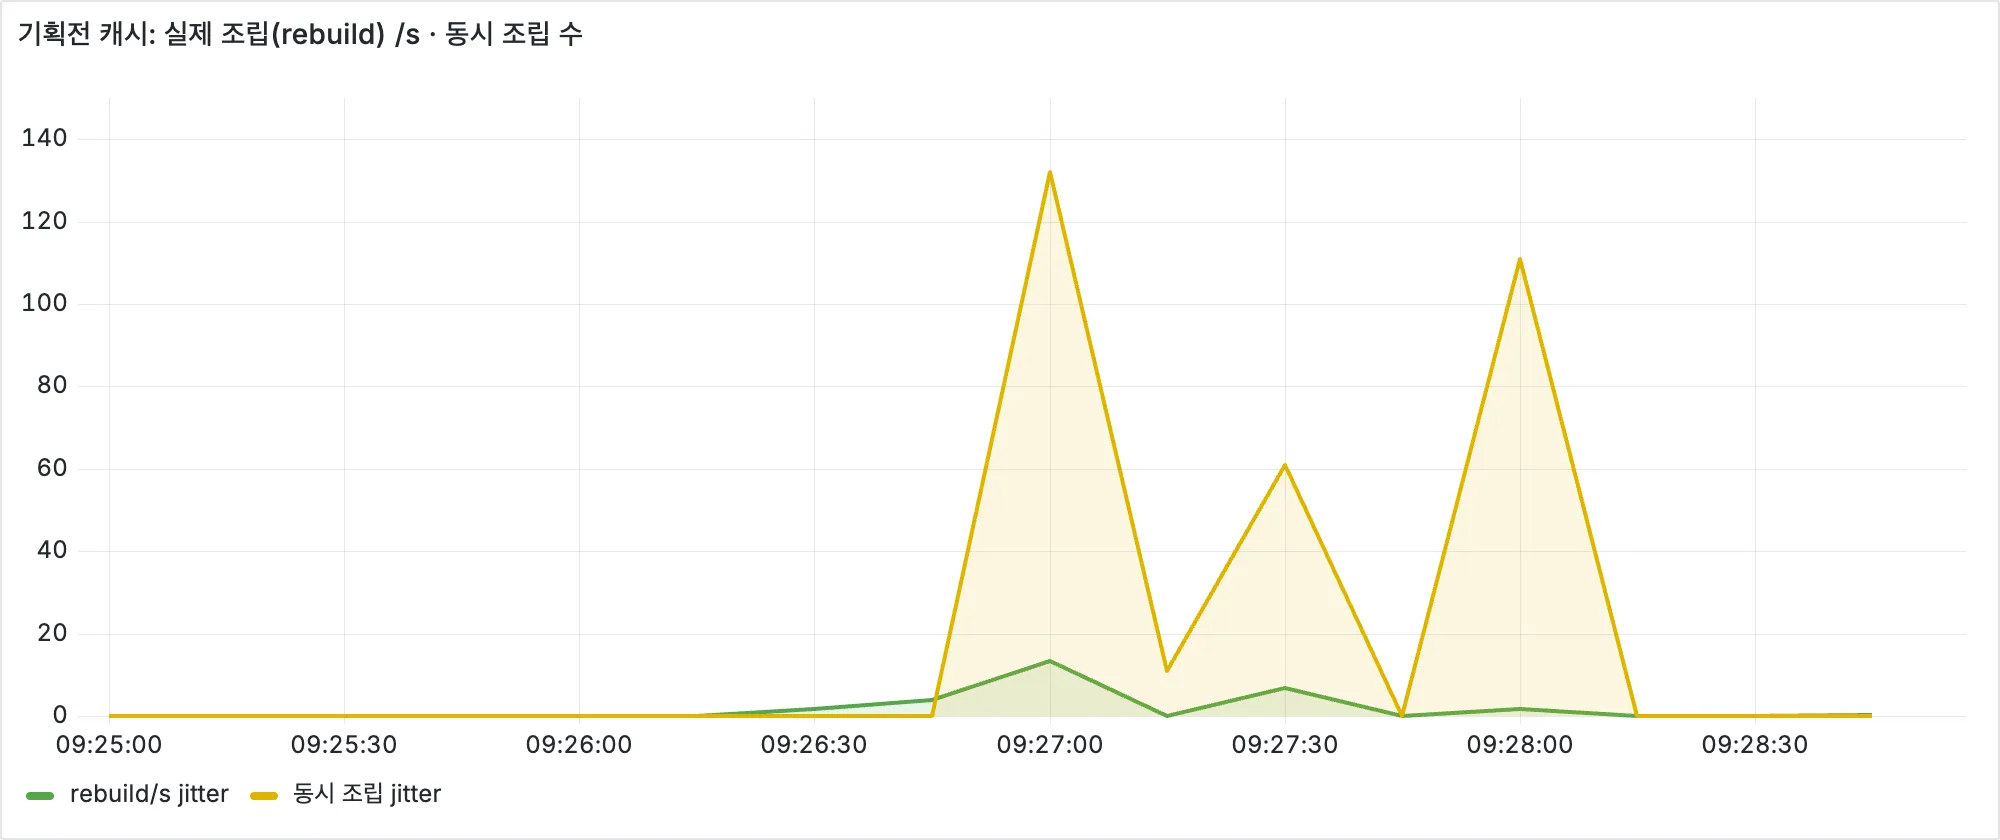
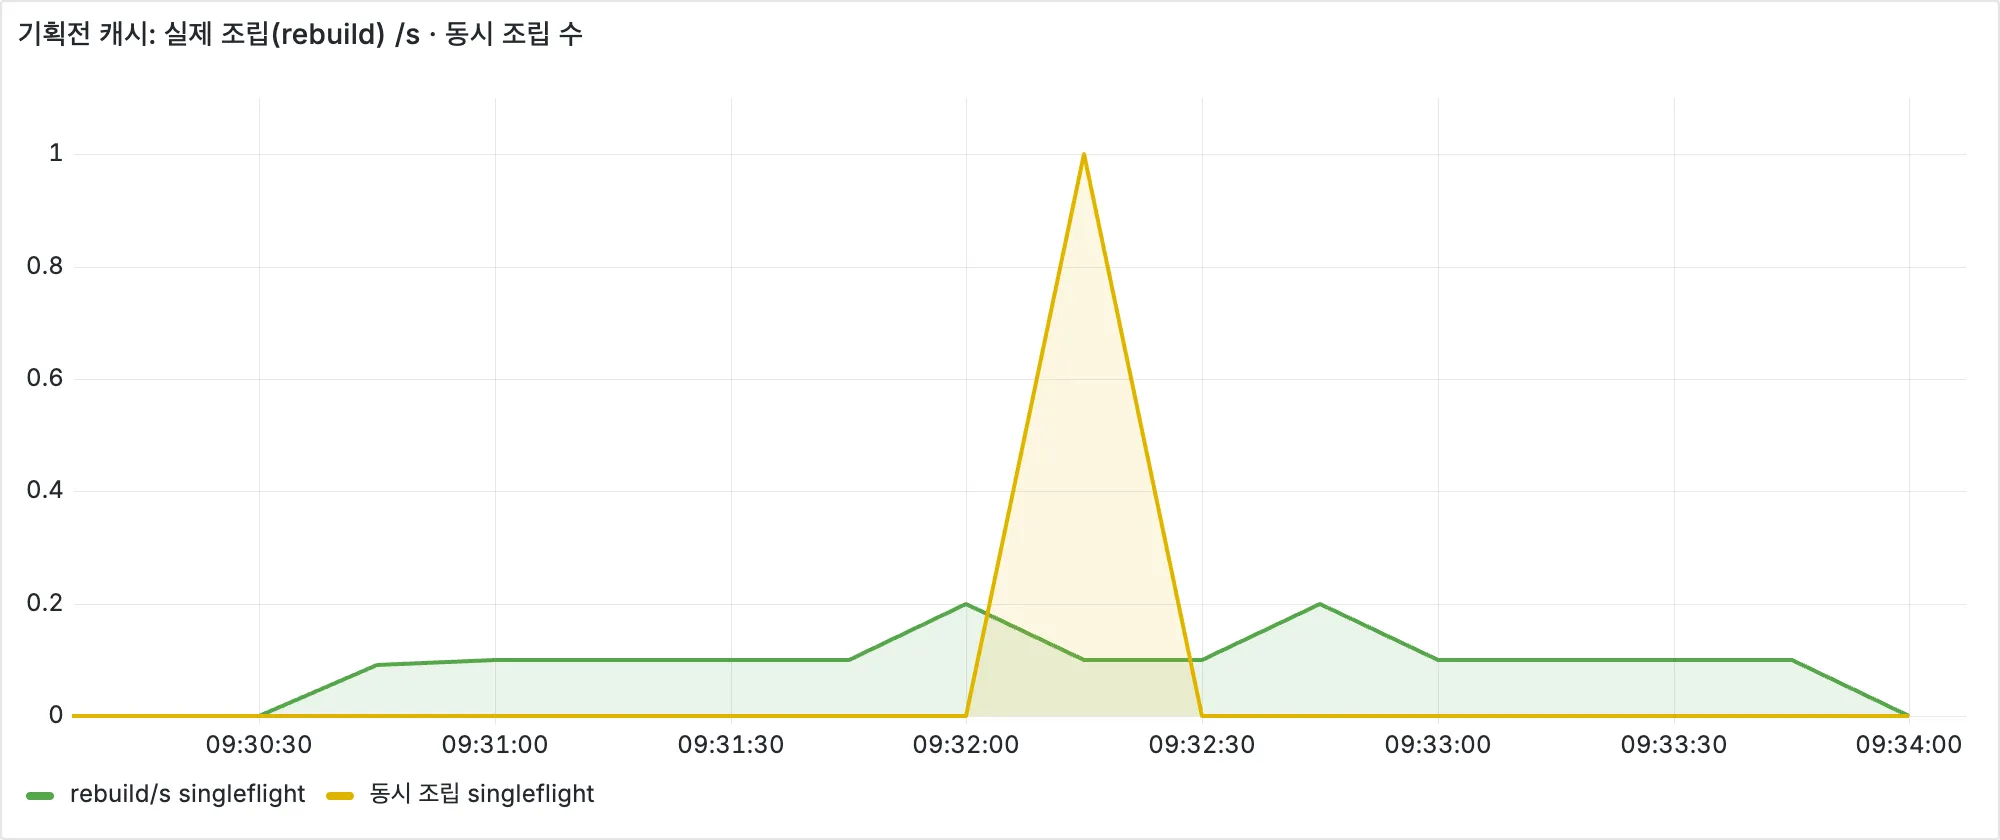
효과를 공정하게 보려고 근본 수정을 끈 기준 코드(조립이 비싼 상태)에 TTL 10초 캐시를 붙여 비교했다.
6. 넘치면 버리게 — 적응형 동시성 제한
캐시는 "같은 일"만 줄인다. 다른 오퍼레이션 8개는 여전히 들어오고 막 뜬 서버의 첫 1분은 여전히 버겁다. 마지막 방어선은 처리할 수 있는 만큼만 받고 나머지는 빨리 거절하는 것이다.
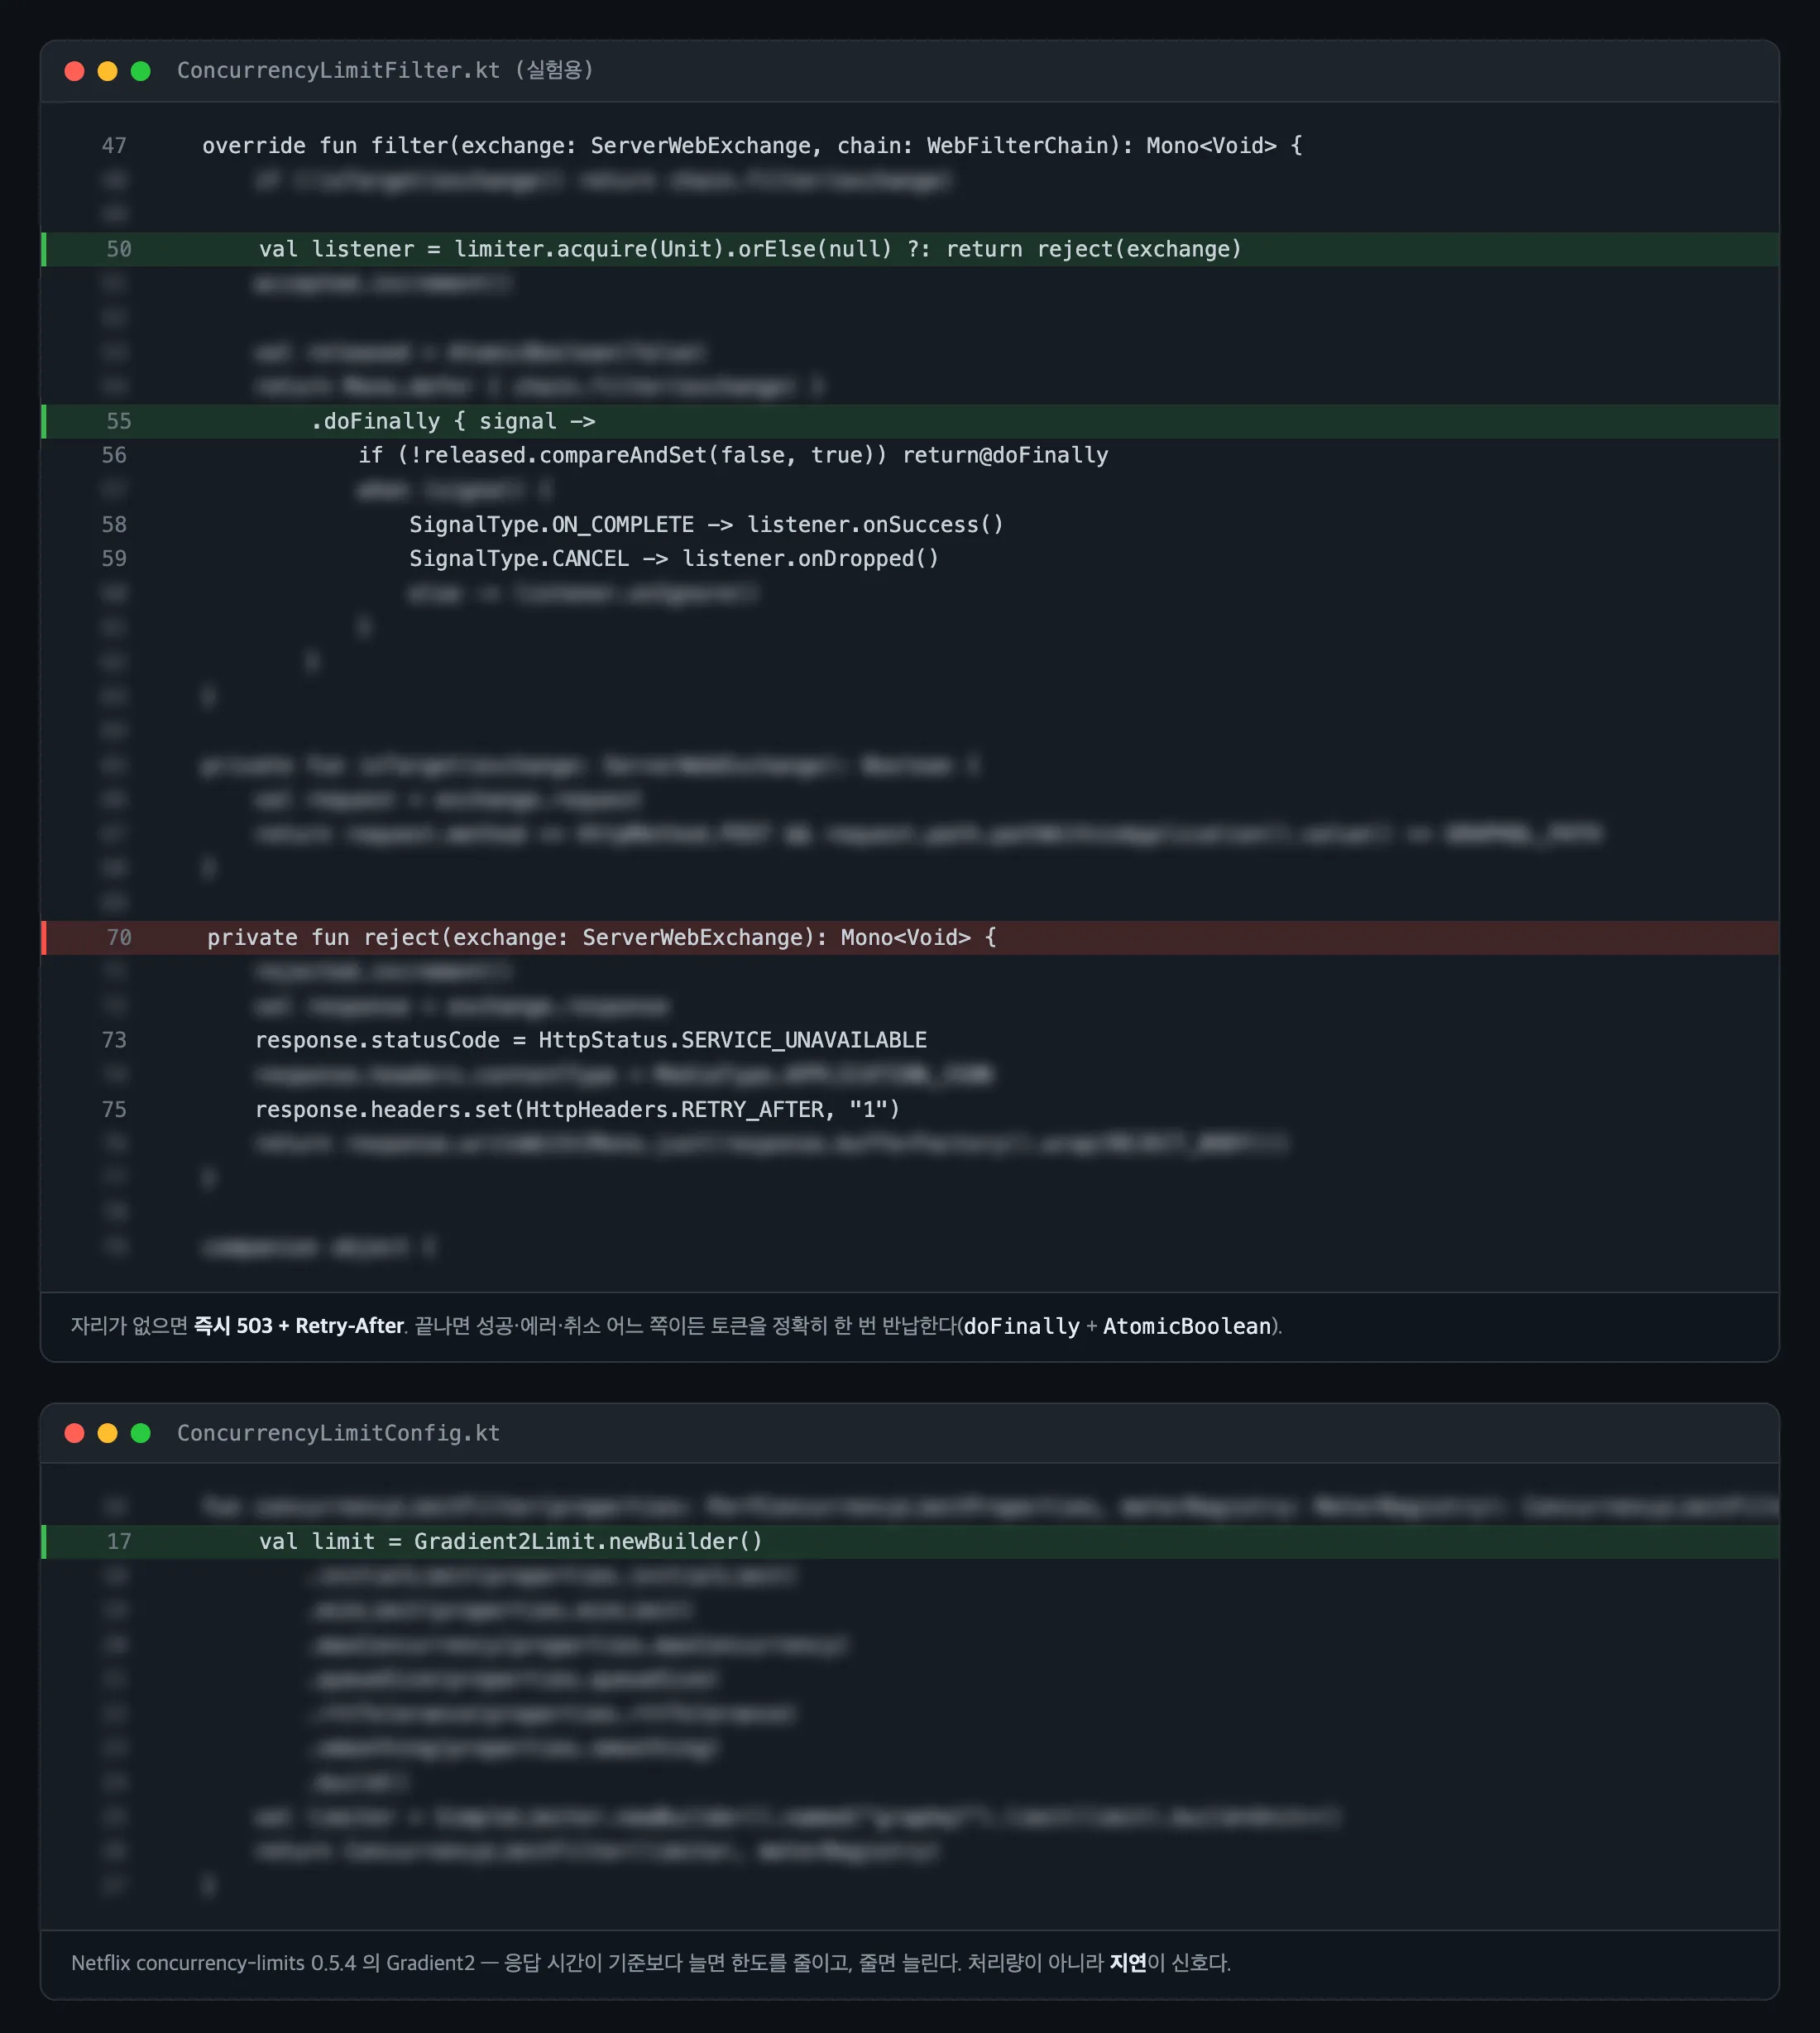
Gradient2 는 응답 시간이 기준보다 늘면 한도를 줄이고, 줄면 늘린다. 처리량이 아니라 지연이 신호다. 요청이 끝나면 성공·에러·취소 어느 쪽이든 토큰을 정확히 한 번 반납한다.
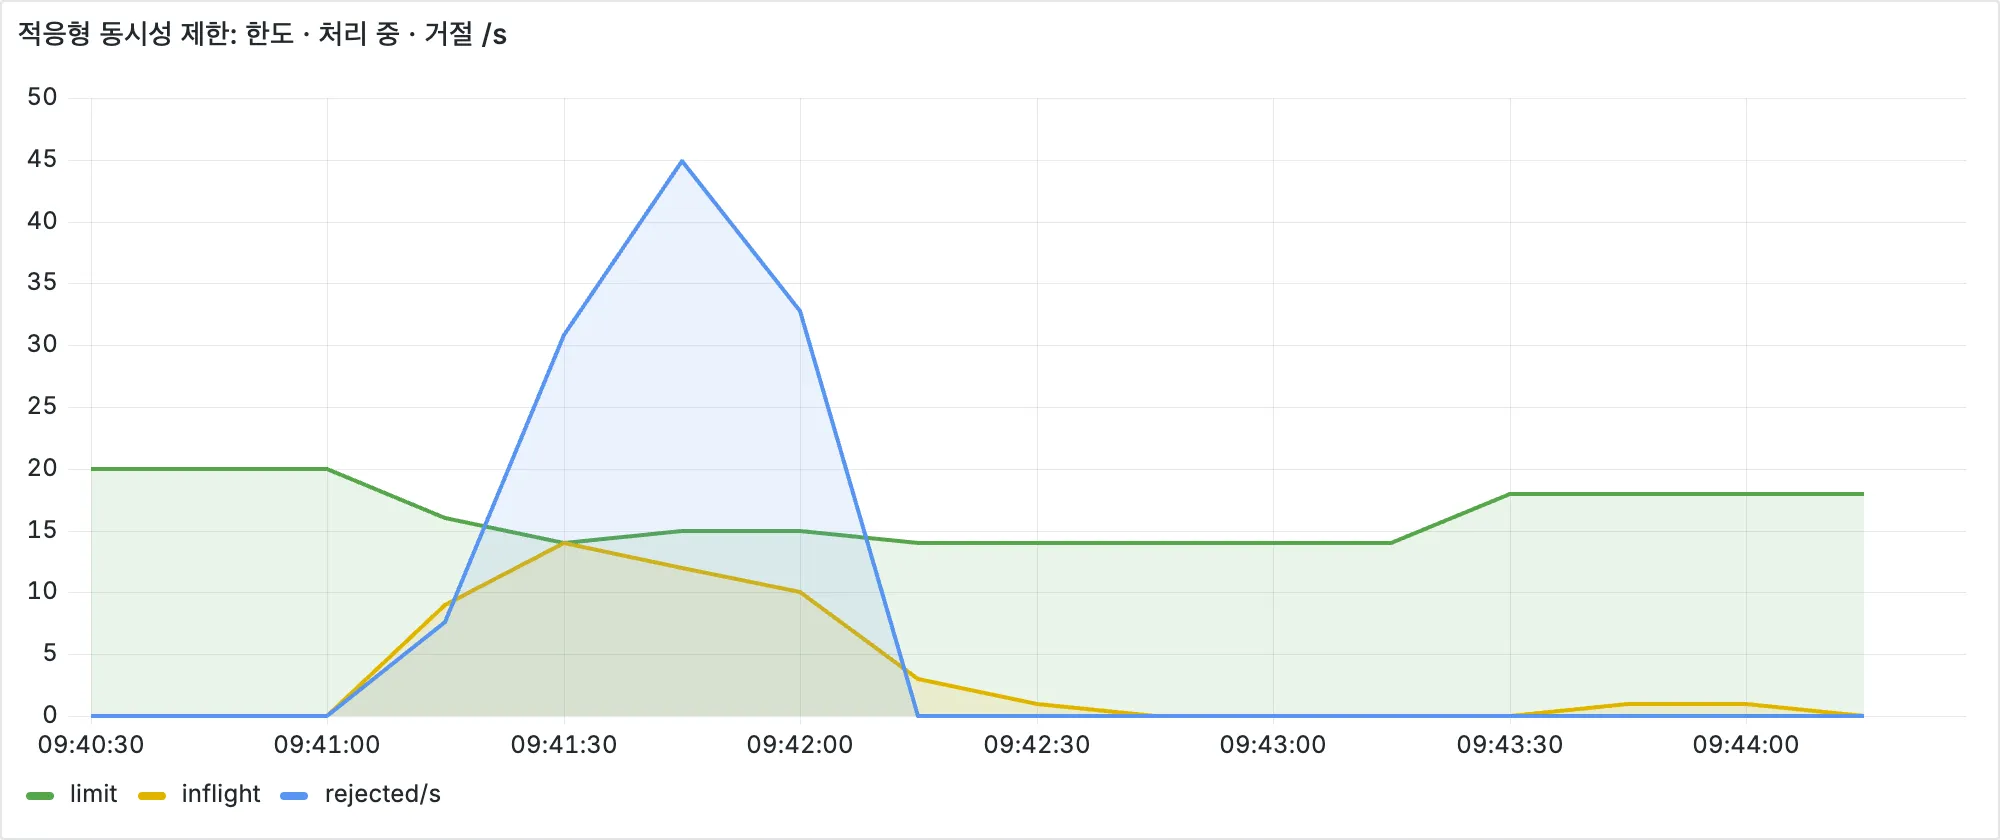
"버린다"가 불편하게 들리지만 비교하면 이렇다. 기준 코드에 동시성 제한만 켜면 실패율 39.7% 인데, 그중 14,046건이 즉시 돌아간 503 이고 getExhibition p50 은 160ms 였다. 제한이 없을 때는 실패 8% 가 전부 2분을 기다리다 끝난 타임아웃이었고 그동안 받은 요청 모두가 수십 초씩 느렸다. 앞은 "일부를 빨리 거절하고 나머지는 빨리 처리", 뒤는 "모두를 느리게 하다 일부를 늦게 버림"이다.
7. 전부 켰을 때
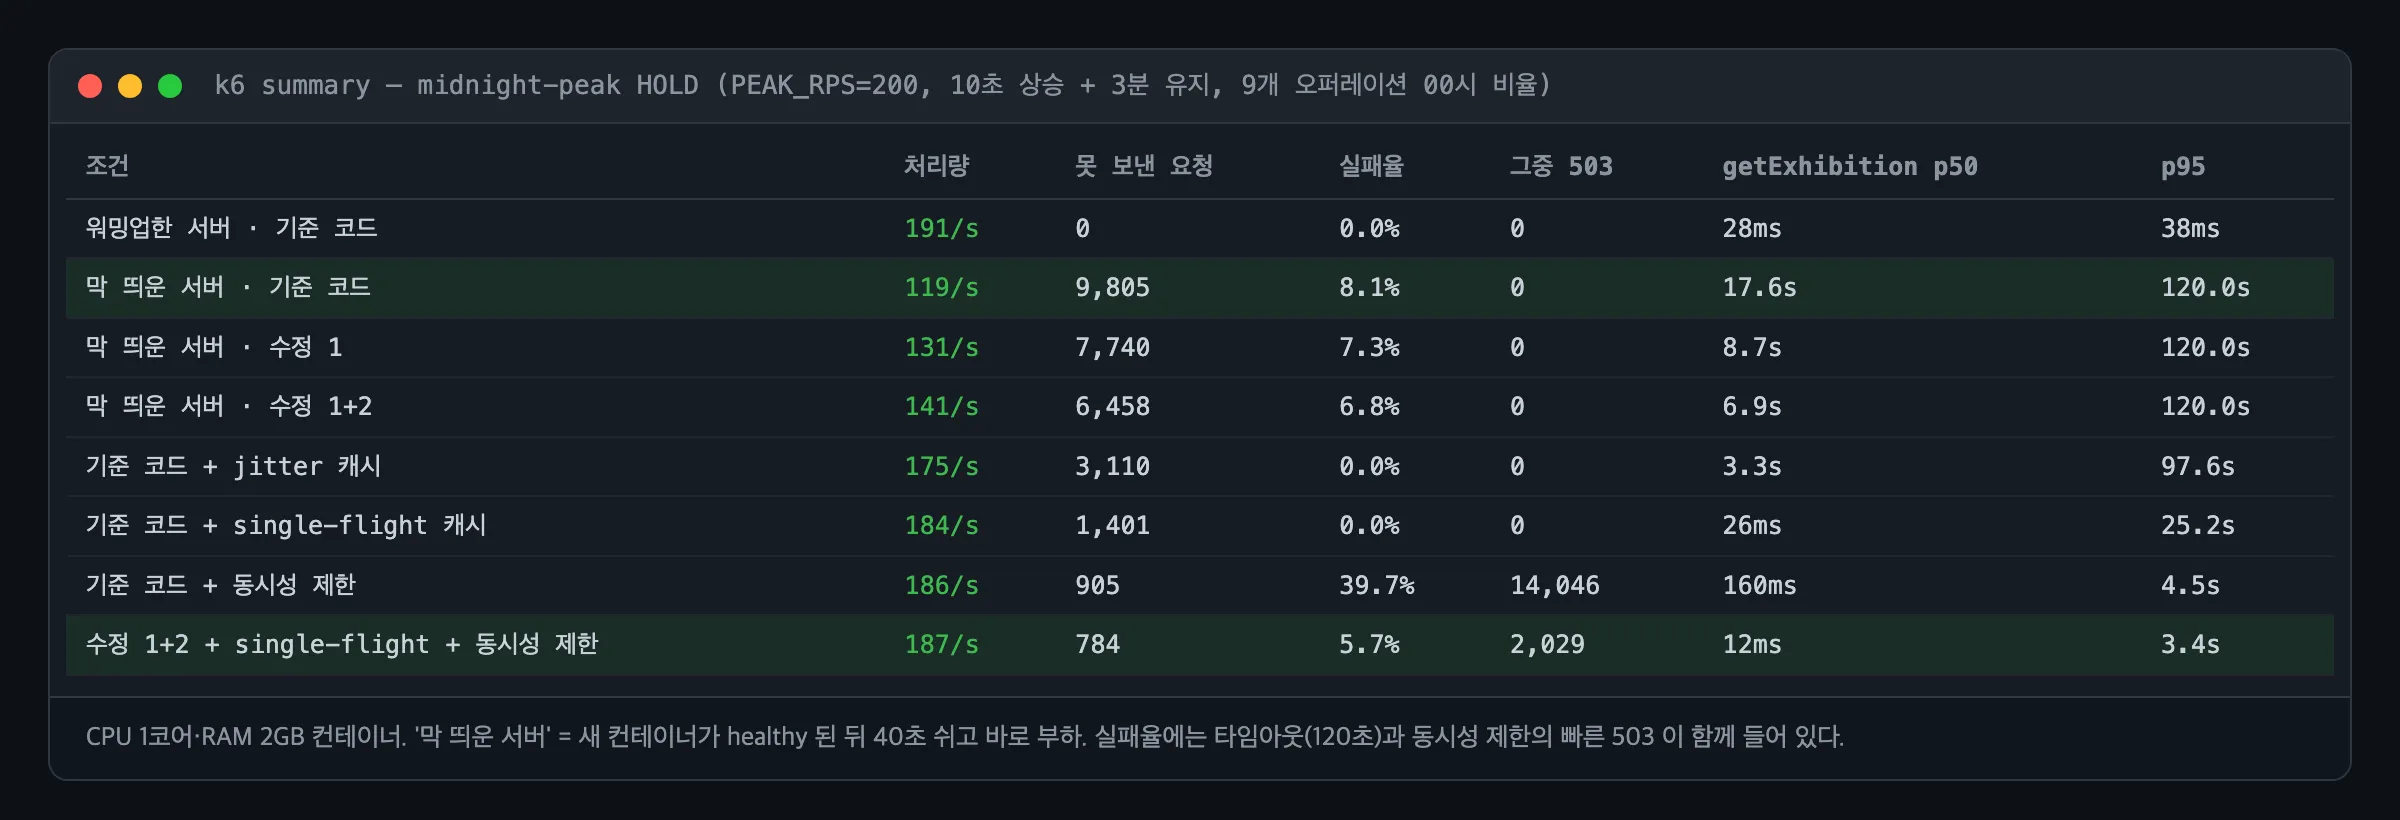
전부 켜자 막 뜬 서버도 187/s · getExhibition p50 12ms 로 버텼고 첫 1분에만 2,029건을 503 으로 돌려보냈다.
8. 배운 것과 남은 것
- 대시보드는 "무엇이"를, 프로파일러는 "왜"를 말한다. Grafana 는 스레드가 기다린다는 것까지 보여 줬고 무엇을 기다리는지는 lock 모드 한 장이 말했다. 붕괴 구간에서는 지표 수집마저 끊기니 더욱 그렇다.
- 예외는 비싸고 락 안의 예외는 더 비싸다. 라이브러리가 실패를 캐시하지 않는다는 한 줄과 리액티브의 깊은 스택이 만나 생긴 문제였다.
TypedAggregation에 엔티티에 없는 필드를 쓰는 것, 그리고 범위 조건이 들어간 criteria 매핑은 생각보다 비싸다. - 원인을 고친다고 붕괴가 사라지지는 않는다. 비용을 줄이는 것, 같은 일을 묶는 것, 넘치면 버리는 것은 다른 층의 문제다. 이번에는 셋이 다 필요했다.
- 측정을 의심하자. 프로파일러가 결과를 바꾸고(lock 모드), 워밍업 방법이 결과를 바꾼다. 같은 조건을 맞추는 데 실험의 절반이 들었다.
남은 것도 있다.
- 캐시는 pod 단위다. pod 가 N개면 만료마다 여전히 N번 조립한다. 공유 캐시 + 분산 락은 그 자체로 락 대기와 장애 전파라는 비용이 있어 이번엔 넣지 않았다.
- 옛 응답이 최악 약 42초(TTL × 1.2 + max-stale) 나갈 수 있다. 재고·품절 정렬이 그만큼 늦게 반영된다.
- 동시성 제한은 튜닝에 민감하다(초기 한도, 최소 한도, 503 을 받은 클라이언트의 재시도). 실서비스라면 클라이언트 재시도 정책을 같이 봐야 한다.
- 가장 근본적인 대책일 수 있는 "트래픽을 받기 전에 JVM 데우기"(readiness 전 합성 요청, JDK 25 AOT 캐시)는 이번 범위에서 빠졌다. 데운 서버가 191/s 를 낸 것을 보면 효과가 클 것이다.
- 8개 그룹을 순차로 조회하는 구조 자체(한 번의
$in으로 묶을 수 있다)도 손대지 않았다 — 같은 문제를 홈 API 글에서 다뤘다.
요약
- 증상: 기획전 오픈 00시 트래픽(초당 약 200건)을 재현하자, 막 띄운 서버는 처리량 119/s · 실패 8% · p95 2분(타임아웃)으로 무너졌다. 같은 코드를 데운 서버는 191/s · 실패 0% · p95 38ms 로 버텼다. 용량 문제가 아니었다.
- 원인: async-profiler 의 lock 모드에서 락 대기의 96% 가 Spring Data
SimplePropertyPath.from이었다. 상품 aggregation 이 엔티티에 없는 경로를 매핑하다 예외를 만들고 Spring 은 그 실패를 캐시하지 않아 요청마다 세그먼트 락 안에서 다시 계산한다. 요청 하나가 예외를 약 467개 만들었다. - 수정: 두 단계에 걸쳐 매핑이 필요 없는 단계를 raw Document 로 바꿨다. 요청당 예외 467 → 181 → 22.7(남은 것은 무관한 종류), 락 대기 −94%.
- 그런데 막 뜬 서버는 여전히 무너졌다(141/s, 실패 6.8%). 비용은 줄었지만 "차가운 JVM + 거절할 줄 모르는 서버"가 남아 있었다.
- 그래서 키 하나에 몰리는 요청을 묶는 single-flight + XFetch 캐시(jitter 캐시는 3분 동안 536번 조립·동시 최대 157개 → 22번·최대 1개)와 넘치는 요청을 빨리 거절하는 적응형 동시성 제한을 더했다. 전부 켜자 막 뜬 서버도 187/s · p50 12ms 로 버텼다.
댓글
댓글을 불러오는 중…