5KB 응답을 만들려고 2.5MB 를 읽던 홈 API – 모니터링으로 원인을 좁히고, DataLoader·projection·2중 캐시로 32배
성능 개선
목록 보기숨기기2/2
- 00시, 새로 뜬 pod 만 무너졌다 – 프로파일러로 Spring Data 의 숨은 락을 찾고, 고친 뒤에도 무너진 이유까지
- 5KB 응답을 만들려고 2.5MB 를 읽던 홈 API – 모니터링으로 원인을 좁히고, DataLoader·projection·2중 캐시로 32배
이 글의 수치는 모두 로컬 재현 환경에서 잰 값이다. 병렬화·DataLoader·projection·캐시는 로컬에서 실험으로 실제로 구현해 스위치로 하나씩 켜며 쟀고(운영 반영 전) 각 단계 사이에 캐시 키를 비웠다. 이 API 의 상품 조회는 기획전 API 글에서 다룬 aggregation 과 같은 코드를 쓴다 — 두 글은 이어진다.
0. 재현 환경과 측정 방법
| 항목 | 값 |
|---|---|
| 서버 | API 서버 컨테이너 CPU 1코어 · RAM 2GB(운영 pod requests 와 같음), 단계마다 새로 띄우고 60초 데움 |
| 데이터 | dev 덤프 복원 — 홈 진열 37개(기획전 18 · 스케줄 7 · 타임딜 5 · 매거진 그룹 4 · 띠배너 3) |
| 부하 ① | 고정 8/s, 90초 — 같은 일을 할 때의 지연과 CPU(async-profiler itimer 표본) |
| 부하 ② | 계단식 5 → 10 → 20 → 40 → 80 → 160 → 320/s, 30초씩 — 어디서 꺾이는가. "버틴 계단" = p95 1초 미만이면서 목표의 90% 이상 처리한 가장 높은 계단 |
| 관측 | Grafana(k6 · JVM · Mongo serverStatus), Mongo 프로파일러(level 2, 요청 1건), async-profiler |
| 판정 | HTTP 200 + success + 빈 목록 아님 + 서킷브레이커 대체 응답 아님. 홈 API 에는 @CircuitBreaker 가 있어 열리면 빠른 가짜 응답이 처리량을 부풀릴 수 있어서 따로 셌다(전 단계 0%). |
1. 증상 — 모니터링으로 좁히기
앱을 켜면 제일 먼저 불리는 홈 본문 API(getDisplayHomeBody)가 1코어에서 초당 10건을 넘기면 무너졌다. 대시보드에서 세 가지를 봤는데 각각이 다음 질문을 정했다.
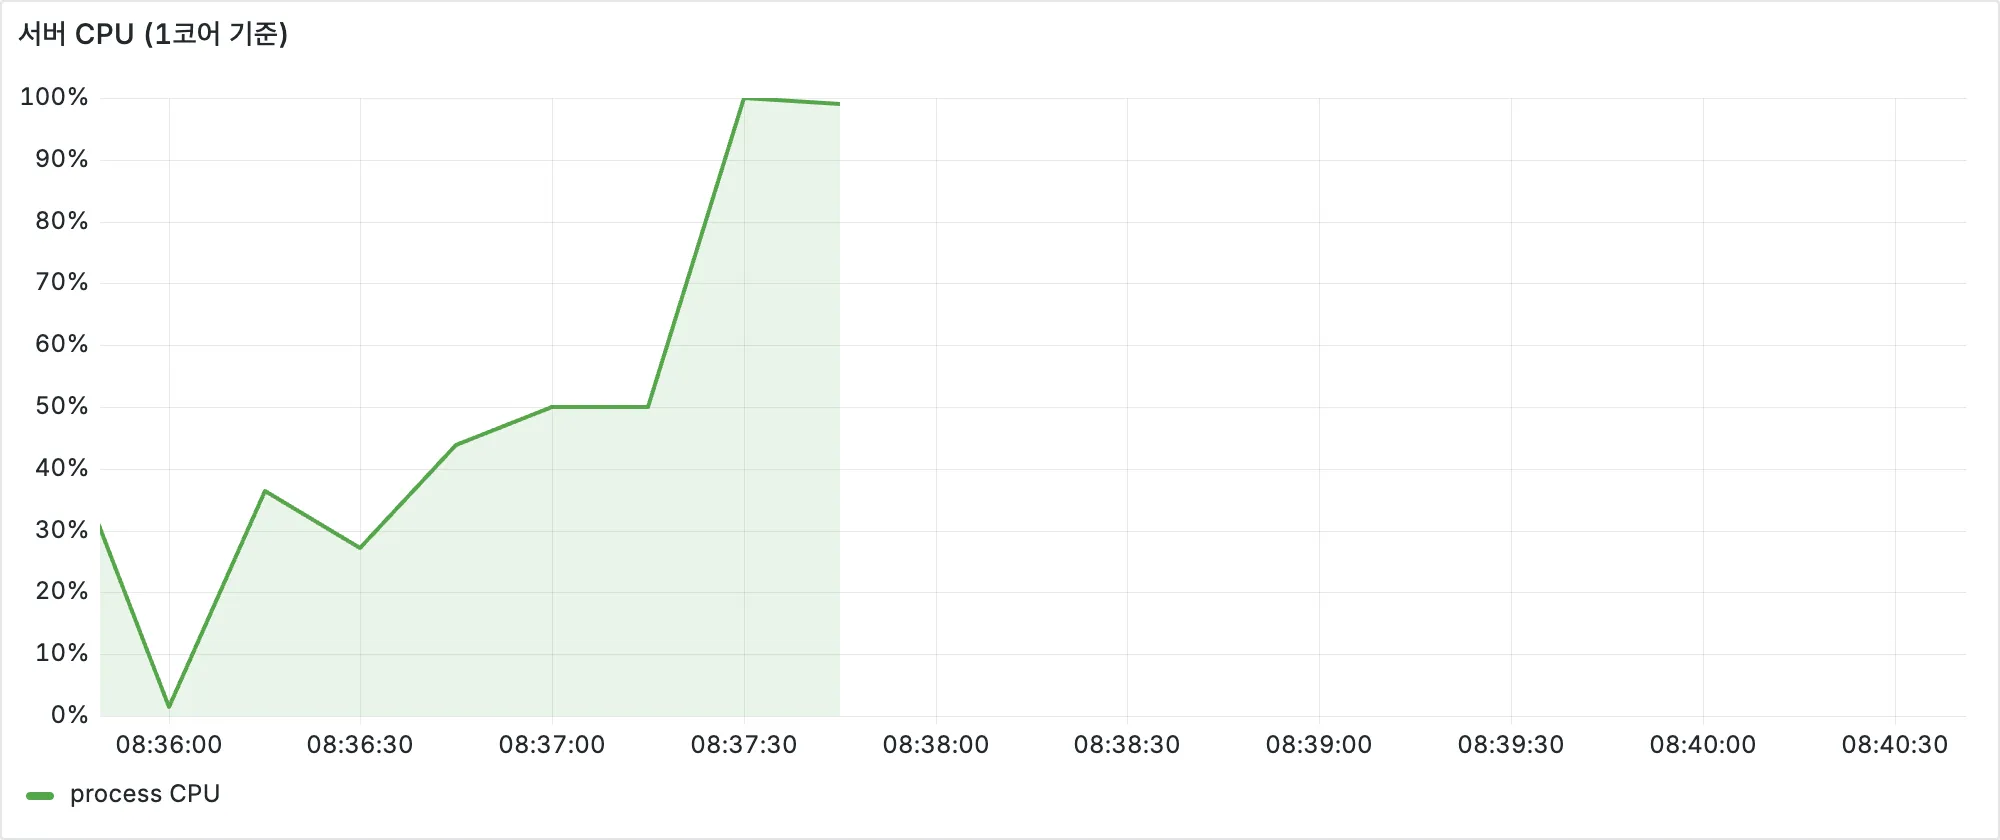
① CPU 가 100% 에 붙는다 → 대기가 아니라 일이 많다. 락이나 외부 호출을 기다리지 않고 CPU 를 다 쓴다.
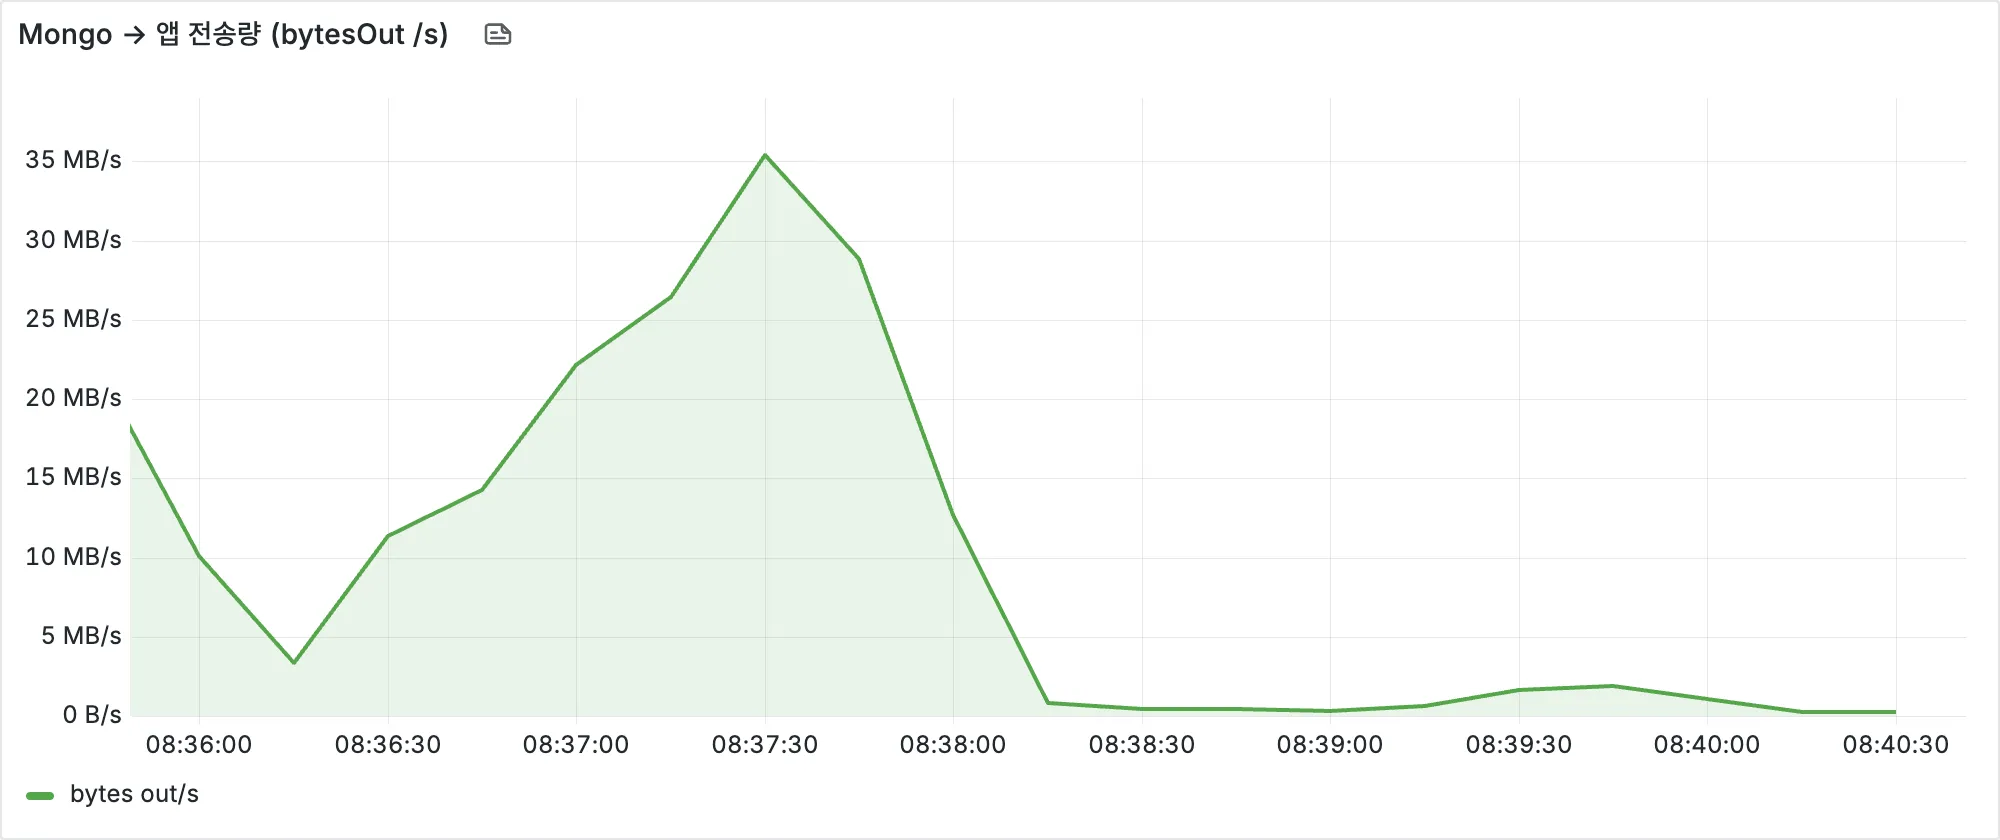
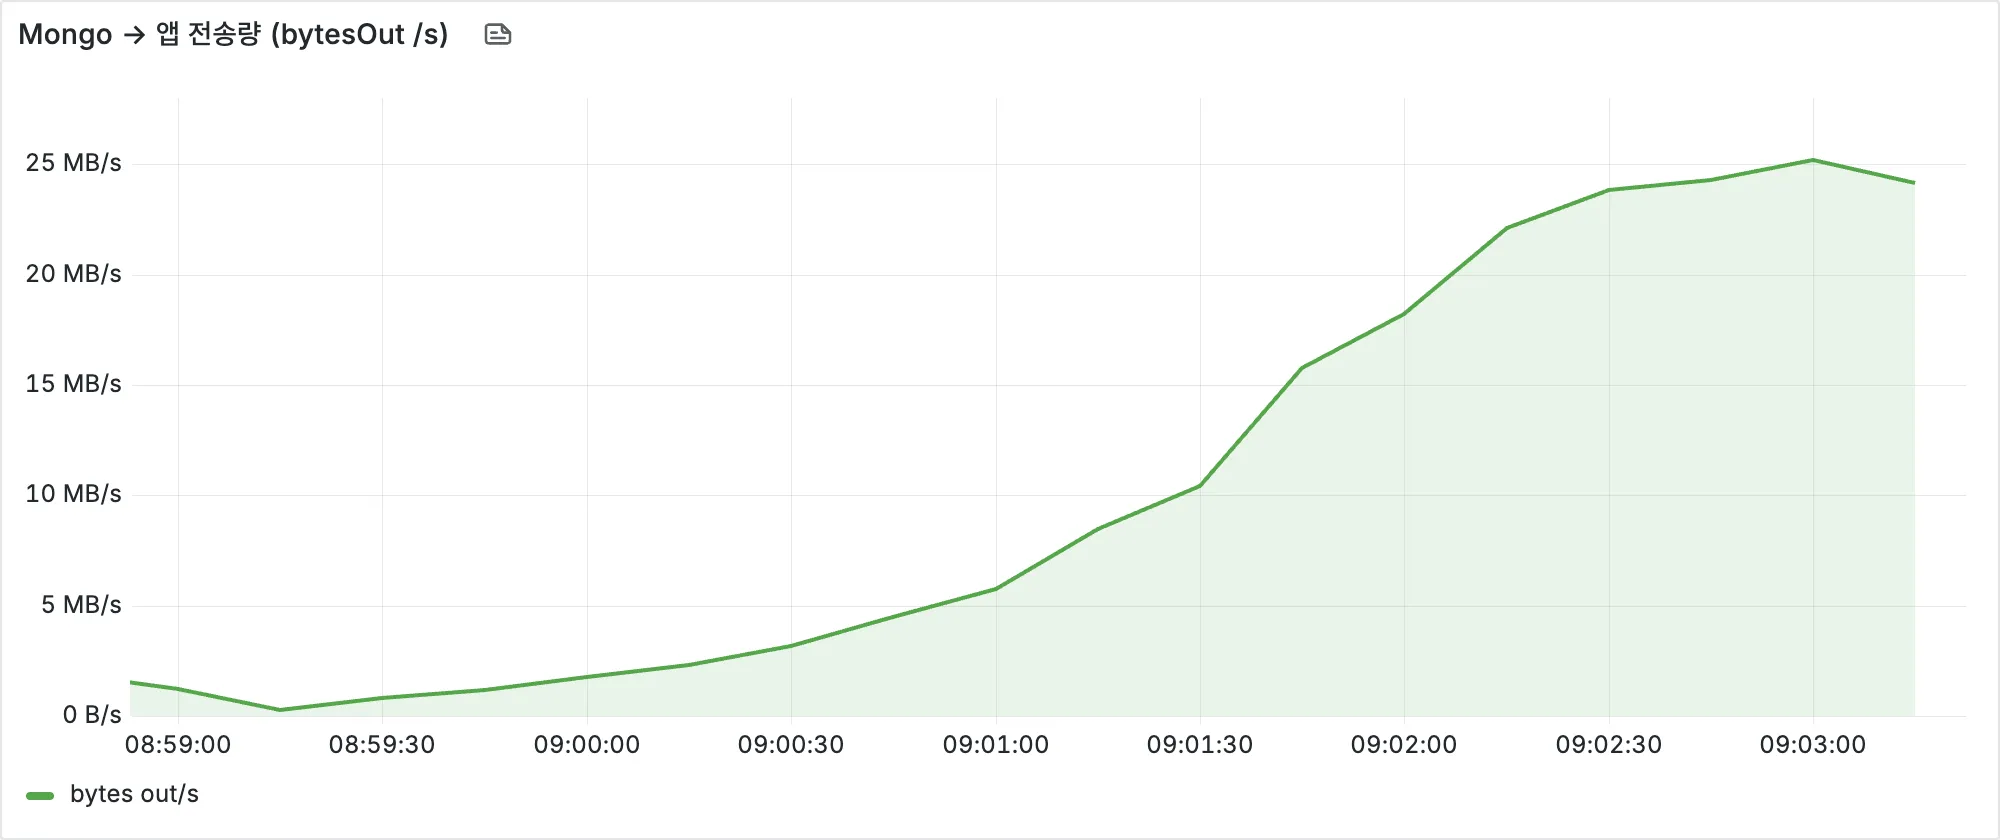
② 초당 13건 근처에서 Mongo 가 앱으로 35MB/s 를 보낸다 → 요청 하나에 약 2.5MB. 응답은 5,136바이트(gzip 1.6KB)인데?
③ k6 처리량이 꺾일 때 Mongo 전송량도 같이 무너진다. 서버가 Mongo 결과를 받아 처리하는 쪽이 병목이라는 뜻이다(Mongo 자체가 느리면 전송량은 유지된 채 지연만 는다). 그러면 질문은 "요청 하나가 Mongo 에 무엇을 시키길래 2.5MB 를 받나"다.
2. 요청 1건 해부 — Mongo 프로파일러
로컬 Mongo 의 모든 앱 DB 에 프로파일러를 잠깐 켜고(db.setProfilingLevel(2)) 홈 본문을 딱 한 번 불렀다.
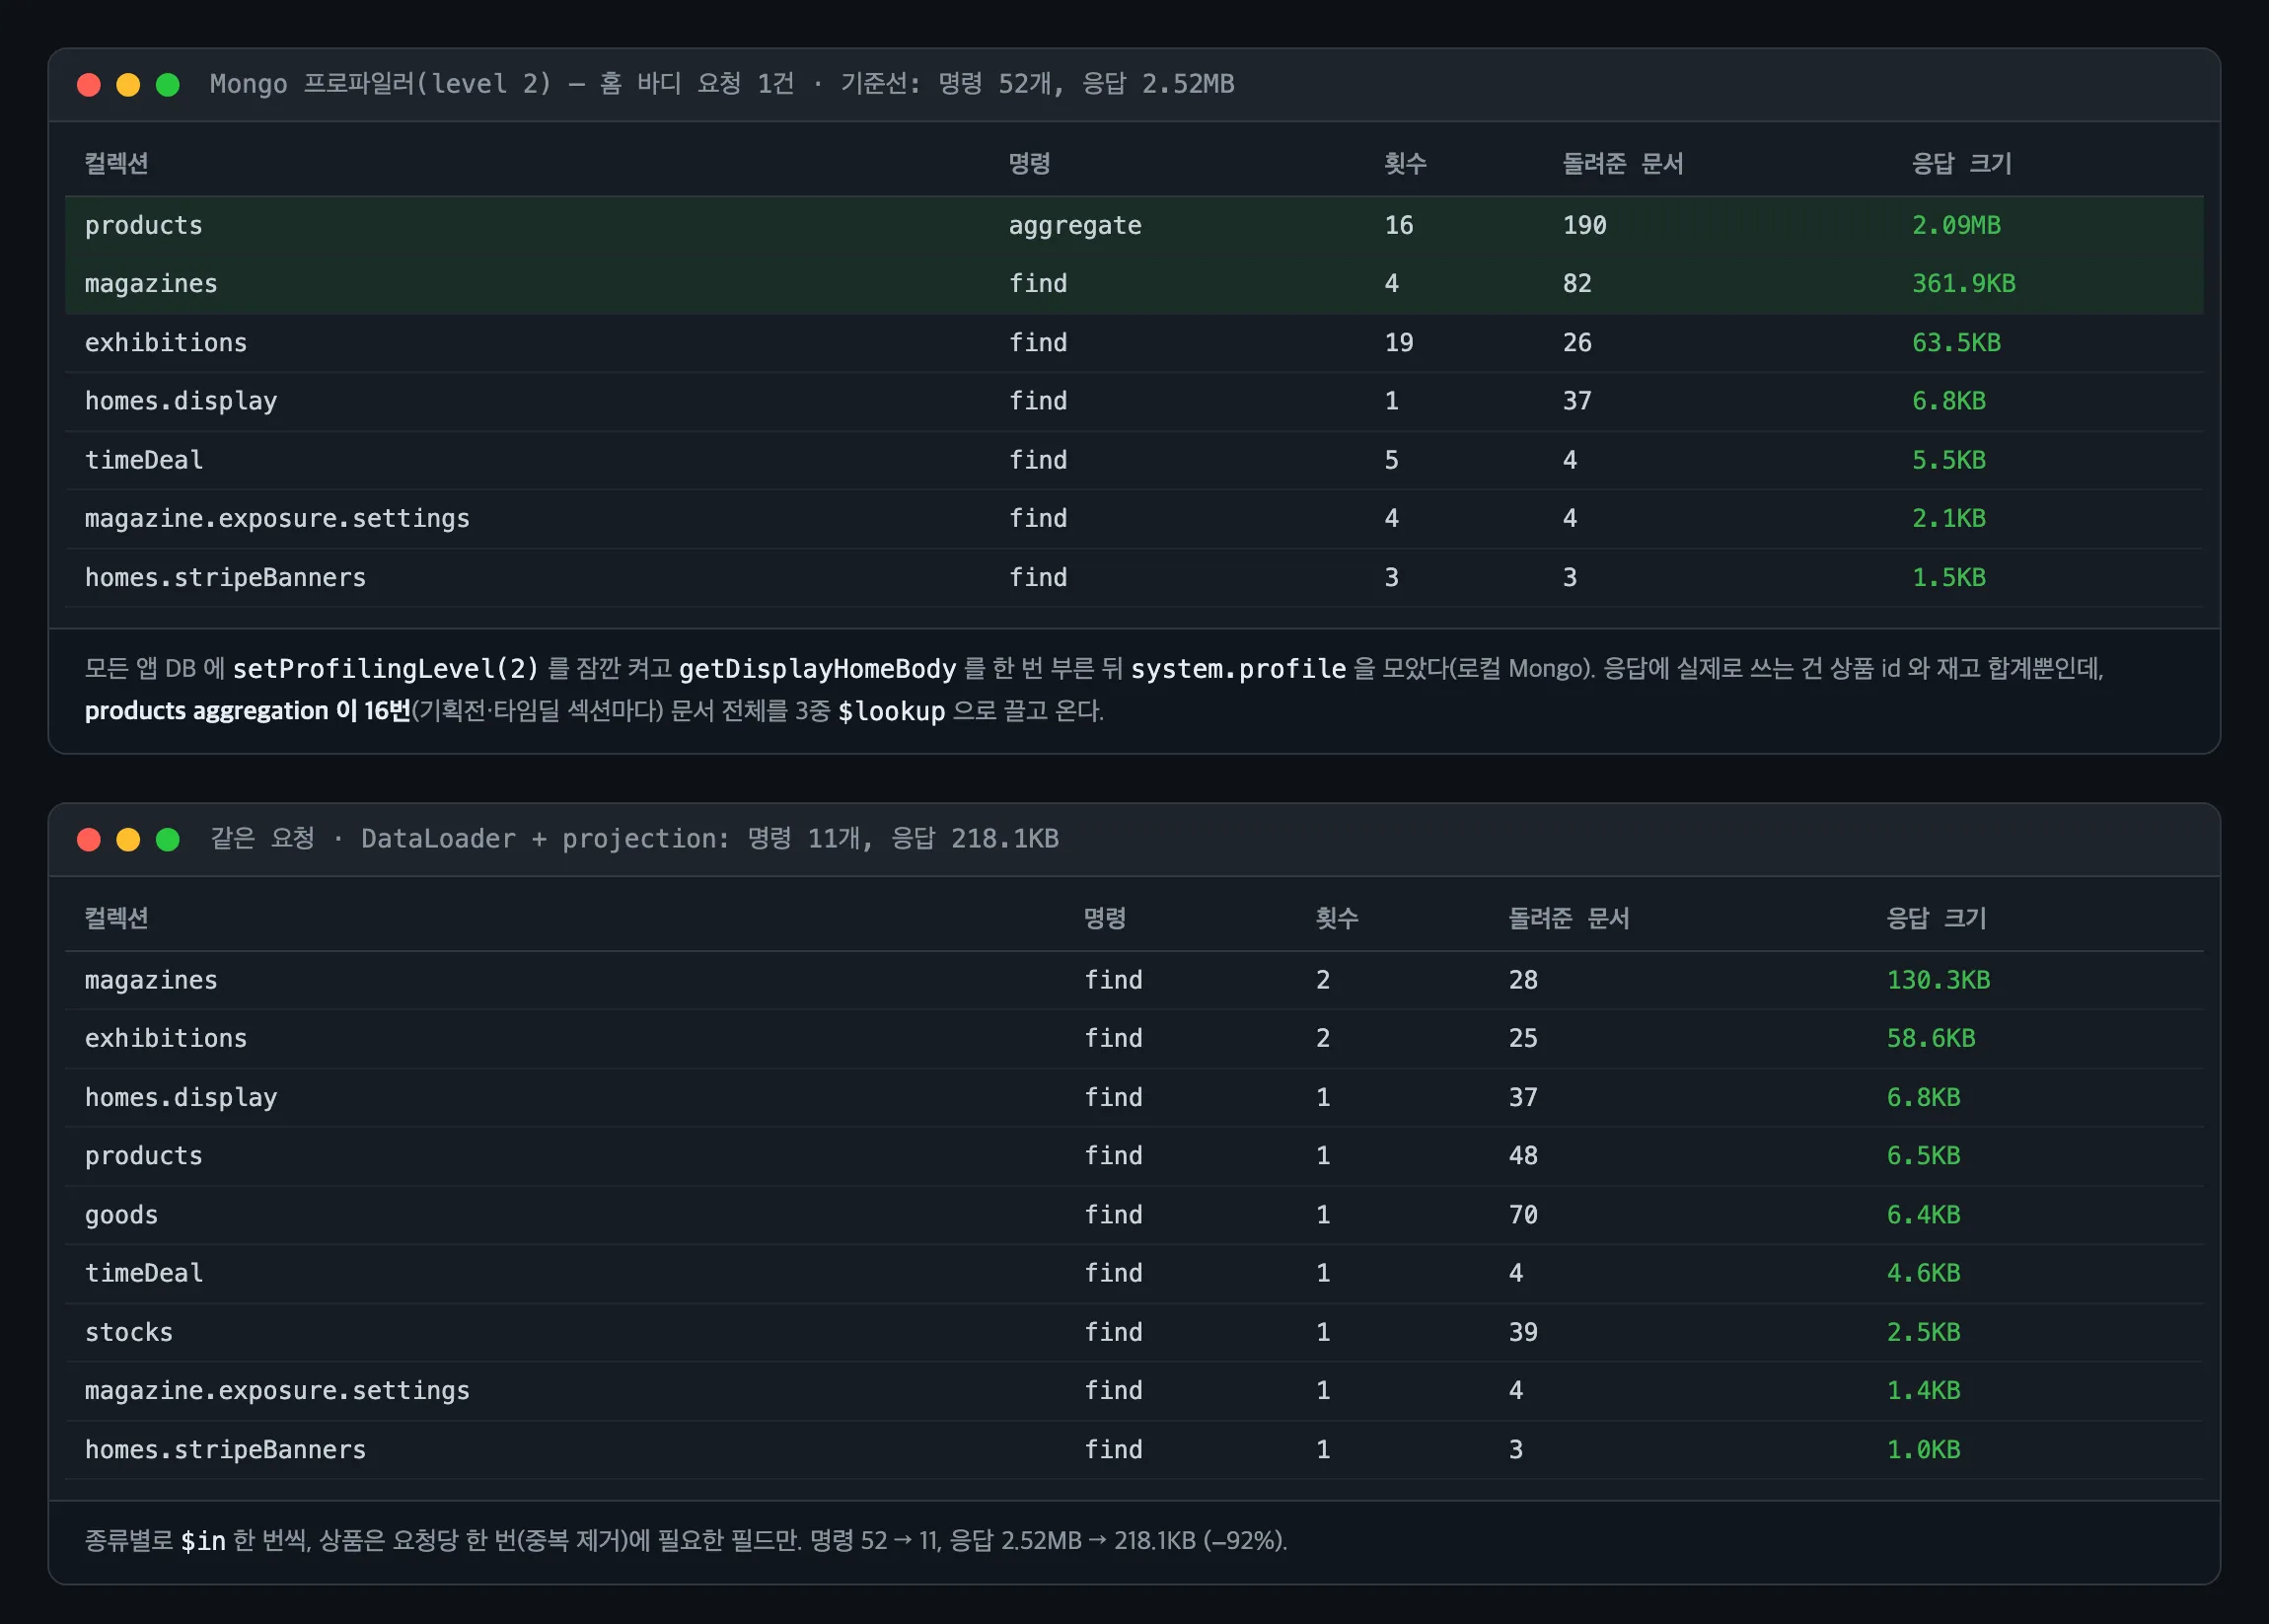
- products aggregation 16번 = 2.09MB. 기획전·타임딜 섹션마다 상품을 따로 조회하고 매번 3중
$lookup(goods → stocks, goods → categories)으로 문서 전체를 끌고 온다. 응답에 쓰는 건 상품 id 와 재고 합계뿐이다. - exhibitions findById 19번. 진열마다 한 번씩 — 전형적인 N+1.
- magazines 4번 = 362KB. "전체" 매거진 목록을 그룹마다 같은 걸 다시 읽는다.
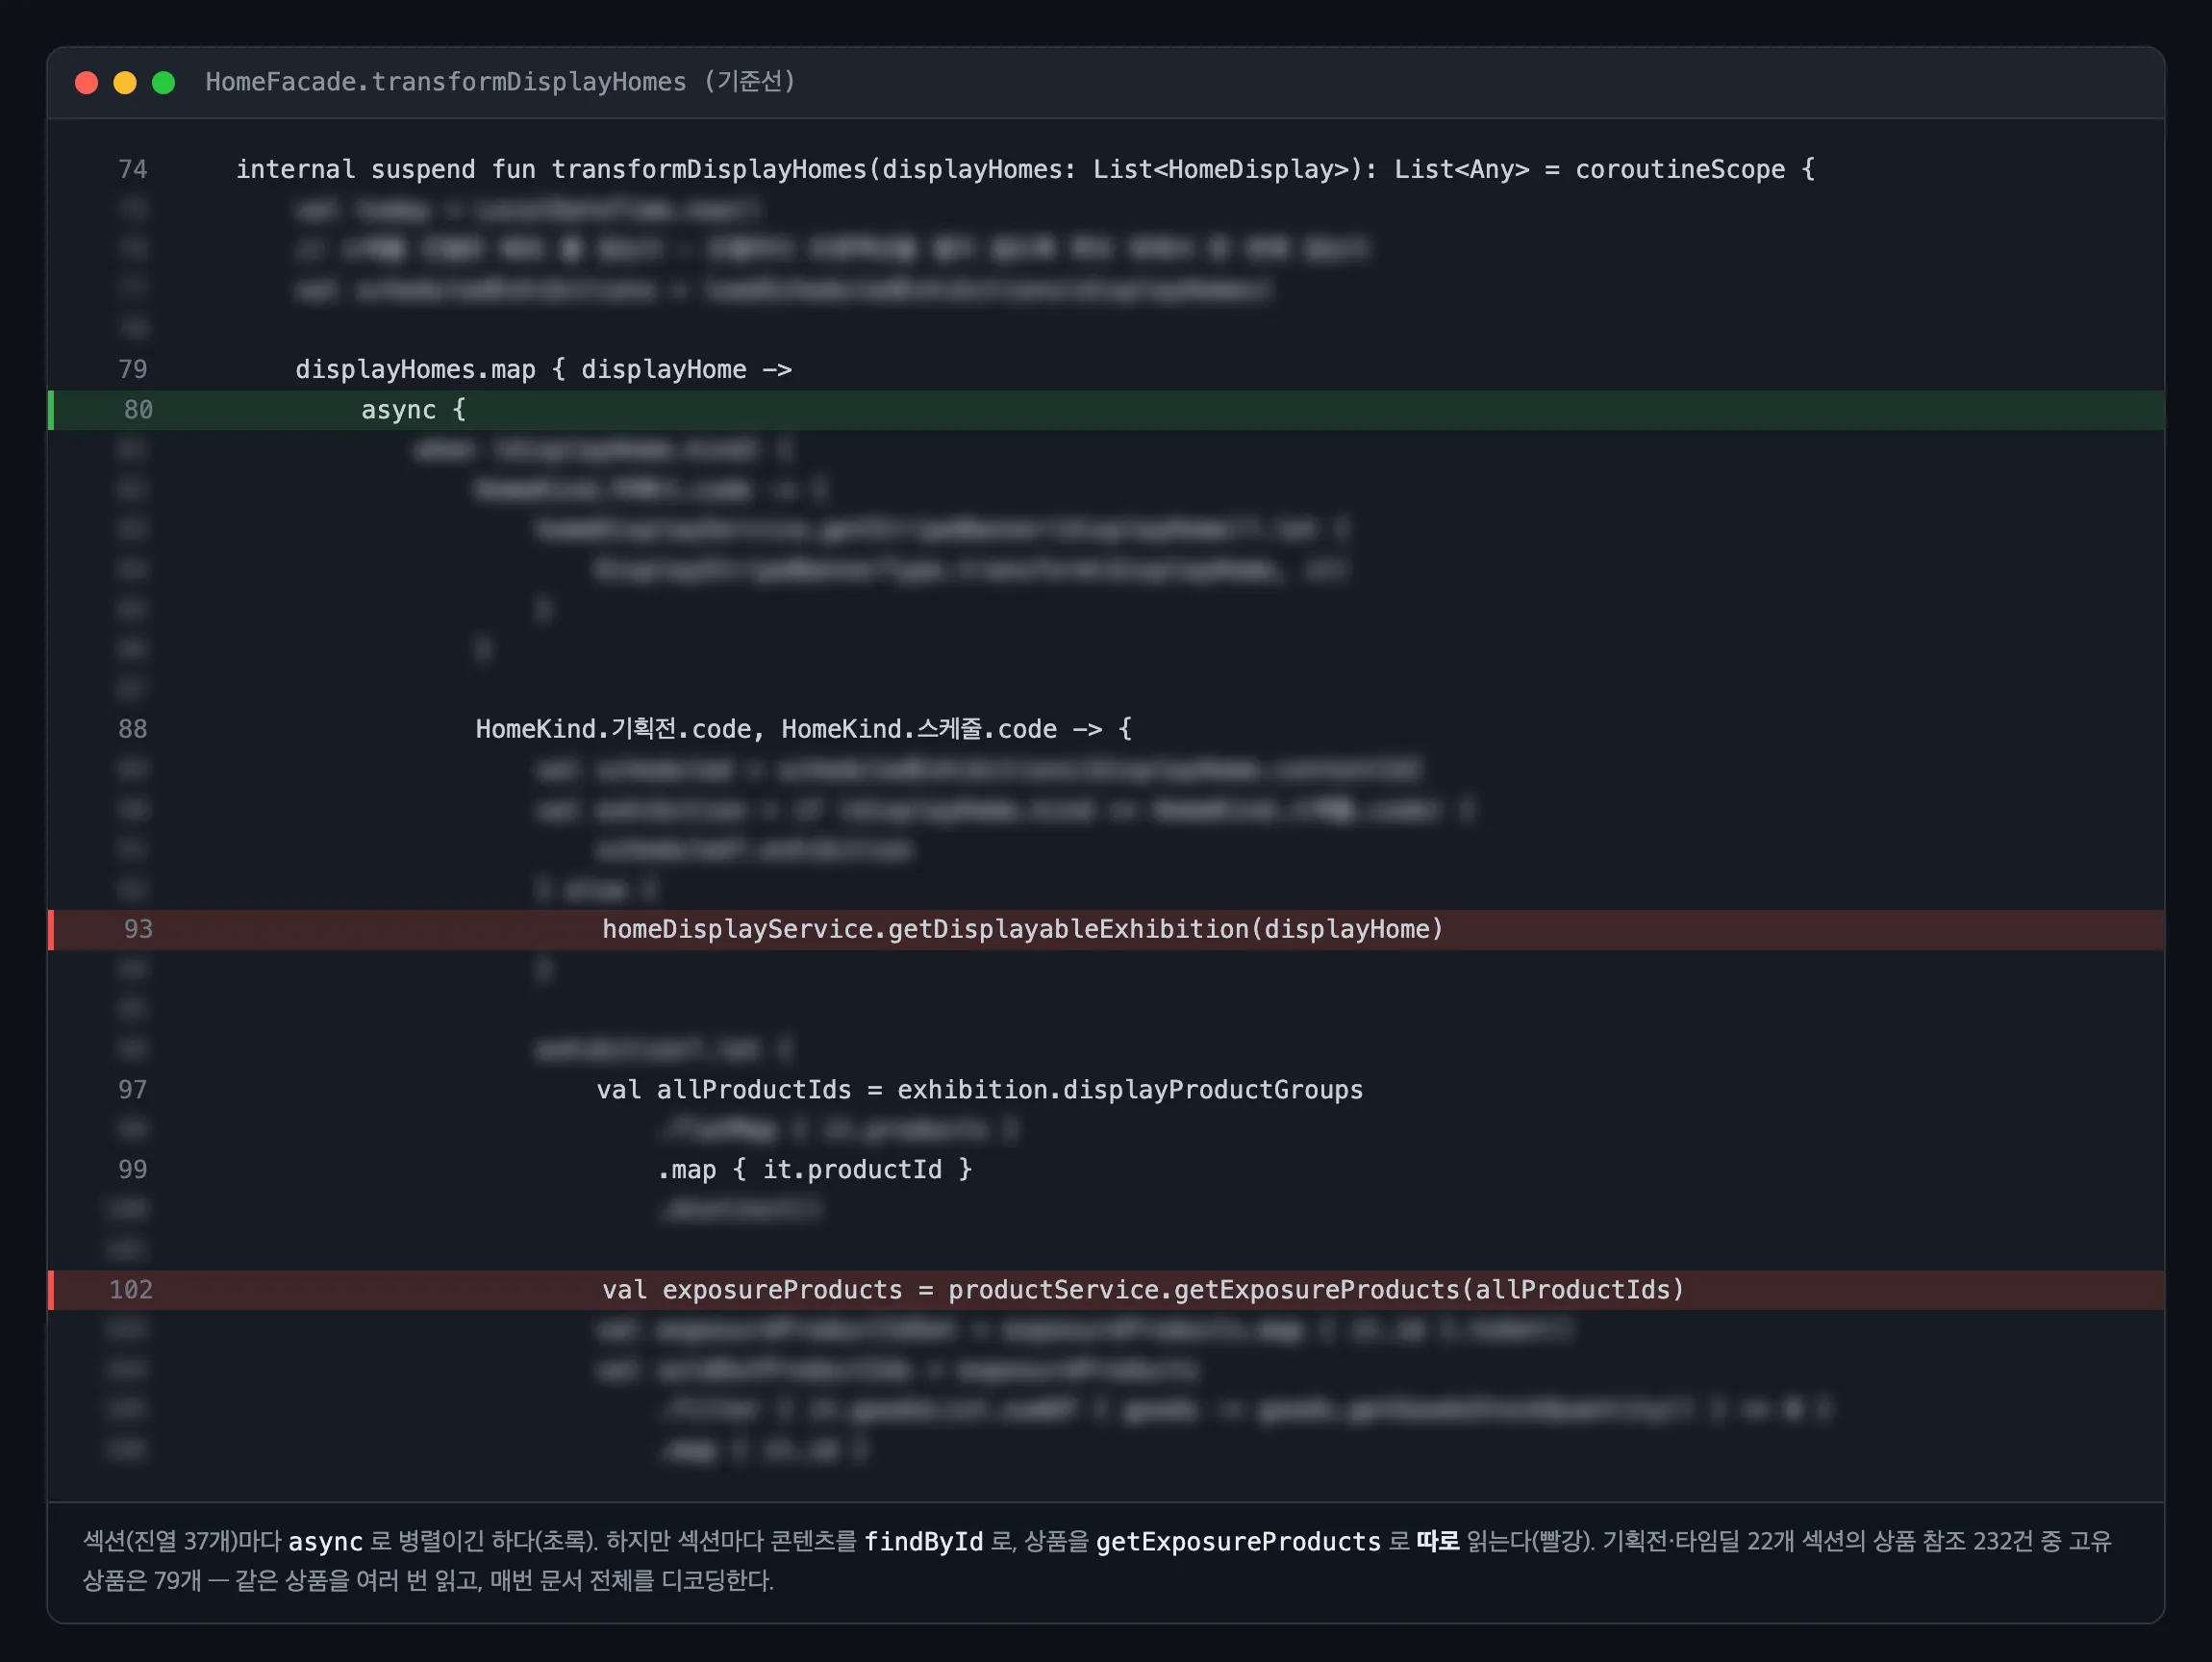
상품이 있는 섹션 22개의 상품 참조 232건 중 고유 상품은 79개뿐이다. 같은 상품을 여러 번 읽으면서 매번 문서 전체를 디코딩한다.
2-1. CPU 는 어디에 쓰이나
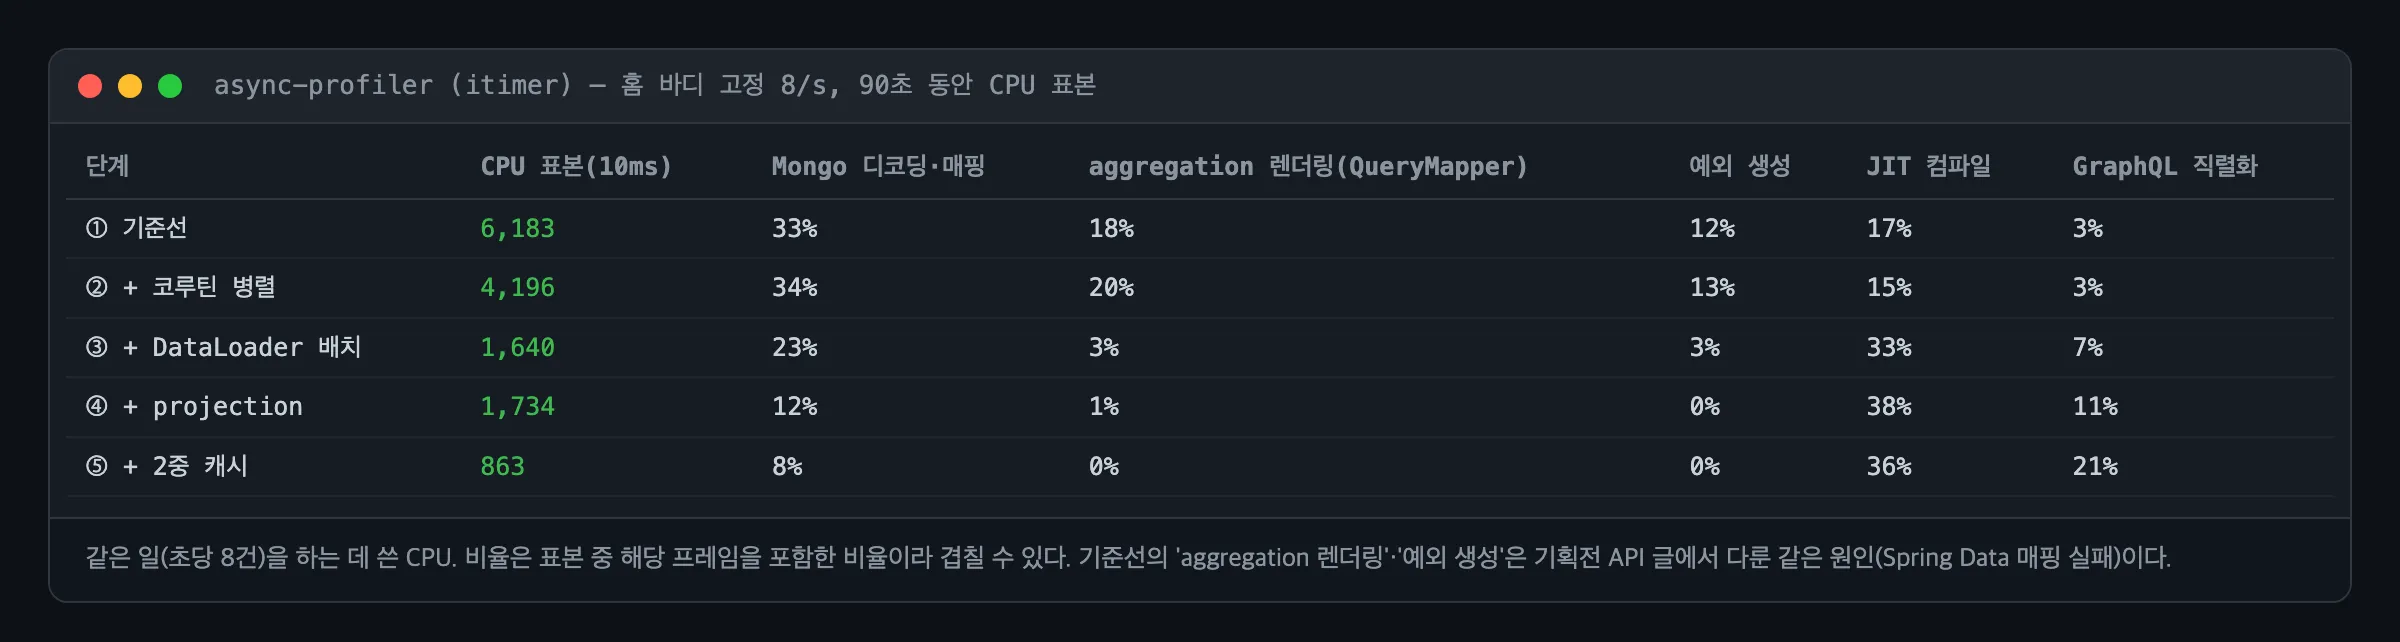
기준선은 CPU 의 약 1/3 을 Mongo 문서를 객체로 바꾸는 데(디코딩·매핑), 18% 를 aggregation 을 만드는 데(QueryMapper), 12% 를 예외를 만드는 데 쓴다. 마지막 두 항목은 기획전 API 글에서 찾은 것과 같은 원인이다 — 같은 상품 aggregation 이 엔티티에 없는 경로를 매핑하며 예외를 만든다. 정리하면, 이 API 는 쓰지도 않을 데이터를 많이, 비싸게 읽는다.
3. 첫 시도 — 병렬화(코루틴)는 왜 효과가 없었나
가장 먼저 떠오르는 개선은 "느리면 동시에"다. 섹션 단위는 이미 병렬이라 남아 있던 순차 구간 두 곳(스케줄 편성 조회, 옛 노출 설정 조회)을 겹쳤다.
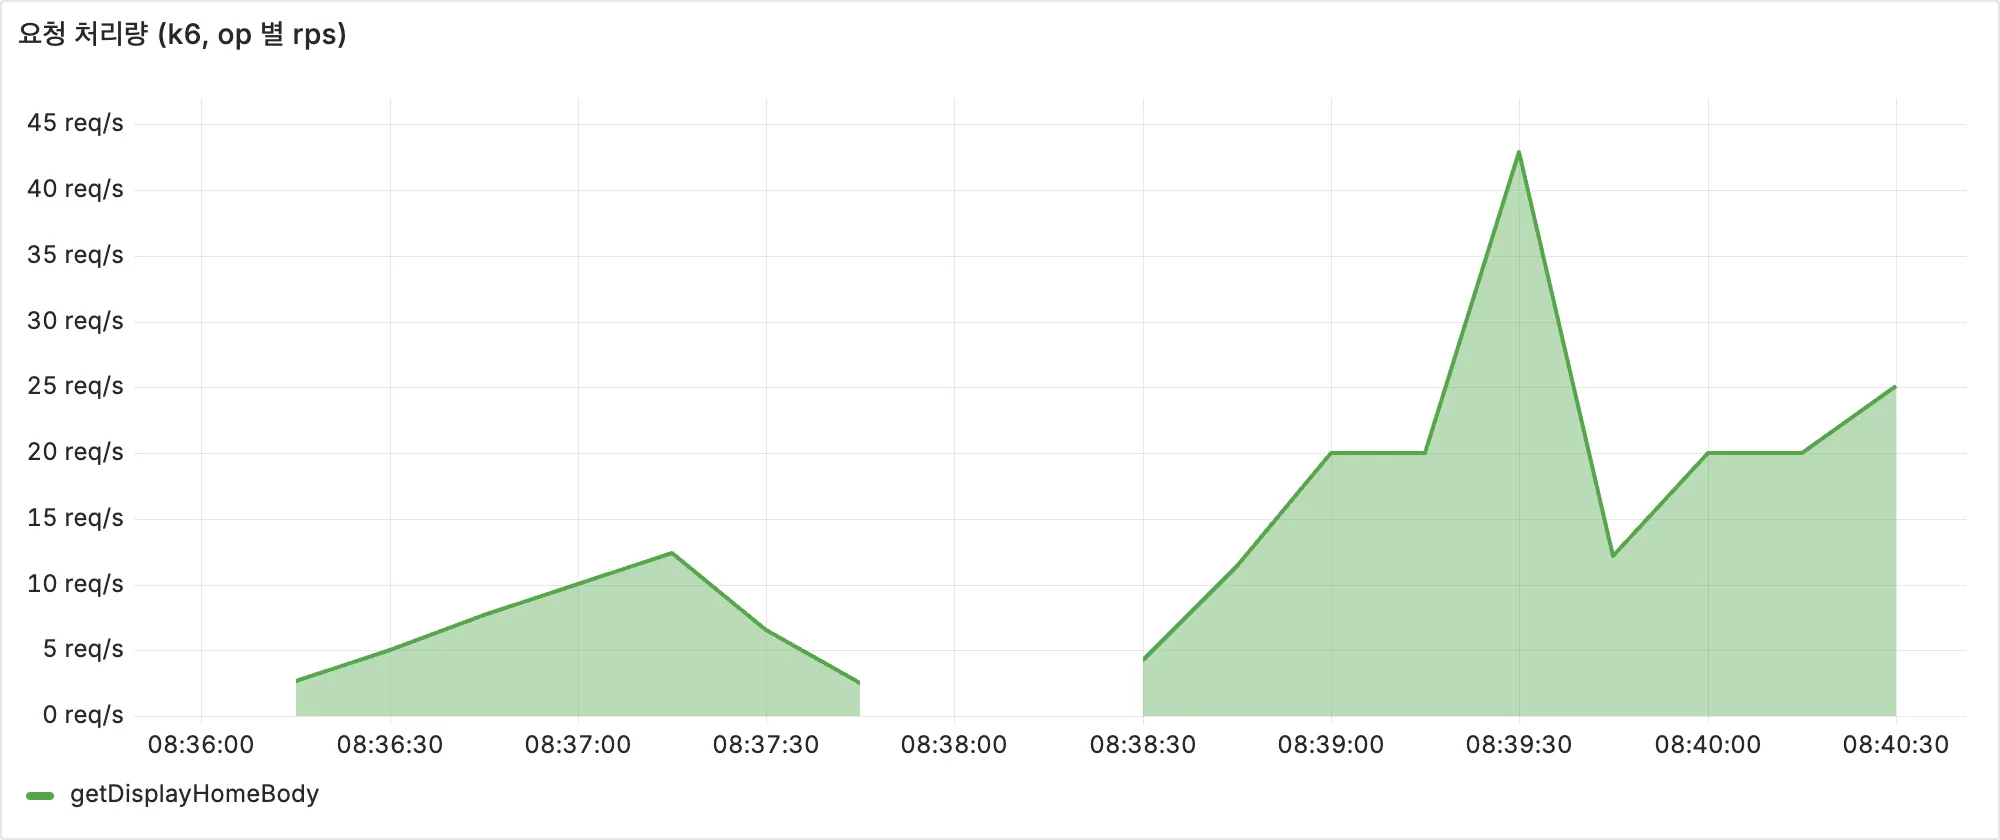
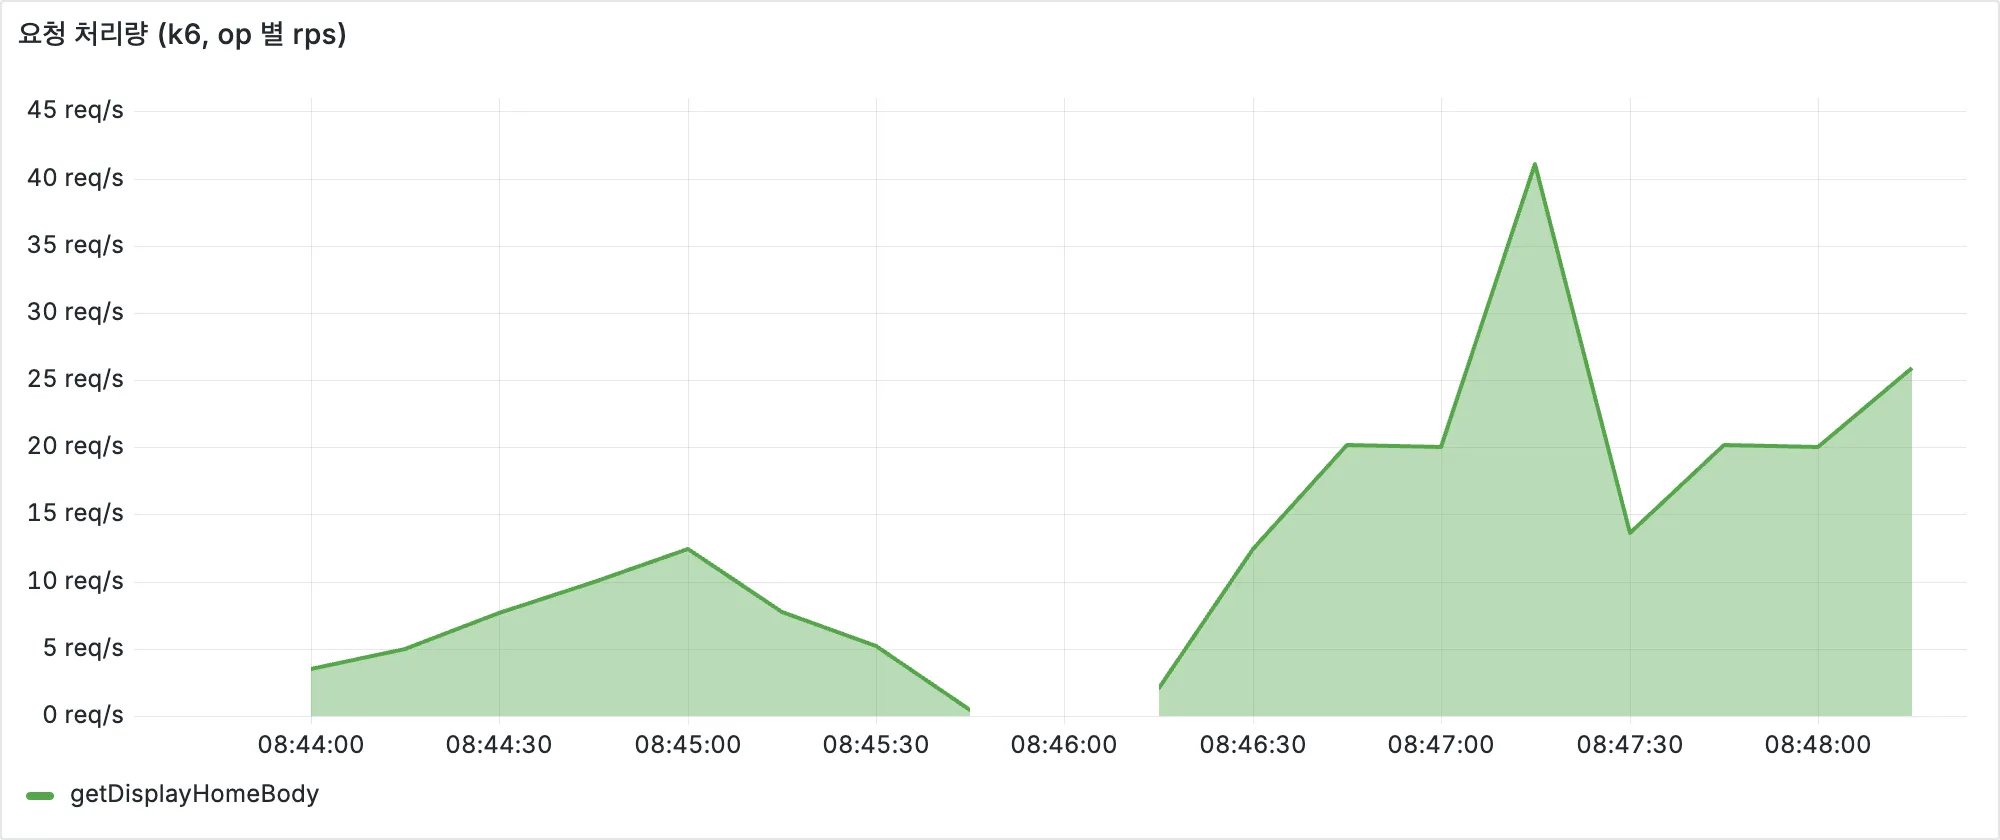
1코어에서 CPU 가 이미 100% 면, 일을 동시에 시켜도 일의 총량은 같다. 병렬화가 줄이는 건 기다리는 시간(네트워크 왕복 같은)이지 일하는 시간이 아니다. 고정 8/s 의 p95 는 4.5초 → 35ms 로 좋아 보였다. 하지만 기준선의 고정 부하 구간 초반에 지연이 튄 영향이 커서 병렬화의 효과라고 단정하지 않았다(같은 코드 경로인 ③ 도 35ms 다). 이 단계는 대조군으로 남겼다.
4. 덜 읽게 — DataLoader 배치와 projection
4-1. DataLoader: 같은 걸 여러 번 읽지 않게
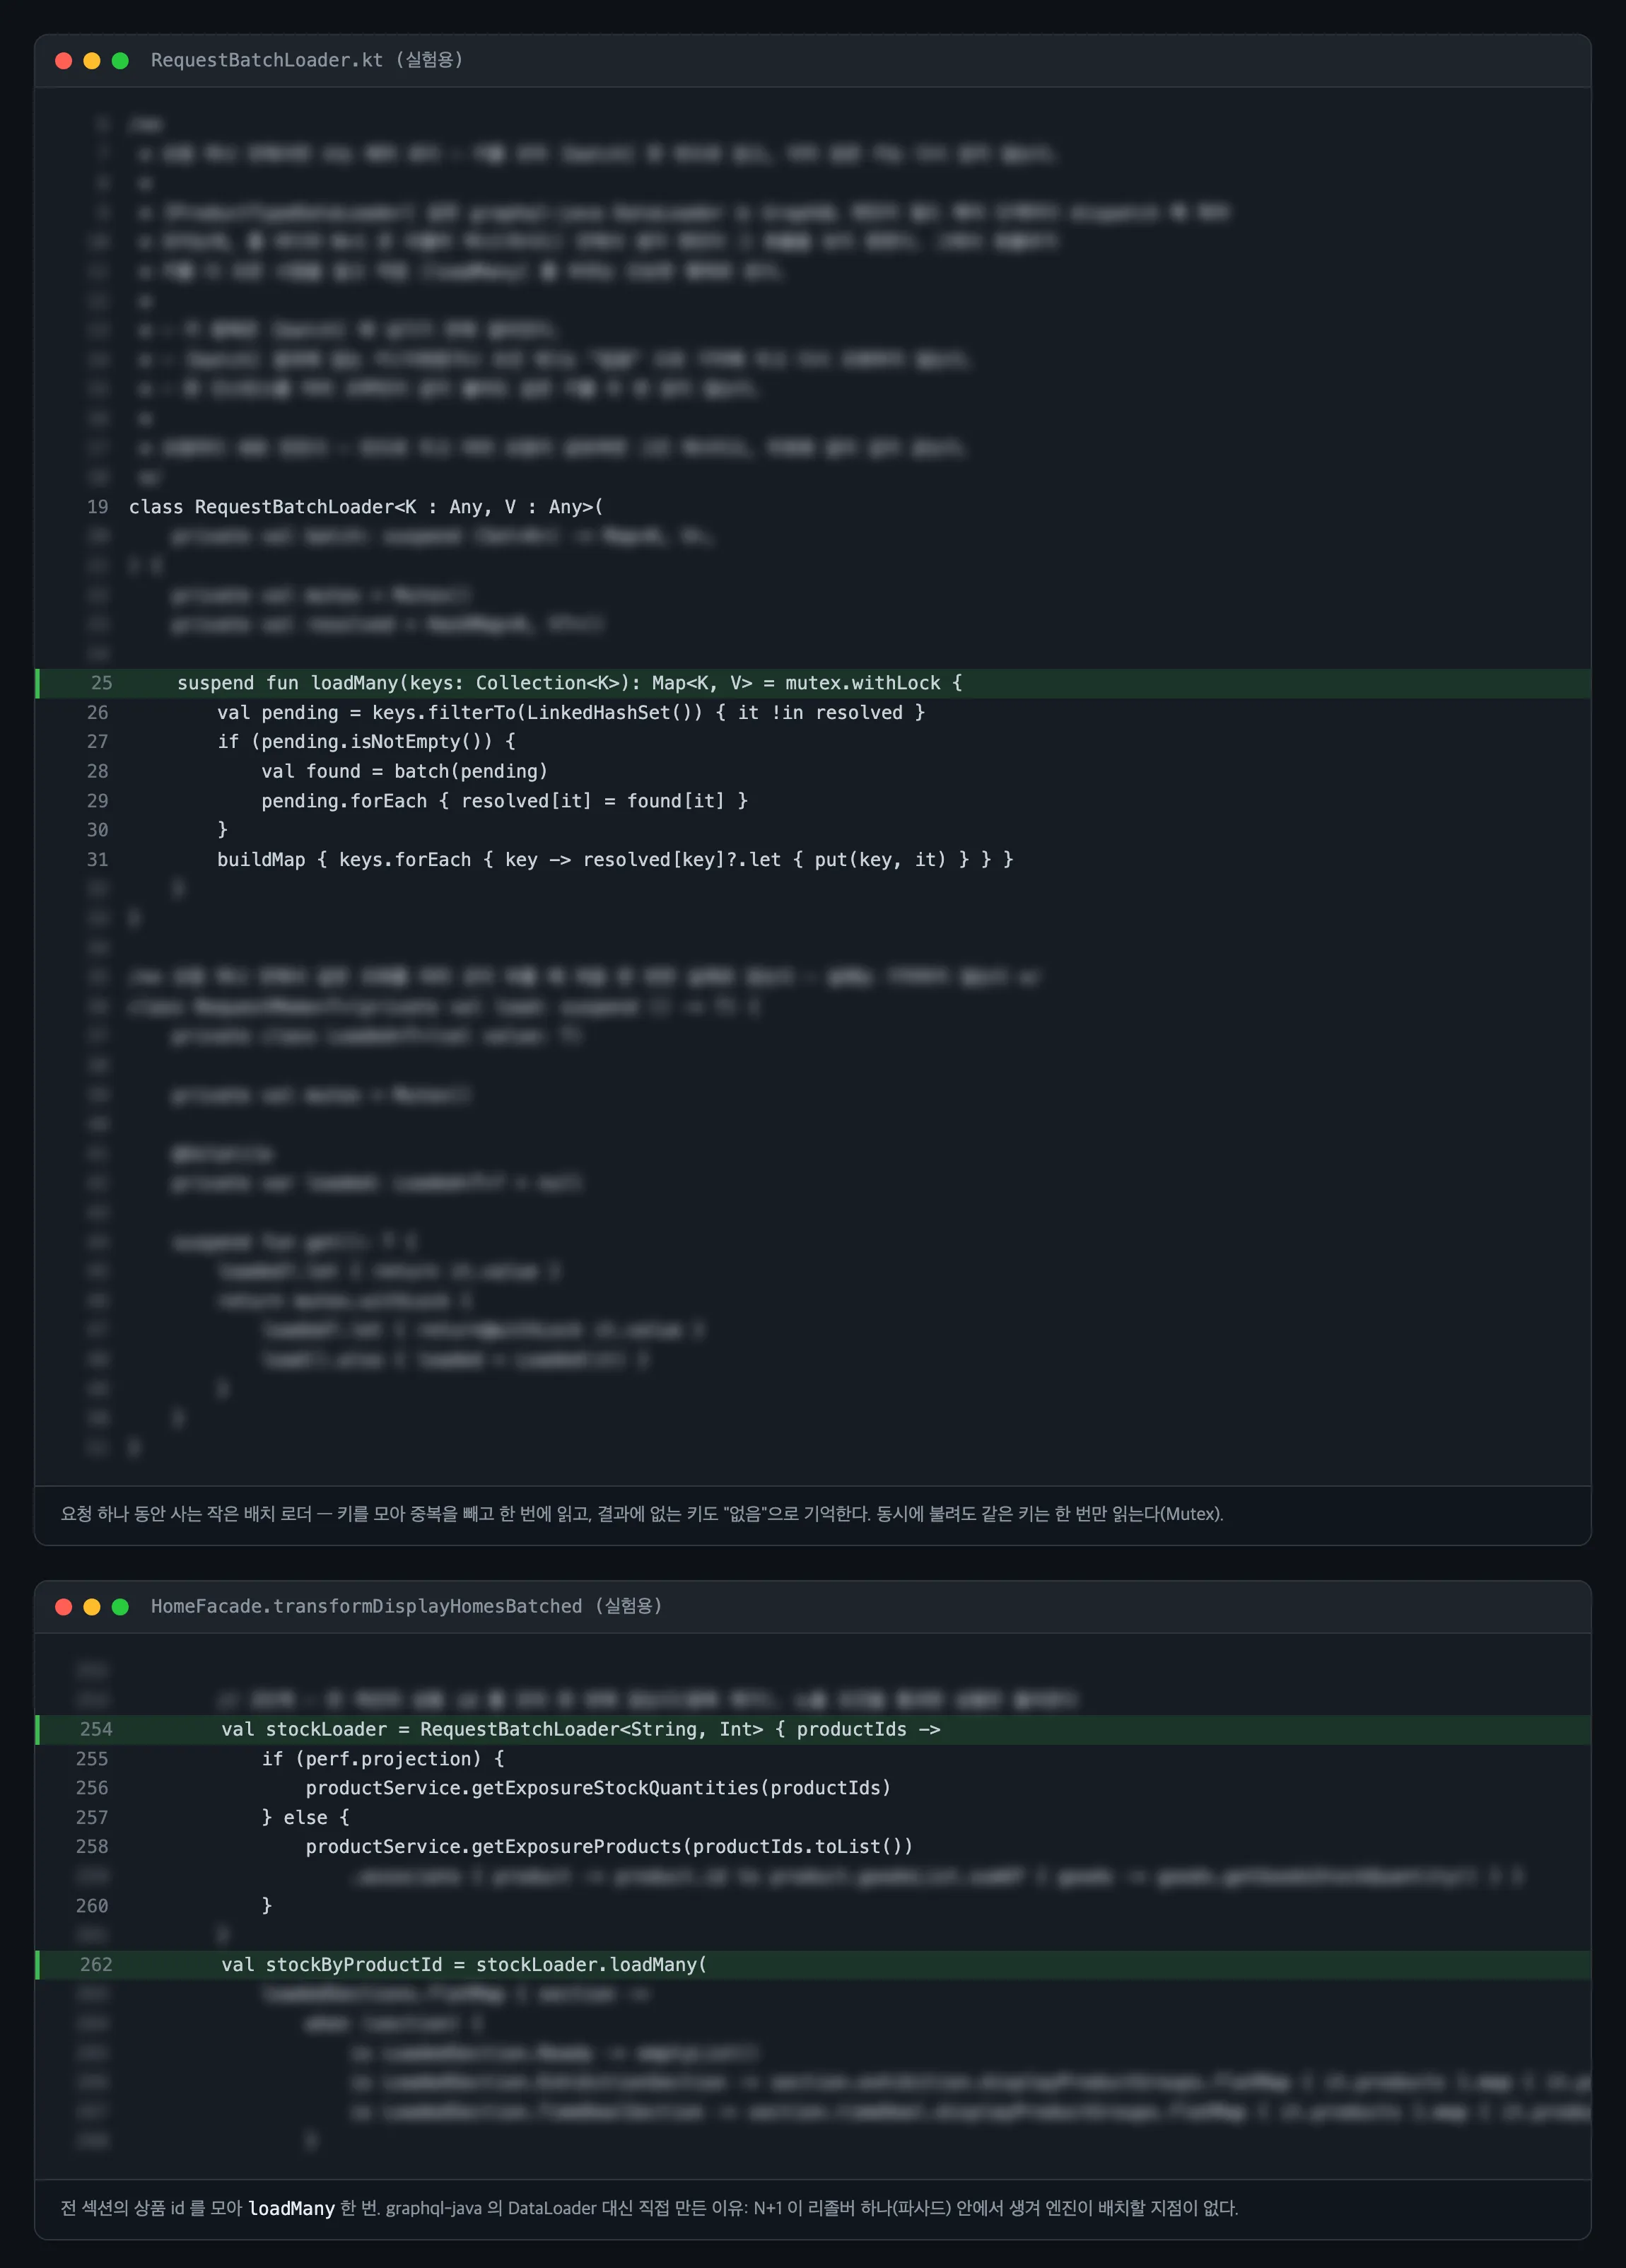
콘텐츠도 종류별로 $in 한 번씩 읽는다(진열 수가 아니라 종류 수만큼). 결과에 없는 키도 "없음"으로 기억해 다시 읽지 않고 동시에 불려도 같은 키는 한 번만 읽는다(Mutex).
graphql-java 의 DataLoader 를 쓰지 않은 이유가 있다. 여기 N+1 은 GraphQL 필드 리졸버가 아니라 리졸버 하나(파사드) 안에서 생긴다. 엔진이 배치를 걸 지점이 없으니 파사드 안에 같은 개념(모으고 → 한 번에 → 나눠 주기)을 직접 만들었다. 결과는 버틴 계단 10 → 40/s.
4-2. projection: 쓰는 필드만
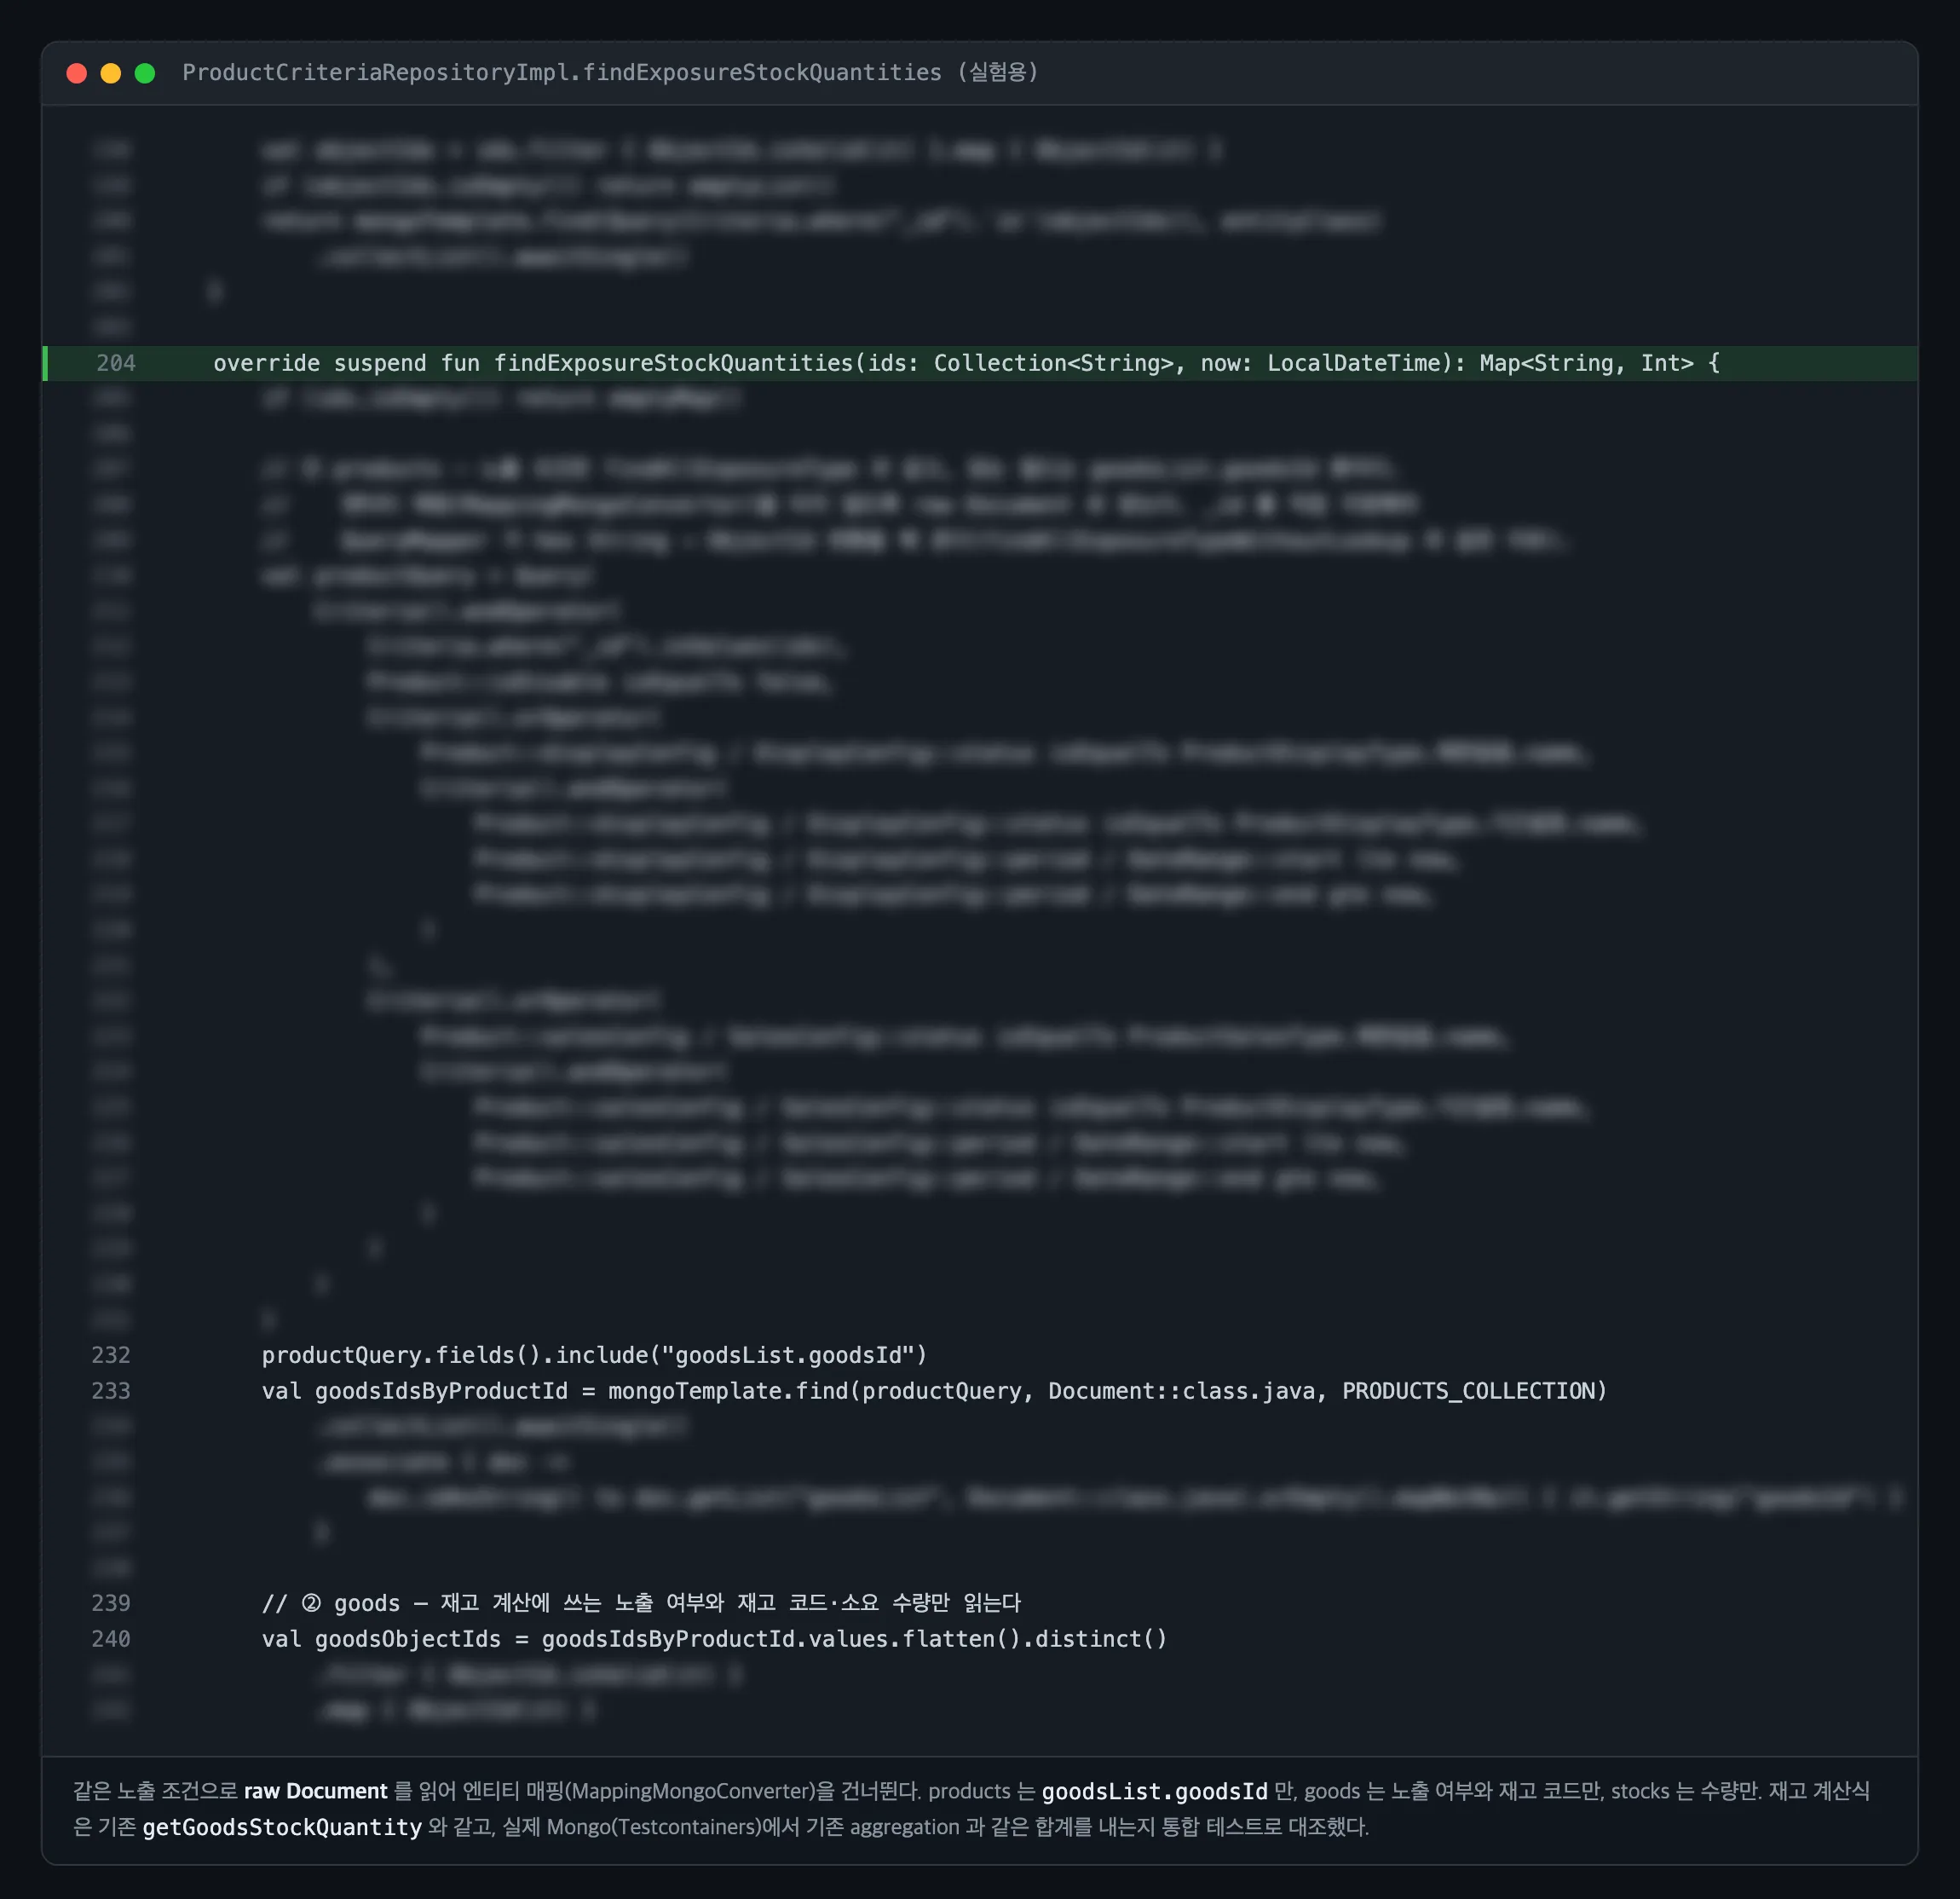
products 는 goodsList.goodsId, goods 는 노출 여부와 재고 코드, stocks 는 수량만 읽는다.
재고 계산식은 기존과 같아야 한다. 무작위 입력 2,000건으로 계산기를 대조했고 실제 Mongo(Testcontainers)에서 기존 aggregation 과 projection 이 같은 재고 합계를 내는지 통합 테스트로 확인한 뒤에 측정했다. 결과는 버틴 계단 40 → 80/s, 최대 109/s.
5. 안 읽게 — 2중 캐시(L1 Caffeine + L2 Redis)
홈 본문은 로그인·등급·플랫폼과 무관하게 모두에게 같다. 그러면 매 요청 조립할 이유가 없다.
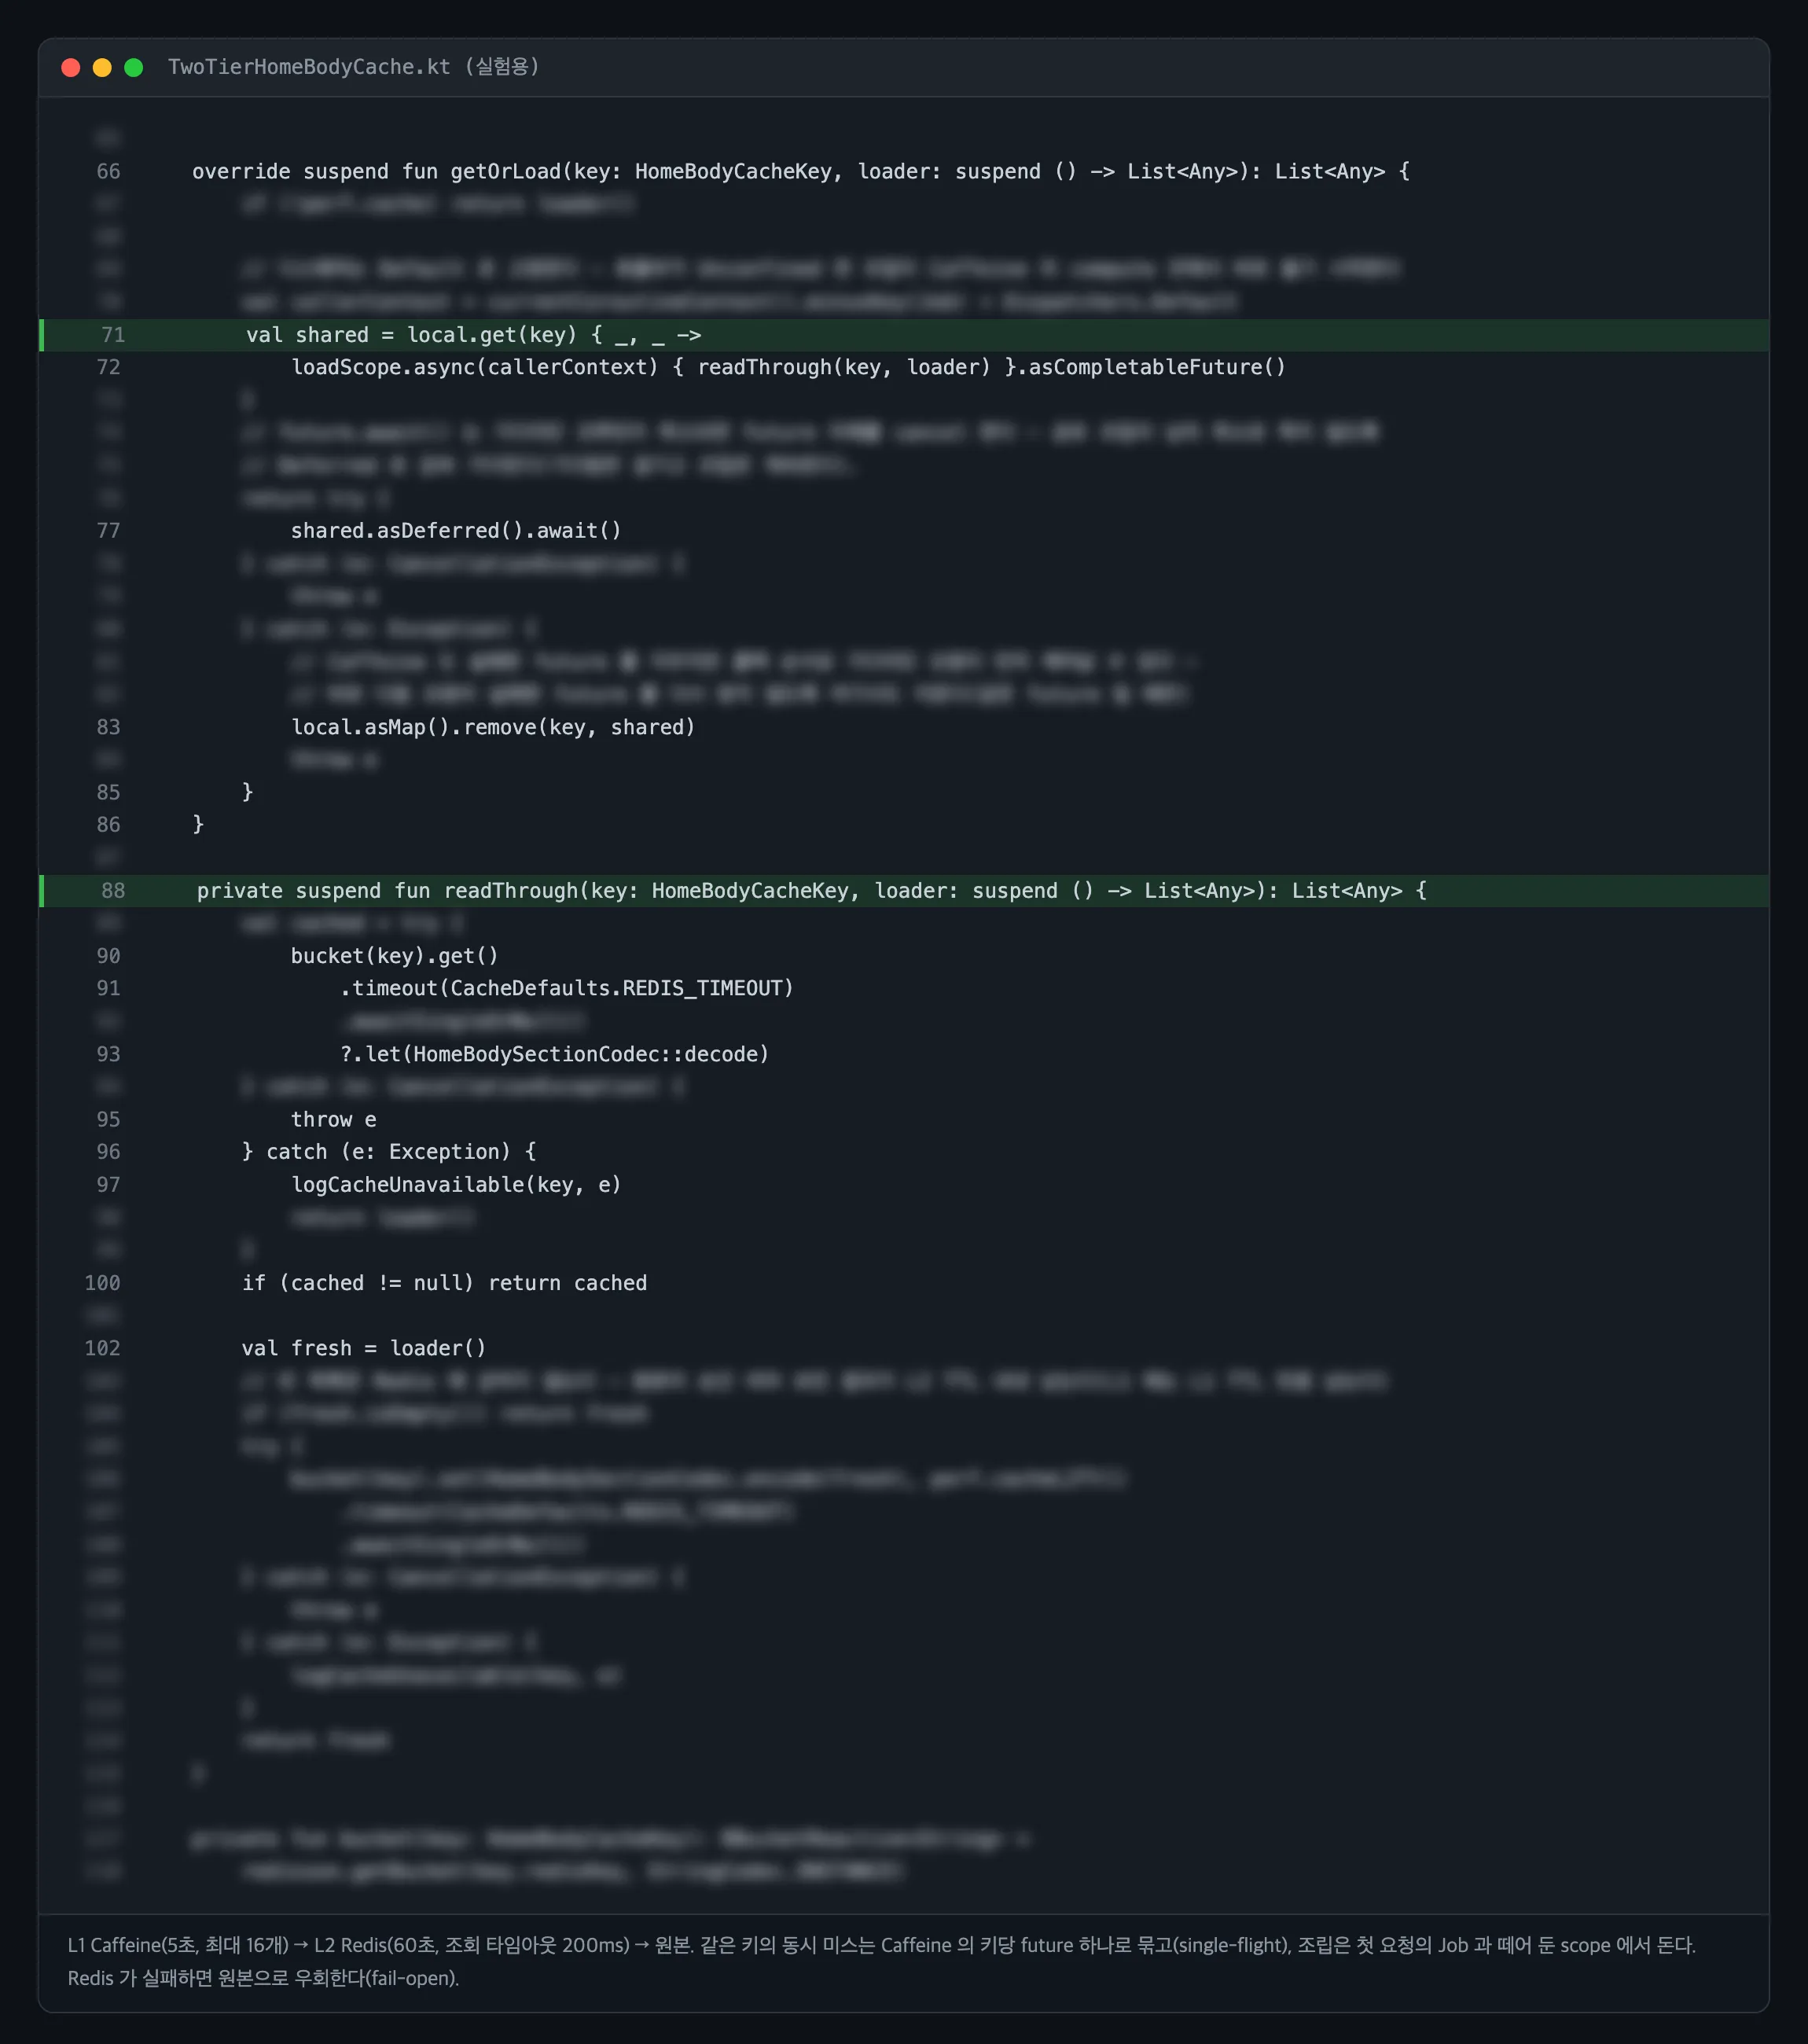
- 왜 2중인가: L1 만 있으면 pod 가 늘수록, 배포할 때마다 모든 pod 가 각자 조립한다. L2 만 있으면 요청마다 Redis 왕복과 역직렬화를 낸다. L1 이 대부분을 받고 L1 이 빈 pod 는 L2 에서 채운다.
- 상품 카드는 캐시하지 않는다: 캐시에는 섹션 구조와 상품 id 만 넣고 재고처럼 자주 바뀌는 카드는 응답 시점에 채운다.
- Redis 가 실패하면 원본으로(fail-open). 조회 타임아웃 200ms. 캐시 때문에 요청이 실패하지 않게.
- 놓치기 쉬웠던 함정 두 가지(구현 중 테스트로 잡았다):
CompletableFuture.await()는 기다리던 코루틴이 취소되면 future 자체를 취소한다 → 같이 기다리던 다른 요청까지 실패.asDeferred().await()로 기다린다.- Caffeine 이 실패한 future 를 지우는 콜백보다 다음 요청이 먼저 오면 실패한 future 를 그대로 받는다 → 실패할 때 직접
remove(key, future).
주의: ⑤ 의 수치는 "캐시 히트 처리량"이다. ③·④ 처럼 원본 경로가 좋아진 것과 성격이 다르다. 캐시가 비는 순간(배포 직후, TTL 만료)의 비용은 ④ 의 수치가 말한다 — 그래서 ④ 를 먼저 했다.
6. 결과
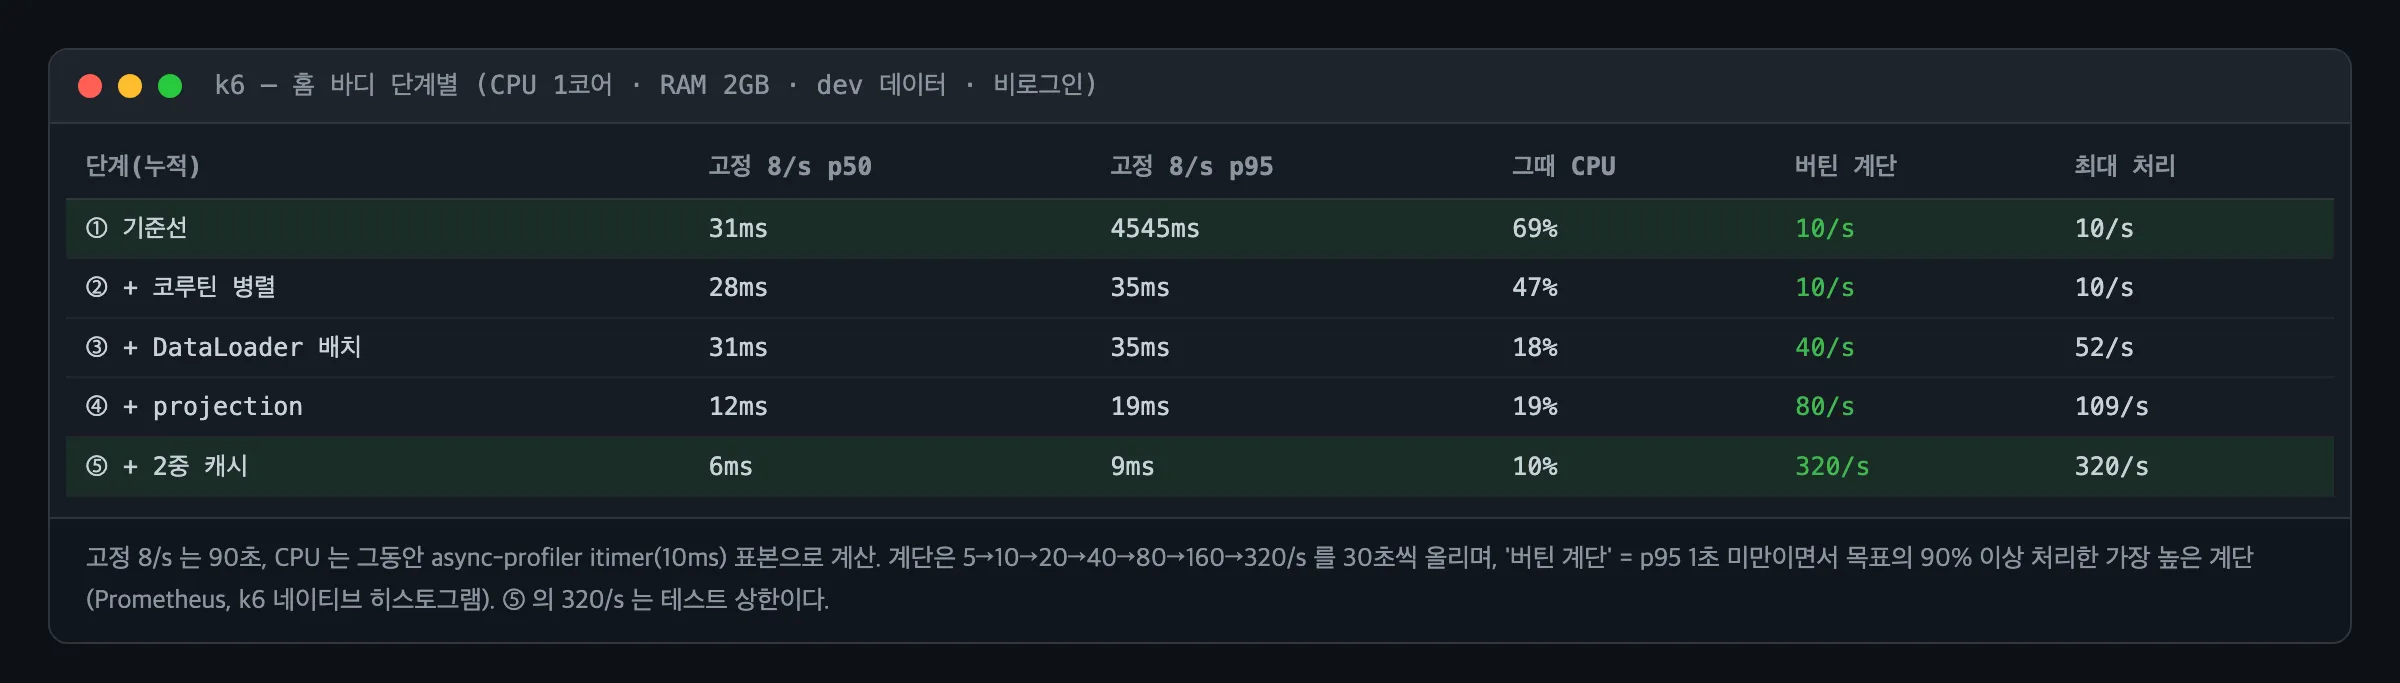
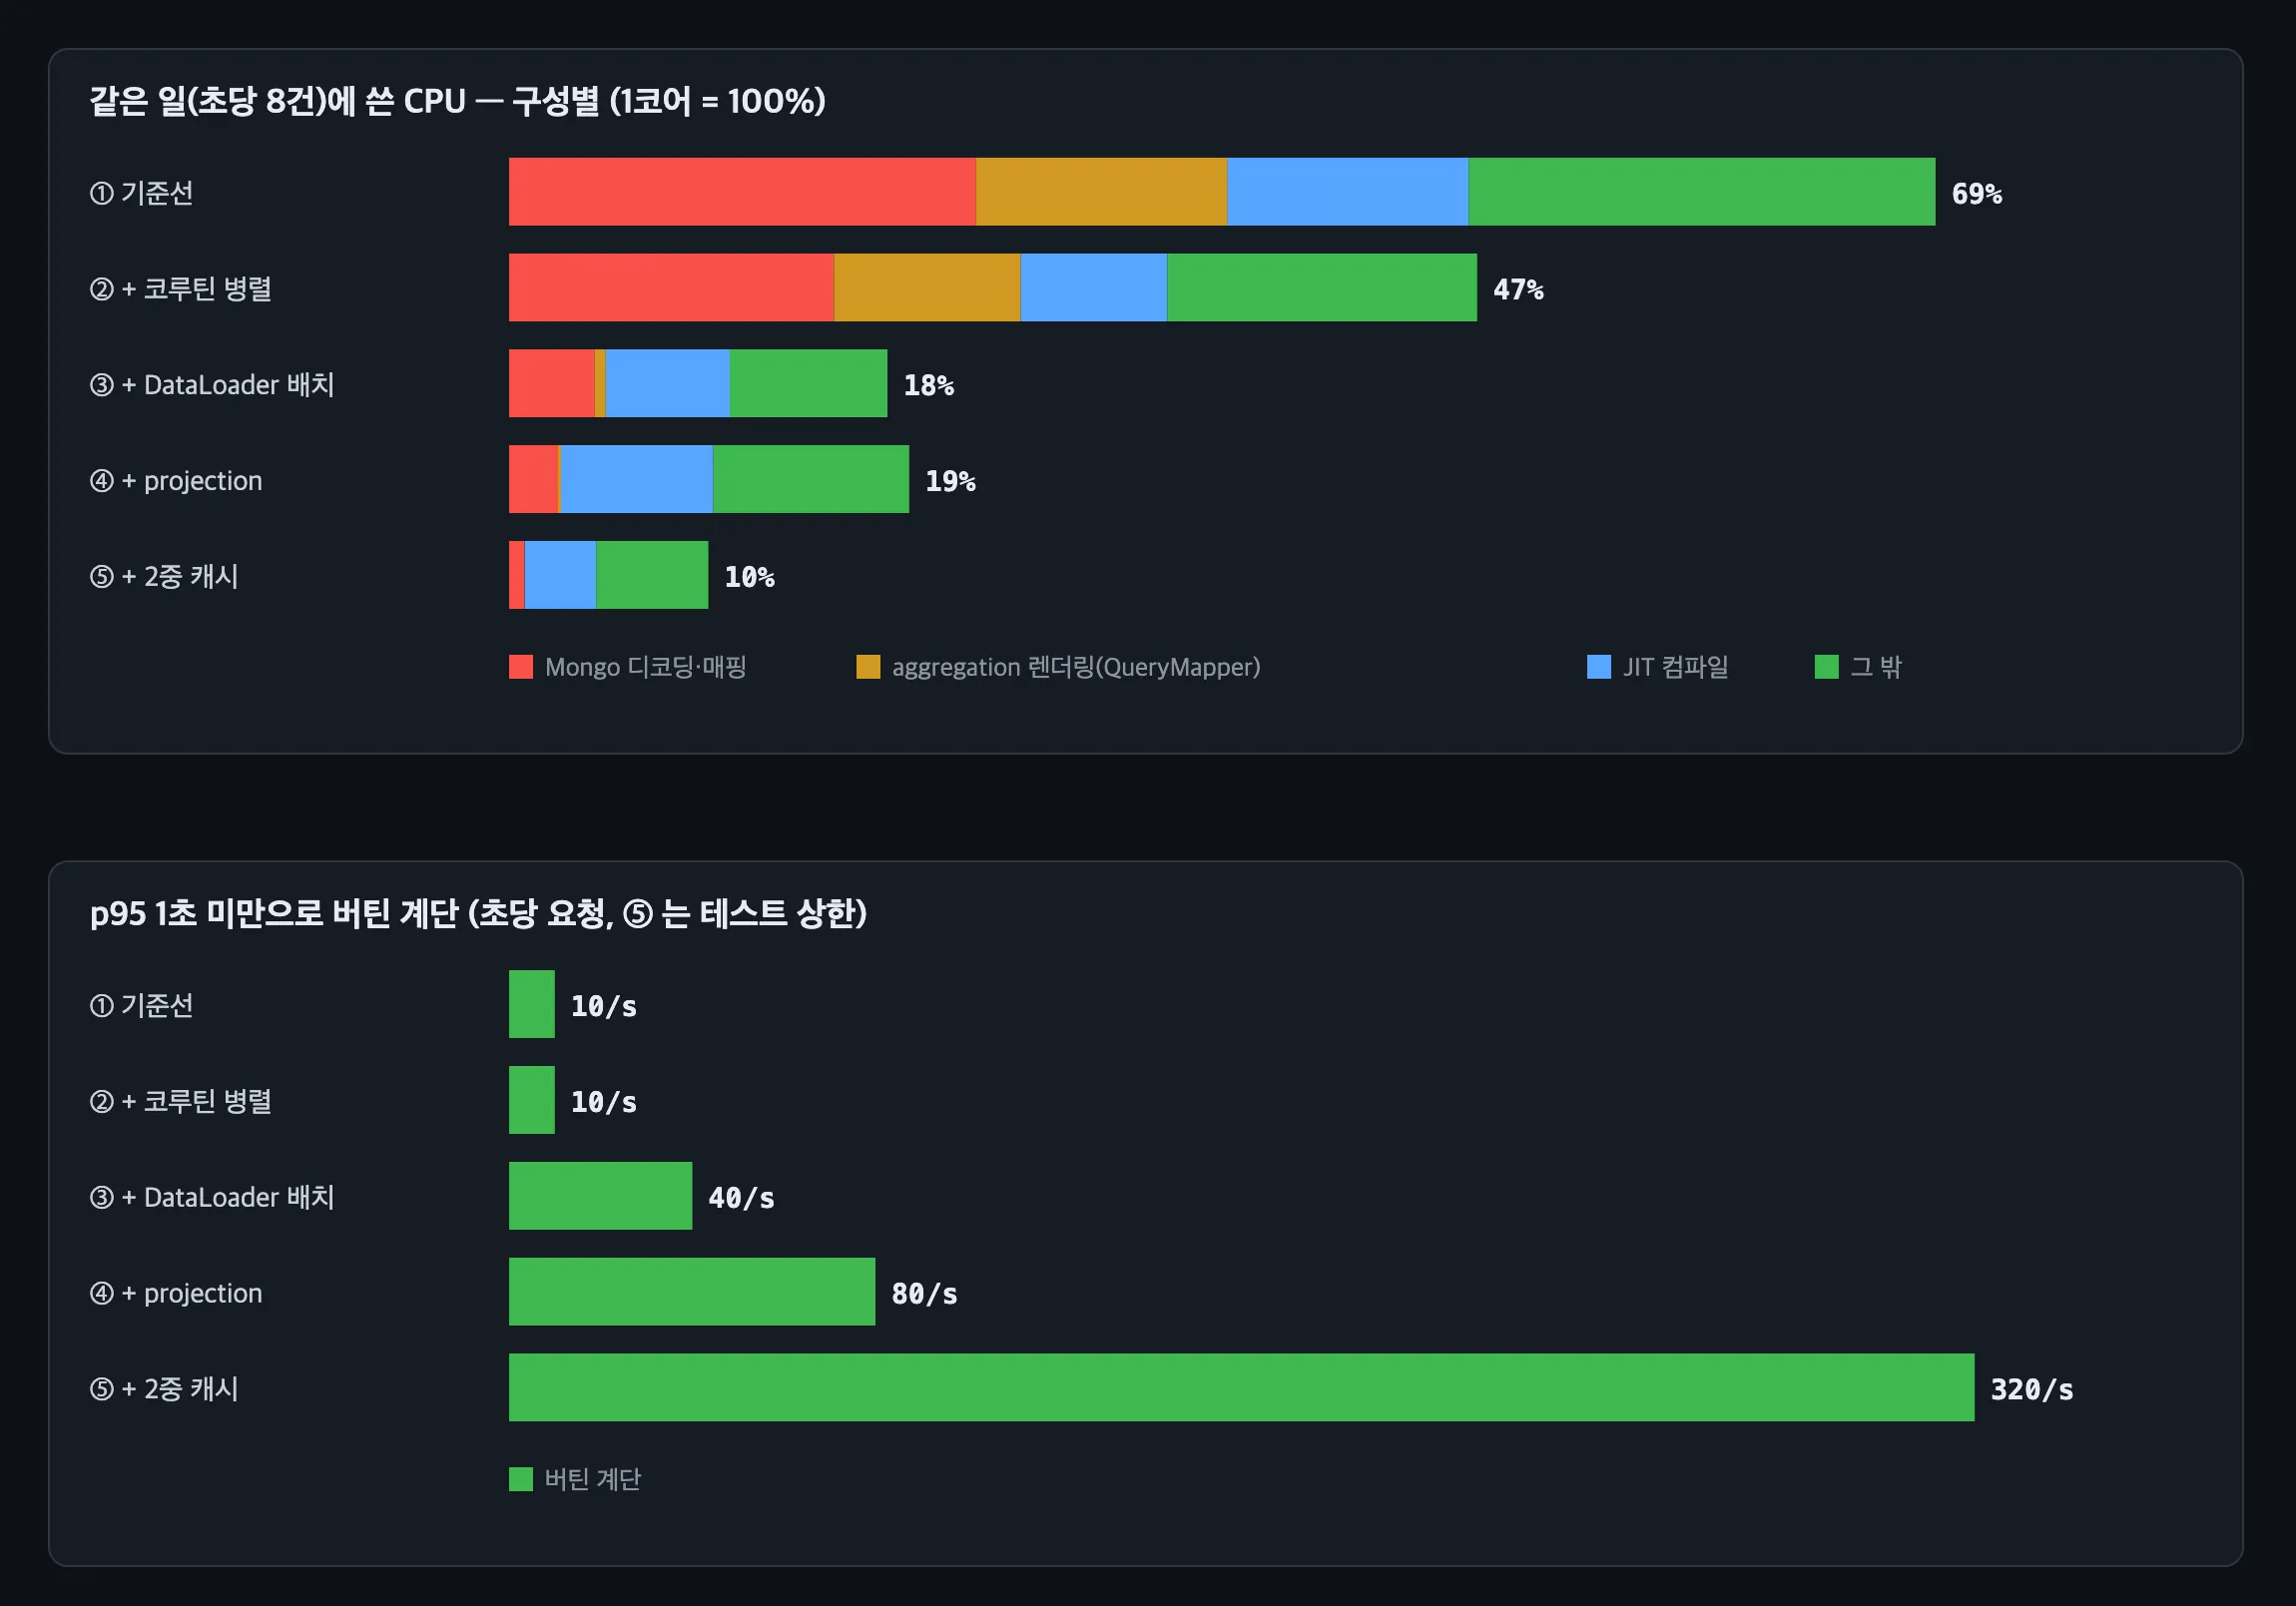
CPU 그래프에서 ③ 이후 남은 파란 부분(JIT 컴파일)은 데운 지 2~3분밖에 안 된 서버라서다. 나머지가 줄수록 상대적으로 커 보인다.
7. 배운 것과 남은 것
- 모니터링이 질문을 정하고 프로파일러가 답한다. CPU 100%(일이 많다) → Mongo 35MB/s(많이 읽는다) → 프로파일러(무엇을 얼마나) 순서로 좁히자 개선 순서가 저절로 나왔다.
- CPU 병목에 병렬화는 답이 아니다. 처음 떠올린 개선이 가장 효과가 없었다. 먼저 "덜 읽게", 그다음 "안 읽게".
- DataLoader 는 GraphQL 기능이 아니라 개념이다. 리졸버 하나 안의 N+1 에도 같은 생각(모으고-한 번에-나눠 주기)이 통한다.
남은 것도 있다.
- 캐시 무효화는 TTL 뿐이다. 어드민이 진열을 바꾸거나 기획전이 끝나도 최대 약 65초(L2 60초 + L1 5초) 늦게 반영된다. 어드민 변경 이벤트로 지우는 방식이 다음 단계다.
- pod 간 single-flight 는 없다. L2 가 동시에 비면 pod 수만큼 조립한다(④ 덕분에 한 번이 싸다).
- projection 은 계산식을 한 벌 더 두는 것이다. 재고 규칙이 바뀌면 두 곳을 같이 고쳐야 해서 같은 결과를 내는지 통합 테스트로 묶어 두었다.
- 인덱스는 확인하지 못했다. projection 과 배치 조회는
stocks.code $in을 쓰는데 이 인덱스가 운영에 있는지는 확인하지 않았다. - 측정 노이즈 — 같은 코드인 ①·② 의 고정 부하 CPU 가 69% / 47% 로 달랐다. 데운 지 얼마 안 된 서버의 JIT 진행 정도 차이로 보이지만 확인하지 않았다. 그래서 단계 비교는 "버틴 계단"을 주 지표로 썼다.
요약
- 증상: 앱 첫 화면의 홈 본문 API 하나가 1코어에서 초당 10건을 넘기면 무너졌다.
- 원인 찾기: Grafana 에서 CPU 포화와 Mongo 전송량(요청당 약 2.5MB)을 보고 Mongo 프로파일러로 요청 1건을 해부했다 — Mongo 명령 52개, 응답 2,638,266바이트. 그중 상품 aggregation 16번이 2.09MB. 응답에 쓰는 건 상품 id 와 재고 합계뿐이었다.
- 개선(누적): ② 코루틴 병렬 → 효과 없음(10/s) ③ DataLoader 배치 → 40/s ④ projection → 80/s ⑤ 2중 캐시(Caffeine + Redis) → 테스트 상한 320/s 까지 p95 9ms 이하. 요청 1건의 Mongo 일은 명령 52 → 11, 응답 −92%.
- 배운 것: CPU 가 병목일 때 병렬화는 답이 아니다. 먼저 "덜 읽게"(배치·projection), 그다음 "안 읽게"(캐시).
댓글
댓글을 불러오는 중…