코틀린 코루틴의 정석 (1) – 실무 중심으로 다시 공부하는 코루틴
Kotlin
목록 보기숨기기1/1
- 코틀린 코루틴의 정석 (1) – 실무 중심으로 다시 공부하는 코루틴
입사 첫 주, 회사 기술 스택을 익히겠다는 마음 하나로 LINE 조세영 님의 「코틀린 코루틴의 정석」 강의를 결제했었다.
운 좋게 책 증정 이벤트에 당첨되어 책까지 받았지만 정신없이 업무에 몰입하다 보니 그 책은 어느새 모니터 옆에서 먼지를 뒤집어쓰고 있었다.
그로부터 9개월이 지난 지금, 다시 그 책을 꺼냈다.
실무에서 코루틴이 어떻게 쓰이고 어디서 도움이 되며 어떤 함정이 있는지를 직접 코드로 체감해 보려는 것이다.
코루틴은 단순히 비동기를 구현하는 문법이 아니라 시스템의 흐름과 동시성을 이해하는 사고방식이라는 걸 실무를 하며 얕게나마 깨달았다.
그래서 이번에는 왜 이렇게 동작하는지, 서비스 코드에서는 어떻게 활용해야 하는지를 중심으로 처음부터 차근차근 정리해보려 한다.
블로그에는 코루틴의 기본 구조부터 컨텍스트, 스코프, 예외처리, 그리고 실제 비즈니스 로직에 적용하는 과정까지, "실무 감각"으로 다시 공부하는 코루틴의 본질을 기록할 예정이다.
9개월 전의 초심으로 돌아가 한 장씩 다시 넘겨보며 진짜 내 것으로 만들어보려 한다.
✍️이 글은 인프런 「코틀린 코루틴의 정석」 강의와 교재를 기반으로 공부한 내용을 정리한 글입니다.
책의 일부 문구나 문장을 (페이지 표기와 함께) 간단히 인용하지만 전체 내용은 개인적인 해석과 Spring Boot에서의 실무 관점에서 재구성한 것입니다.
스레드 기반 작업
Kotlin의 실행 진입점은 main함수다. 어플리케이션이 시작되면 JVM이 프로세스를 띄우면서 메인 스레드가 함께 생성되고 이후 요청 처리나 비동기 작업, 스케줄링 등을 위해 스레드를 여러 개 더 만든다.
단일 스레드는 한 번에 하나의 작업만 수행할 수 있다. 하나의 작업이 수행할 때 다른 작업을 동시에 수행하지 못한다는 것이다.(p31)
특히 I/O 작업 중에는 CPU가 놀면서 대기시간이 생긴다.
이 문제는 멀티 스레드 프로그래밍으로 해결할 수 있다.
멀티 스레드 프로그래밍은 스레드를 여러 개 사용해 작업을 수행하는 프로그래밍 기법이다. 프로세스는 이 기법으로 여러 개의 스레드에서 작업을 실행한다.
각각의 스레드가 한 번에 하나의 작업을 처리할 수 있으므로 여러 작업을 동시에 처리하는 것이 가능해진다. (p33)
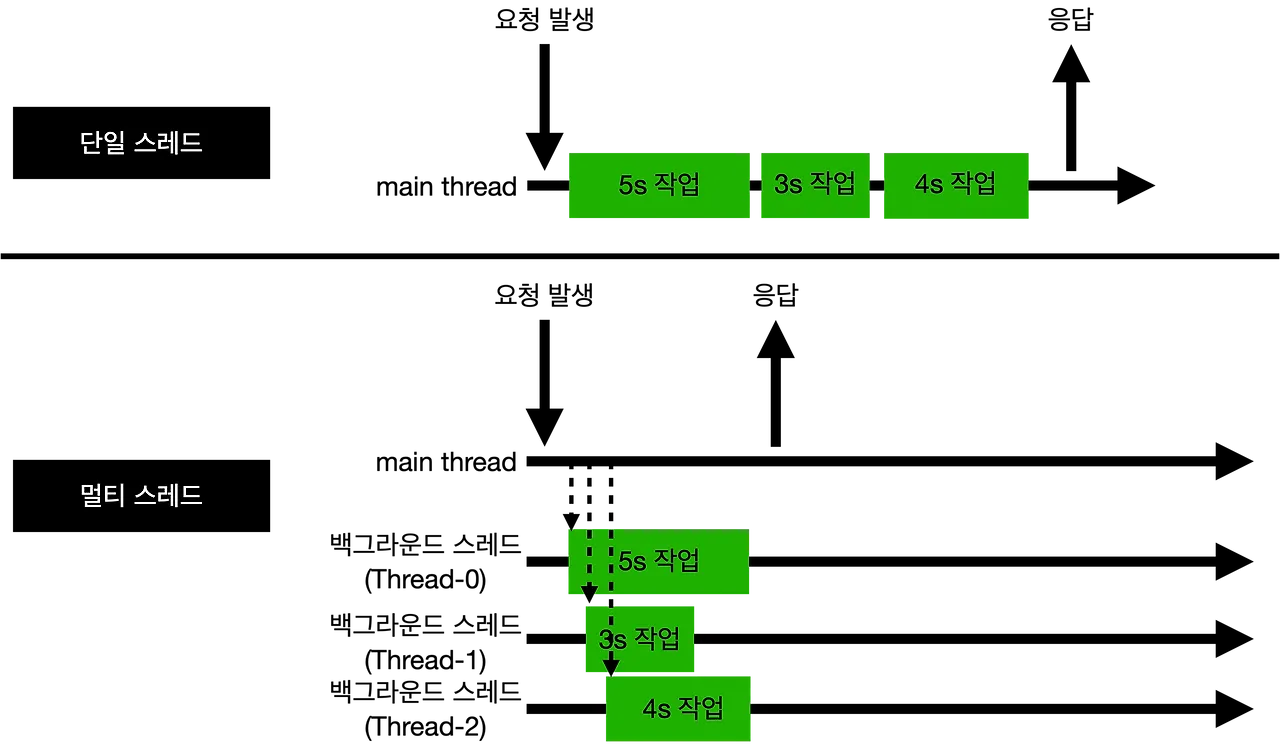
위처럼 작업 간에 독립성이 있을 때만 멀티 스레드에서 병렬로 실행이 가능하다. (p35)
실제 서비스 코드에는 외부 API호출, DB, Redis, Kafka 등등등.. 대기 시간이 길 수 있는 작업이 꽤 있다.
단일 스레드 구조라면 I/O가 끝날 때까지 CPU가 놀기 때문에 TPS가 크게 떨어진다.
그래서 웹 서버, Batch 시스템, 메시지 Consumer 같은 것들은 모두 멀티스레드를 기본값으로 운영한다.
그렇다고 스레드를 무작정 늘리는 건 좋은 해법이 아니다. 스레드마다 스택 메모리(1MB 내외)가 할당되니 수천개만 만들어도 기가바이트급 메모리를 차지한다.
자바, 코틀린에서는 Thread 클래스로 새 스레드를 만들어 작업을 실행할 수 있다. 간편해 보이지만 생성 비용이 비싸다는 문제가 있고 스레드 생성과 관리의 책임이 개발자에게 있어서 실수로 인한 오류나 메모리 누수가 생길 가능성도 있다.
이 문제를 해결하려면 한 번 생성한 스레드를 간편하게 재사용할 수 있어야 하는데
이런 역할을 위해 Executor Framework가 만들어졌다.
Executor Framework
Executor Framework는 스레드의 재사용성을 높이려고 등장했고 스레드를 관리하려고 여기서 스레드풀(Thread Pool)이라는 개념이 나왔다.
작업 처리를 위해 스레드를 미리 생성해 놓고 작업요청이 들어오면 쉬고 있는 스레드에 작업을 분배한다는 것이다. (p43)
동작은 아래와 같다.
- 서버 시작 시 지정된 개수의 스레드를 미리 만들어둠.
- 새로운 작업이 들어오면 대기 큐(BlockingQueue)에 적재함
- 여유 스레드가 생기면 큐에서 작업을 가져와 실행
- 작업 완료 후 스레드는 종료되지 않고 다시 풀로 반환
즉, 스레드풀은 스레드의 생명 주기를 재사용해 성능을 최적화하는 방식이다.
스프링 프레임워크는 Executor Framework를 기반으로 여러 내부 비동기 작업을 처리한다.
대표적으로 자바/코틀린 개발자라면 모를 수 없는 @Async 메서드는 SimpleAsyncTaskExecutor와 ThreadPoolTaskExecutor를 사용하고
스케줄러 작업에 쓰이는 @Scheduled 스케줄러는 ScheduledExecutorService를 사용한다.
이 Executor들은 내부적으로 TaskExecutor( = Executor Framework의 추상화) 를 사용해 스레드를 재사용하고 풀 사이즈는 application.yml에서 쉽게 설정할 수 있다.
그 밖에 내부적으로 트랜잭션 롤백이나 이벤트 발행을 맡는 ApplicationEventPublisher 에서도 별도의 Executor를 활용하곤 한다.
이런 Executor Framework에도 한계가 있는데 바로 스레드 블로킹이다.
스레드 블로킹은 스레드가 아무 것도 하지 못하고 사용될 수 없는 상태에 있는 것을 뜻한다. 스레드는 비싼 자원이라 이 상황이 반복되면 어플리케이션의 성능이 급격히 떨어지게 된다.
동기화 블록에 여러 스레드가 접근하거나, 뮤텍스나 세마포어에 의해서 스레드가 제한되는 경우에도 발생할 수 있다. (p49)
이처럼 기존의 멀티 스레드 프로그래밍은 스레드 기반으로 작업한다는 한계가 있다.
스레드는 생성 비용과 작업을 전환하는 비용이 비싸고 스레드 블로킹이 생기면 스레드라는 비싼 자원을 쓸 수 없게 되니 성능에 매우 치명적인 영향을 준다.
스레드 블로킹은 스레드 기반 작업을 하는 멀티 스레드 프로그래밍에서 피할 수 없는 문제이다.
실제로 어플리케이션은 작업 간의 종속성이 매우 복잡하고 네트워크 작업을 수없이 실행하므로 스레드 블로킹이 발생하는 것은 필연적이다. (p53)
코루틴이 스레드 블로킹 문제를 극복하는 방법
코루틴은 경량 스레드라고 불리며 작업 단위 코루틴으로 스레드 블로킹을 해결한다.
작업 단위 코루틴이란 스레드에서 작업 실행 도중 일시 중단할 수 있는 작업 단위이다.
작업이 일시 중단되면 다른 작업에게 스레드의 사용 권한을 양보하며 양보된 스레드는 다른 작업을 실행하는 데 사용할 수 있다.
일시 중단된 코루틴은 재개 시점에 다시 스레드에 할당되어 실행된다. (p55)
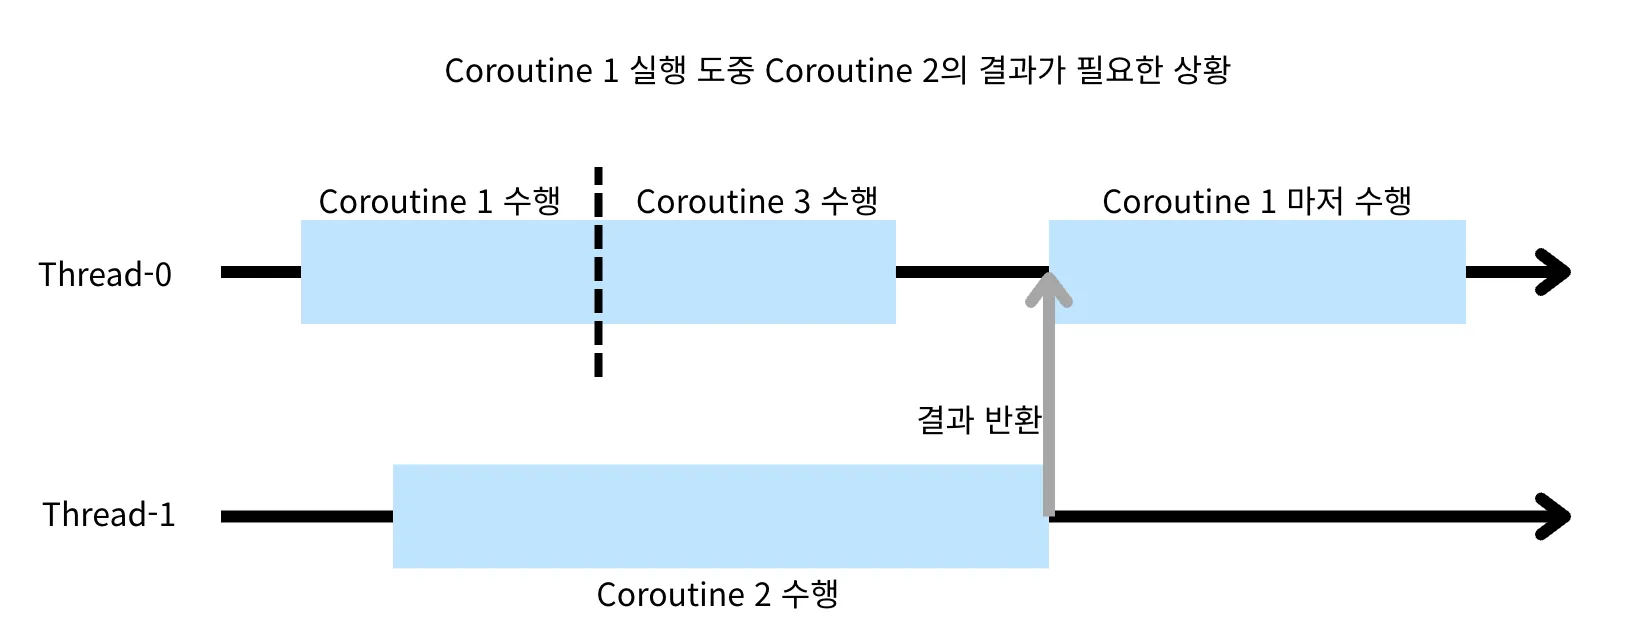
코루틴은 스레드를 쓰지 않을 때 스레드 사용 권한을 반납하고 그러면 그 스레드에서 다른 코루틴이 실행될 수 있다.
위 그림처럼 코루틴1 실행 도중 코루틴2의 결과가 필요하다면 코루틴1은 코루틴2의 결과가 반환될 때 까지 Thread-0 사용 권한을 반납하고 일시 중단한다. 이렇게 일시 중단되면 코루틴3이 Thread-0에서 작업할 수 있게 된다.
Spring에서도 spring-kotlin-coroutine 혹은 kotlinx.coroutines로 적용할 수 있다. 특히 webflux와 통합하면 "비동기 논블로킹"을 유지하면서 코드는 동기식처럼 짤 수 있다.
아래 NonBlocking/순차실행 코드를 한번 보자.
@GetMapping("/user")
suspend fun getUser(): UserResponse {
    val user = userService.findUser()
    val orders = orderService.findOrders(user.id)
    return UserResponse(user, orders)
}
기존의 CompletableFuture나 Mono/Flux 기반 코드보다 훨씬 가독성이 좋고 디버깅도 자연스럽다.
실무에서는 코루틴을 모든 곳에 도입하기보다 비동기 호출이 많고 I/O 대기 비율이 높은 구간에 골라서 도입하는 게 이상적이지 않을까 싶다.
댓글
댓글을 불러오는 중…